3.1 需求预测与误差监控
3.1 需求预测与误差监控
本节摘要:预测的价值不在"准",而在"误差可管理"。本节覆盖三件事:两种最常用的平滑类预测方法及其算例、预测误差的两级监控(MAPE 与追踪信号)、以及误差失控时的排查顺序。读完你能为一条稳定产品线搭起一套最小可行的预测流程,并知道它什么时候会失灵。
本章从链条第一环开始。承接章首的话:计划是在不确定性下做承诺,预测就是给这个承诺提供基准数字。先把丑话说完——任何方法都预测不准,本节教的全部内容可以概括为一句话:选一个不会系统性跑偏的方法,然后盯住它的误差。
一、预测的分层:先选战场再选武器
动手之前先分清预测对象。按时间跨度分:长期(一至五年,管产能与选址,靠趋势与产品线规划)、中期(三至十八个月,管计划与预算,靠时间序列加季节性)、短期(周与天,管排产与调拨,短期内需求结构相对稳定)。按需求性质分:独立需求(由市场决定,如整车销量,需要预测)与相关需求(由独立需求派生,如整车的轮胎数量,靠计算不靠预测)——这条区分是 3.3 节 MRP 的理论地基,这里先立住。
本节聚焦中期与短期的独立需求。方法上有两大流派:定量法吃历史数据,定性法吃市场判断(销售汇总、客户访谈、德尔菲轮询)。成熟企业的做法是定量打底、定性修正,且修正必须有记录——"销售说下月有大促"要变成可追溯的调整量,否则预测就成了各方博弈的 outputs,而不是分析的结论。
二、两种平滑方法:朴素却耐用
移动平均:取最近 n 期的均值当下期预测。n 越大越平稳、越迟钝;越小越敏感、越容易被噪声带偏。指数平滑:新预测=旧预测 + α ×(上期实际 − 旧预测),α 在 0 与 1 之间,本质是给"上一期预测错多少"加权修正,权重随数据变旧按 α 的幂次衰减。它比移动平均省数据、可调灵敏度,是多数计划系统的默认引擎。
一道双方法对照算例。某电动工具月销量近五期依次为:420、455、440、470、460 台。移动平均(n=3):(440+470+460) ÷ 3=457 台。指数平滑(α=0.3,上月预测 445):445 + 0.3 ×(460 − 445)=449.5 台。两个数字都在合理带内,差别在性格:若下一期真实需求跳到 520,移动平均要等两三期才追上,指数平滑在 α=0.3 下也要缓慢爬升;若把 α 调到 0.6,则 445 + 0.6 × 15=454,追得更快,代价是平时更容易被随机波动晃动。季节性明显的品类(羽绒服、空调)要在平滑之上叠季节指数:先用各月历史均值算出季节系数,把平滑结果乘回系数——方法不复杂,数据至少要两个完整年度周期。
指数平滑演算(α=0.3) 期 实际 旧预测 误差 新预测 1 420 430 -10 427 2 455 427 +28 435.4 3 440 435.4 +4.6 436.8 4 470 436.8 +33.2 446.8 5 460 446.8 +13.2 450.7 第6期预测 = 450.7 台 观察:预测始终滞后于趋势,α 偏小时尤甚——趋势品要用带趋势修正的模型
方法怎么选?给一个实用判据:需求平稳(无趋势无季节)用低 α 指数平滑;有趋势用 Holt 双参数;有季节用 Holt-Winters 或季节指数法;数据极少的品目,朴素法(上期实际当预测)反而最诚实。别小看朴素法——它是对抗"过度建模"的清醒剂,任何复杂模型在试点上都该先跟它比一比。
三、误差监控:MAPE 看大小,追踪信号看方向
预测没有误差监控等于裸奔。两级监控各司其职。
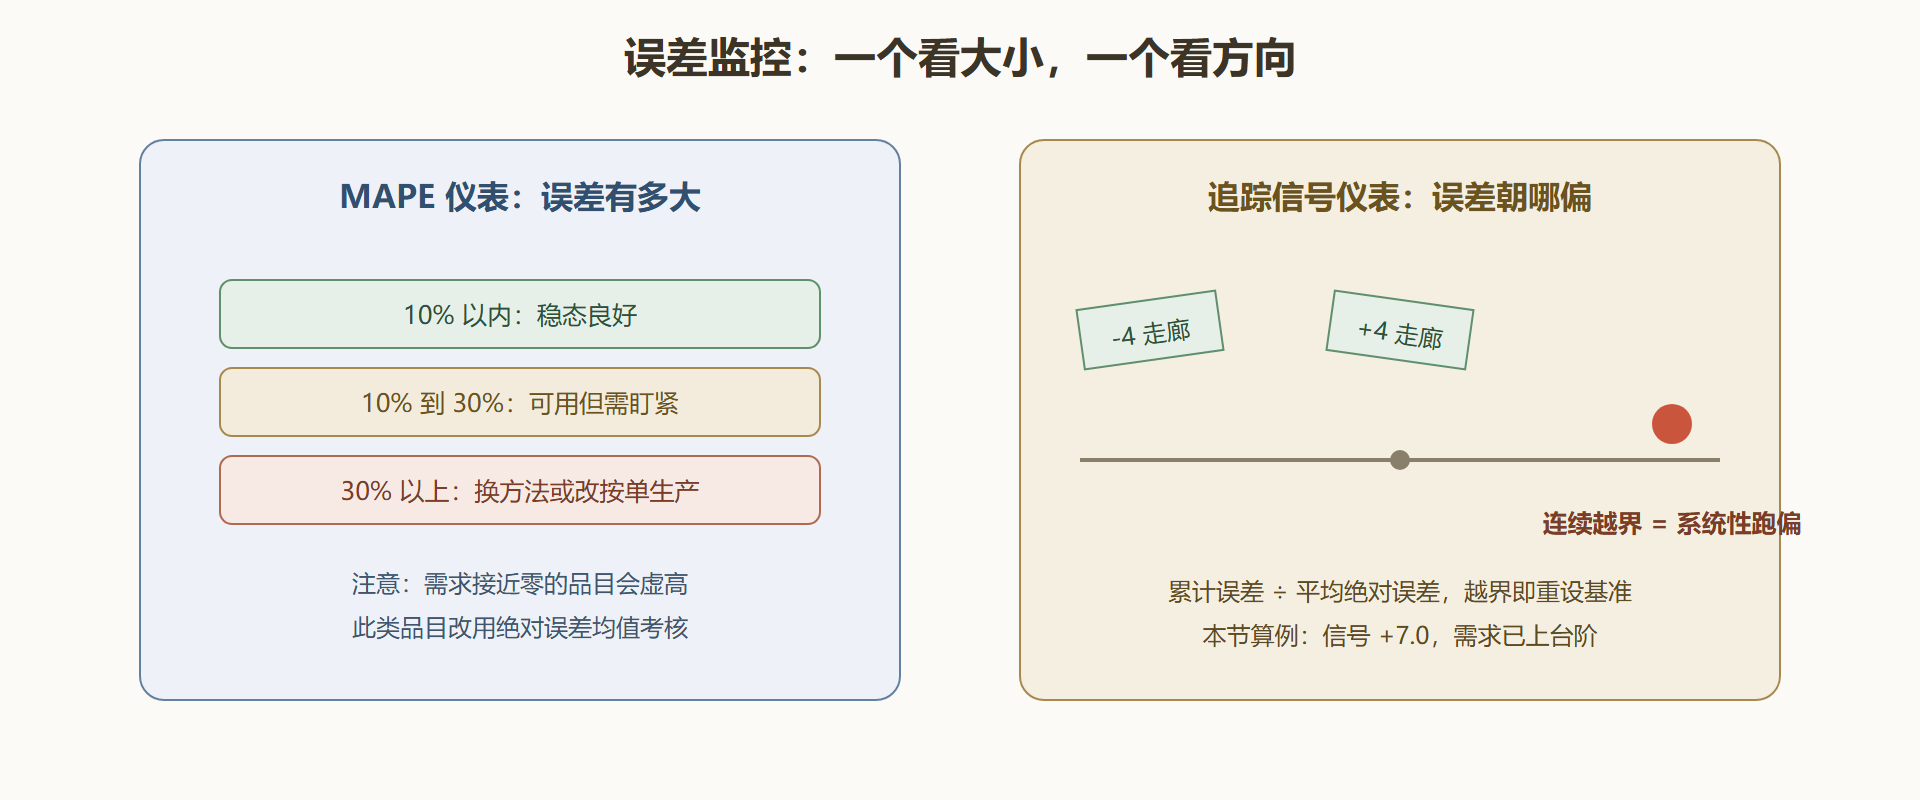
MAPE(平均绝对百分比误差)衡量误差的平均幅度:各期绝对百分比误差的均值。它的好处是与量纲无关,跨品类可比;坏处是需求接近零的品目会把 MAPE 撑爆,此类品目改用绝对误差均值。经验带:稳态品 MAPE 一成以内算好,两成以内可用,超过三成要检讨方法或干脆降级管理(如改按订单生产)。
追踪信号衡量误差的方向性偏移:累计代数误差除以平均绝对误差,正常波动下应在 ±4 左右的走廊内。一旦连续越界,说明预测在系统性跑偏——不是运气差,是模型或市场变了。这是比 MAPE 更重要的报警器,因为它捕捉的是"偏"而不是"大"。
误差监控表(近8期,单位:台) 期次 实际 预测 误差 绝对误差 绝对百分比误差 1 462 451 +11 11 2.4% 2 438 457 -19 19 4.3% 3 471 452 +19 19 4.0% 4 449 466 -17 17 3.8% 5 483 455 +28 28 5.8% 6 512 469 +43 43 8.4% 7 540 495 +45 45 8.3% 8 562 519 +43 43 7.7% MAPE = (2.4+4.3+4.0+3.8+5.8+8.4+8.3+7.7)/8 ≈ 5.6% 追踪信号 = 累计误差196 ÷ 平均绝对误差28.1 ≈ +7.0 → 越过+4警戒线 判读:MAPE不大但信号越界 = 需求已上台阶,模型系统性低估,立即重设基准
图 3-1 预测误差监控的双仪表:MAPE 与追踪信号
四、误差失控排查:按顺序问四个问题
追踪信号越界之后干什么?按固定顺序排查,别上来就调 α。第一问:数据有没有问题——促销未录入、退货重复计算、新包装折算错误,一半以上的"预测失灵"是数据账没对齐。第二问:市场是否结构变了——竞品上市、渠道切换、大客户增减单,此时不是调参数,而是换基准期、做事件修正。第三问:模型形态是否匹配——趋势品用平稳模型、季节品没叠系数,属于选型错误,换模型而不是调参。第四问:才轮到调参数——α 与 n 的重估。这个顺序能防止最常见的闹剧:用调参数去弥补数据错误,越调越偏。
五、完整案例:小家电品牌的预测月会
背景:某小家电品牌月度预测偏差大,销售与供应链长期互相指责:销售说计划保守压货,供应链说销售虚报冲量。月会上两拨人各拿一套数,鸡同鸭讲。
操作:计划主管做了三件事。第一,统一口径:预测对象锁定为"标准箱量、按发货周分解",销售侧的"销量"与供应链侧的"出货量"分开成两条曲线,不再混讲。第二,按品类分层管理:成熟电水壶品类交给指数平滑+季节指数,追踪信号设 ±4 走廊;新品破壁机数据不足,改用销售 consensus 加权并标注置信度;长尾配件直接朴素法,不再浪费会议时间。第三,把月会流程改成"先看误差仪表、再谈修正":会前十分钟人手一张追踪信号红黄榜,越界的品类先回答四问排查,再允许销售提修正,所有修正记录在案,次月复盘兑现率。
结果:三个月后成熟品类 MAPE 从 18% 降到 9%,追踪信号越界从每月七项降到两项;更重要的是会议性质变了——从互相指责变成对仪表负责。销售的真实大单信息被要求"提前量+置信度"双标注,兑现率高的销售其修正权重自动上调。
解读:本案例没有引入任何高深模型,收益全部来自三件朴素的事:口径统一、分层管理、误差可见。预测体系建设的次序应当是先治理后算法——倒过来做,再好的算法也会死在脏数据和博弈流程上。
变式:B2B 设备行业可把预测下沉一层:与大客户签滚动九十天需求可视协议,客户的备货计划直接进预测池,预测误差立刻从"猜"变成"对表"。
六、易错点与自查
其一,只考准确性不考方向性:MAPE 达标而追踪信号越界,是最危险的组合——偏差被平均掉了。其二,用预测精度考核销售:预测是计划职能的产出,销售提供的是市场情报与修正意见,责任错位会让修正从此失真。其三,模型越换越勤:追踪信号越界先走四问排查,多数时候问题在数据与结构,不在模型。其四,忽略预测的滞后天性:平滑类方法天然追着趋势跑,趋势明确的品类必须用带趋势项的模型。
本节要点回顾
- 预测的目标是误差可管理,不是把数字猜准。
- 独立需求靠预测,相关需求靠计算:这条分界是 MRP 的地基。
- 方法按需选:平稳品低 α 平滑、趋势品加趋势项、季节品叠系数、长尾品朴素法。
- MAPE 看大小、追踪信号看方向:信号越界先查数据、再查结构、再换模型、最后调参数。
- 先治理后算法:口径、分层、误差可见,比选模型更决定成败。
预测给了需求基准,下一节回答缓冲问题:面对残余的不确定性,库存该怎么设岗、参数怎么算。