第二章 研发流水线:从数据到一次完整的双均线复盘
第二章 · 研发流水线:从数据到一次完整的双均线复盘
章节摘要:本章跟着一个策略想法走完它的全部关卡:数据工程把原始行情变成可信的研究原料,策略构建与回测把想法变成可运行的规则并给出第一份成绩单,参数优化与验证决定这份成绩单是否经得起换参数、换时段的拷问。最后,全章用一个双均线策略的完整复盘收束——它将当场演示一条"漂亮净值"如何在严格的验证面前土崩瓦解。
一条主线
主线的起点是一句酒桌上的话:"双均线金叉买、死叉卖,我朋友靠这个赚了不少。"这句话在 quant 的世界里不算命题,只能算假设。本章的全部内容,就是把这句话送进流水线,看它能在哪一道关卡存活。你会看到数据工程师如何为它准备干净的对齐数据,回测框架如何把它的每笔交易从头到尾重演一遍,参数扫描如何在几百组快慢线组合里翻出那组"完美参数"——以及最后,滚动样本外验证如何像验钞机一样,把这张漂亮的净值钞票验出水印破绽。主线的终点不是"双均线没用"这种轻率结论,而是一套判断流程:什么样的证据足以让一个假设继续存活,什么样的证据必须让它出局。
沿途站点
2.1 数据工程。流水线的第一站,也是最不性感、最容易翻车的一站。复权与除权处理、缺失值与异常值、时间对齐、幸存者偏差——每一项处理不当,都会让后面的回测建立在流沙上。这一节还会给出数据质量的检查清单:宁可 research 慢一点,也不要在脏数据上跑出"结论"。
2.2 策略构建与回测。第二站把假设翻译成状态机:入场条件、持仓规则、退出逻辑、仓位规则缺一不可。回测框架的三条铁律——数据只读、时点对齐、成本入账——在此立为军规。向前看偏差与幸存者偏差这两类最常见的致命伤,会在这一节被点名示众。
2.3 参数优化与验证。第三站直面量化研究最危险的诱惑:参数扫描。为什么最优参数往往是过拟合的纪念品?参数高原与参数尖峰如何区分?滚动前推验证为什么是样本外检验的主力手段?这一节给出的是方法论,而它的现场演示留给下一站。
2.4 双均线策略回测全程复盘。主线的案发现场。从写下第一版回测代码,到发现收益集中在极少数交易日、参数曲面尖如针峰、滚动验证全线溃败,再到最终区分"策略真的无效"与"我的验证流程有漏洞"——一次完整的证伪实操,含全部教训清单。
拐点与结论
本章最重要的认知转折出现在参数优化一节:多数人以为优化的目标是"找到最好的参数",其实优化的真正产出是"参数稳定性的证据"。参数曲面是宽缓的高原,说明策略逻辑在一片邻域内成立,参数只是工程实现的选择;参数曲面是尖锐的针峰,说明你拟合的是这段历史的噪音。把"找最优"换成"验稳定",是研究者的成人礼。
结论落在一句流程纪律上:回测不是证明,是筛选。回测通过的假设只获得了"继续观察"的资格,真正的判决要等成本、执行与风控全部入账之后——那是第四章的剧情。
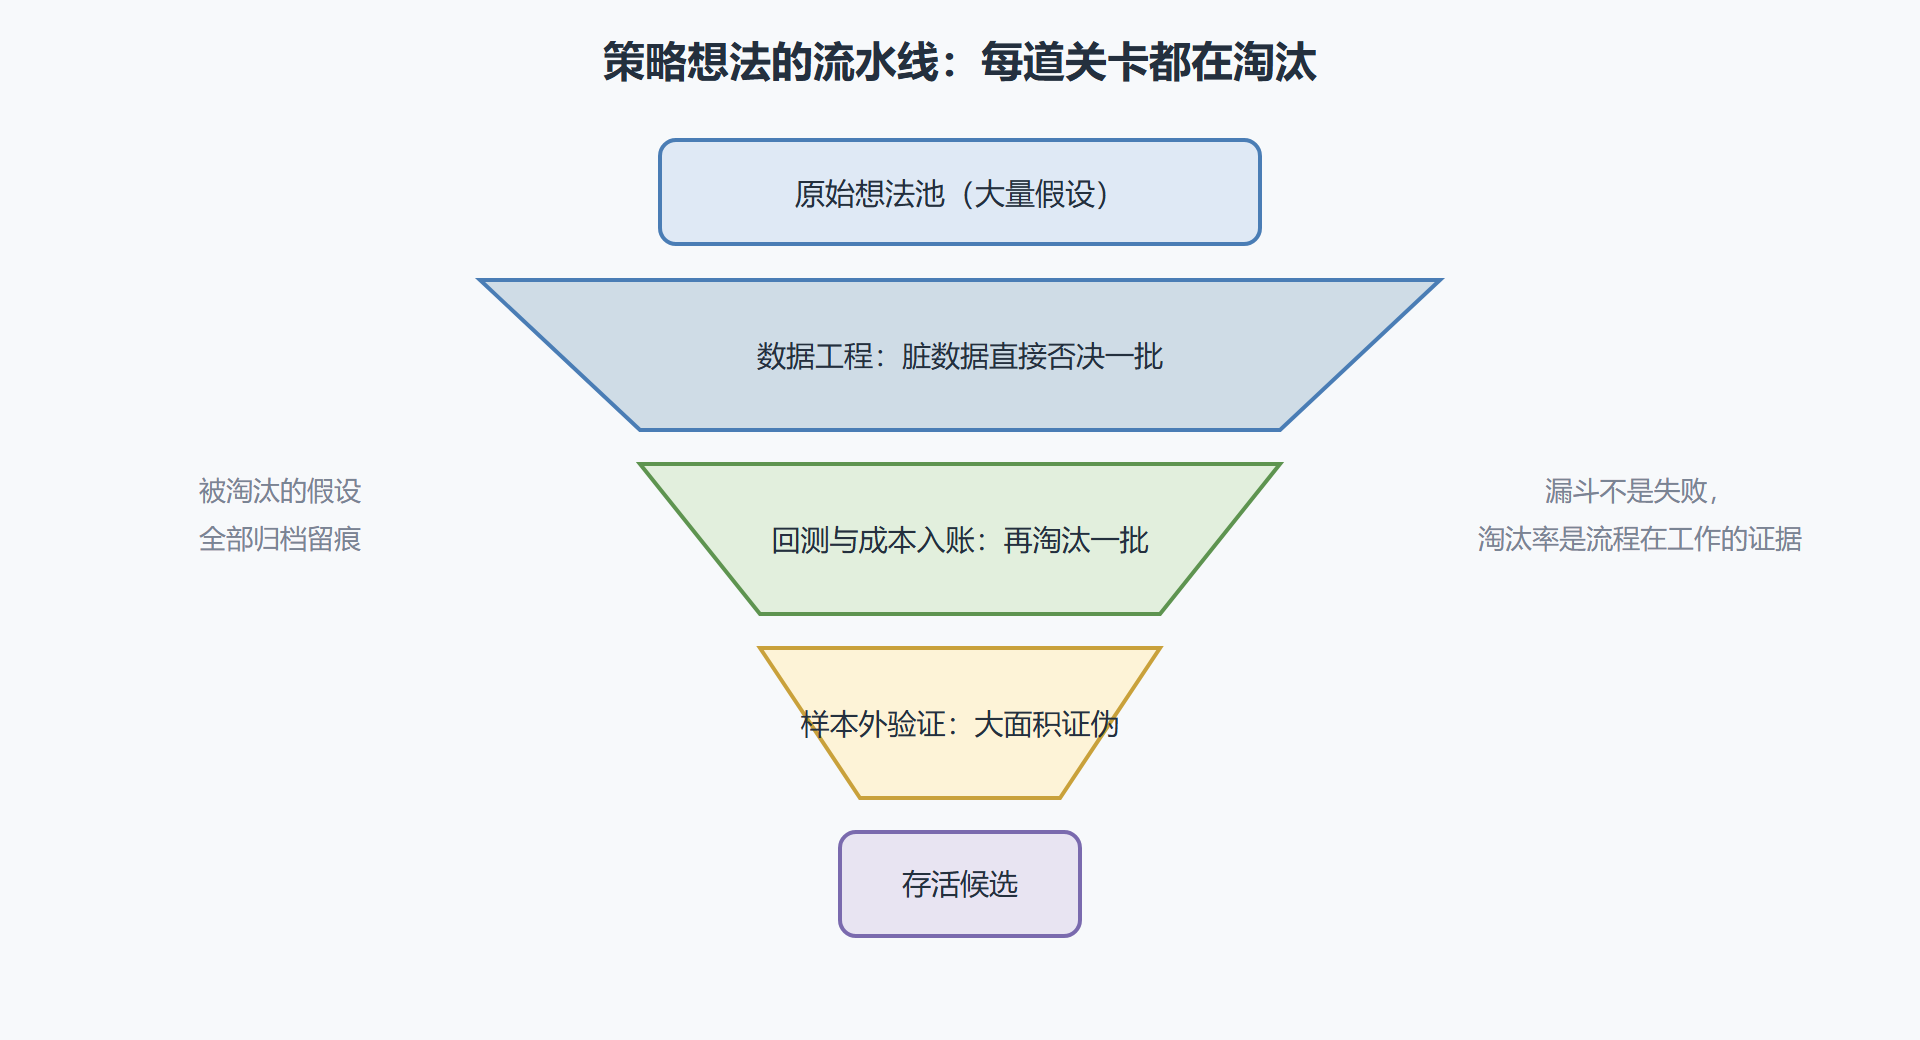
流水线的关卡与产出对应用下图概括:
图 2-1:研发流水线的漏斗结构与损耗
读完你应该
- 能列出一个数据管道的质量检查清单,并说出幸存者偏差在回测里的具体表现形态;
- 能把一段口语化的策略描述翻译成带状态转移的完整规则(入场、持仓、退出、仓位四件套);
- 能解释向前看偏差的产生机制,并给出至少两种工程预防手段;
- 能区分参数高原与参数尖峰,并用滚动前推验证产出样本外证据;
- 能独立完成一次双均线级别的复盘,并写出证伪报告。
下一章的接力
流水线产出的是"存活候选"。它们是谁?从哪个族谱里来、依赖什么市场条件?第三章把四大策略门派放上同一张对照桌,让每个存活候选认祖归宗。