2.1 独立增量与计数过程:从到达流讲起
2.1 独立增量与计数过程:从到达流讲起
本节摘要:计数过程把"到时刻 t 为止共发生几件"作为状态,是描述到达流的最小框架。本节给出定义,逐条讨论独立增量、平稳增量与普通性三条假设的现实含义,讲清泊松分布作为二项极限的来历,并用代码画出阶梯形样本路径。
十九世纪末,普鲁士军队的骑兵部队里流传着一份奇怪的统计:每年被马蹄踢死的军官人数。普鲁士统计学家博尔特凯维奇把二十个骑兵军多年的记录摆在一起,发现各年死亡人数惊人地服从同一个分布——泊松分布。没有人计划这些事故,它们的发生机会常年稳定,且一处踩踏绝不影响另一处。这份记录后来成了随机过程最古老的现实标本之一:恒定机会下的偶然到达。本节的目标,就是把这句话翻译成严格的数学。
一、计数过程:只数不问
定义:设 N(t) 表示区间 0 到 t 内发生的事件数,若 N(t) 取非负整数值、关于 t 单调不减、且 N(0) = 0,则称 {N(t), t 大于等于 0} 为计数过程。
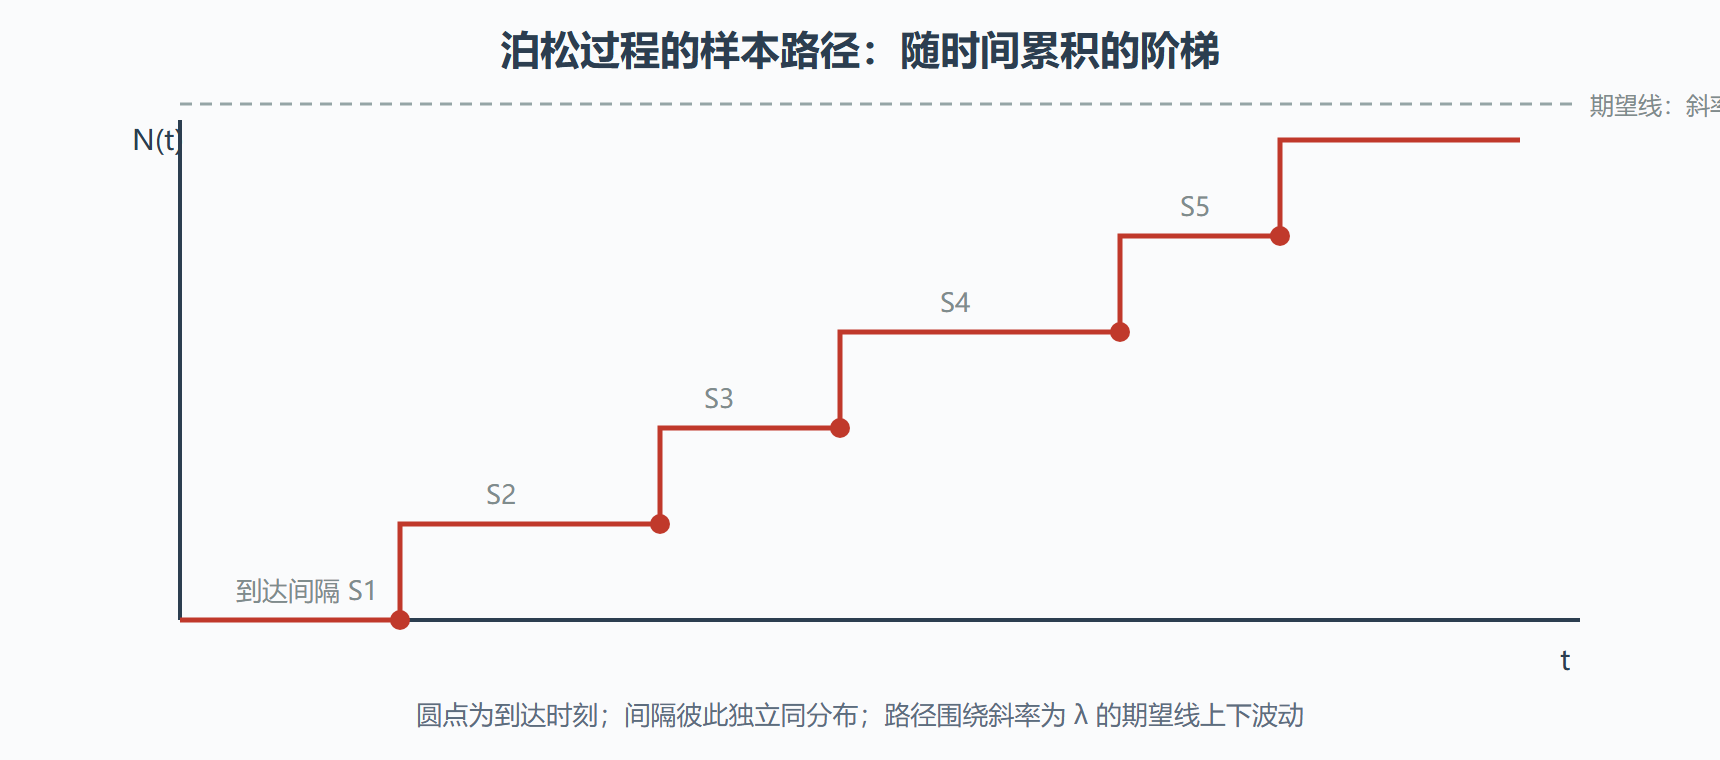
三个条件都对应着"数数"的物理常识:数量不为负、只增不减(事件不会凭空撤销)、起计数从零开始。样本路径画出来就是一条阶梯:平时水平,事件发生时跳一格。第 1.4 节说的"纵切视角"在这里立刻派上用场——每条实现都是一道楼梯,楼梯的疏密就是到达的节奏。
计数过程本身几乎不加任何限制,所以它是"容器"级别概念。真实到达流千差万别:地铁早高峰密集、深夜稀疏(机会随时间变);地震之后常有余震(到达有后效);公交车常两三辆结伴进站(一次跳多格)。要锁定泊松过程,需要三条假设把上述行为逐条排除。
二、三条假设逐一排雷
独立增量:不相交时间段内的事件数相互独立。它排除的是"后效"——余震型现象(一次事件改变后续发生机会)直接出局。地震序列、社交平台的转发爆发都不满足此条,硬套泊松模型会系统性低估聚集程度。金融里价格的大跳动之后波动升高(波动率聚集),同理不适合纯泊松。
平稳增量:任一时间段的事件数分布只取决于区间长度,与起点无关。它排除的是"机会随钟点漂移"——早晚高峰的呼入中心不满足此条。处理办法是分时段建模:把一天切成若干平稳区间,各配一个强度参数,工程上足够用。
普通性:同一瞬间至多一件(微小区间内事件多于一件的概率趋于零)。它排除"结伴到达"。公交结伴进站是标准反例——把一辆公交当一次到达没问题,但把车上每位乘客当独立到达就违普通性。还有一类隐蔽违反:系统里各部件共享同一个诱因(停电让所有设备同时报警),表面是各自到达,实为一次跳多格。
三条假设的现实判据可以列成一张自查表:
| 假设 | 违反时的典型症状 | 常见补救 |
|---|---|---|
| 独立增量 | 事件聚堆、余波明显 | 换自激励过程(第 6 章) |
| 平稳增量 | 到达率随钟点、季节漂移 | 分时段分别建模 |
| 普通性 | 事件成批同刻发生 | 把一批重新定义为一个事件 |
图:泊松过程的阶梯形样本路径
三、泊松分布的来历:小概率大数量的极限
泊松分布不是拍脑袋规定的,它从二项分布的极限里自然长出来。把区间 0 到 t 切成 n 等份,每段长度 t/n。在平稳增量为小概率 p 的假设下,每段至多一件、各段独立,总事件数服从二项分布 B(n, p)。令 n 趋于无穷、p 正比于段长(np 趋于常数 λt),用极限
(1 − λt/n) 的 n 次方趋于 e 的 −λt 次方
可得总事件数收敛到泊松分布 P(N(t) = k) = (λt) 的 k 次方乘 e 的 −λt 次方再除以 k 的阶乘。这个推导解释了泊松分布为何统治"稀有事件总计数":电话呼入之于海量潜在来电者、错别字之于整页文稿、突变之于庞大基因组——都是"许多独立小机会,各自零星兑现"。期望与方差都等于 λt,一个参数同时定住位置与散布,这正是"恒定机会"的数学缩影。
顺带一提推导中隐含的换算:单位时间强度 λ 的量纲是"件每单位时间",建模前先把观测窗口归一到一致单位,是实操里最容易翻车的一步——把"每小时五件"与"每分钟五件"混写进同一个 λ,后续所有概率都会差六十倍。
四、动手:生成并检查一条到达流
import numpy as np rng = np.random.default_rng(2024) lam = 3.0 # 强度:每小时 3 件 T = 10.0 # 观察窗口:10 小时 # 方法一:指数间隔串联(2.3 节将证明其正确性) gaps = rng.exponential(scale=1/lam, size=800) arrivals = np.cumsum(gaps) arrivals = arrivals[arrivals <= T] counts_by_hour = np.histogram(arrivals, bins=range(11))[0] print(f"总到达数 N(T) = {len(arrivals)}(理论期望 λT = {lam*T:.0f})") print(f"各小时到达数 = {counts_by_hour.tolist()}") # 大规模重复可验证:每小时的计数服从均值为 3 的泊松分布, # 方差也约等于 3(泊松分布"均值方差相等"的快速自检) reps = np.random.default_rng(1).poisson(lam, size=200_000) print(f"泊松自检:均值 {reps.mean():.3f},方差 {reps.var():.3f}") # 典型输出:均值 2.998,方差 2.994 ——两者贴近,数据形态合格
把 lam 改成随小时变化的数组再模拟,你会看到各小时计数不再同分布——这就是违反平稳增量的直观形态,也解释了为什么实践中"分时段各自配 λ"如此常见。
边界讨论:哪些"到达"不是泊松
把判据用在四个真实对象上,练习定位的手感:
地铁到站(按时刻表运行):间隔几乎恒定,变异系数远小于一——违反独立性背后的"偶然性"本身,用确定性时刻表加小扰动建模,泊松会严重高估聚集。
小型网站的点击流:单用户行为有爆发性,但用户量大、彼此独立时,粗粒度上的合计计数常近似泊松——这是"大数洗掉个体怪癖"的罕见红利,也是 A/B 测试里泊松近似的合法性来源。
单条社交话题的转发流:强自激励(转发招致转发),变异系数远大于一——泊松必错,正确工具是第 6 章的自激励过程。
放射性衰变:物理学教科书级的泊松流,各原子核衰变天然独立、机会恒定。历史上它正是泊松统计最干净的实验场,任何检测仪器都可以拿它做泊松性自检。
四个例子放在一起的启示:泊松性不是现象的属性,是现象在某个聚合尺度上的属性。同一份原始日志,按秒聚合是爆发流,按小时聚合可能就是干净的泊松——建模前先决定聚合尺度,往往比选模型更关键。
本节要点回顾
- 计数过程是到达流的最小容器:非负整数、单调不减、从零起计。
- 三条假设各管一件事:独立增量断后效,平稳增量断漂移,普通性断结伴。
- 泊松分布来自二项极限:稀有、独立、机会恒定的到达,总计数天然泊松。
- λ 的量纲要钉死:强度参数的单位混用是最常见的实操事故。
- 样本路径是阶梯:期望线斜率为 λt,路径围绕它波动。
同一台机器有三份不同的说明书。下一节把三种等价定义摆在一起,完成互推,看看"等价"二字落到实处是什么样子。