5.1 蒙特卡洛模拟完整复盘:一份实验报告的诞生
5.1 蒙特卡洛模拟完整复盘:一份实验报告的诞生
本节摘要:蒙特卡洛方法的本质是把期望变成平均、把概率变成频率——大数定律的工程化。本节以一个具体问题(估计带非线性漂移的随机微分方程解的期望)为靶子,完整走一遍五步实验流程:问题形式化、格式离散化、收敛验证、误差预算与方差缩减、敏感性分析。读完你应当能按此模板组织任何一次模拟实验,并识别别人实验报告里的漏洞。
想象你在给一座核电站的冷却系统做风险评审:故障率、温度路径、维修时延全都随机,解析公式连列都列不出来。此时唯一现实的路是把系统"在电脑里跑一万遍",统计坏结果的频率。这就是蒙特卡洛方法——名字来自那个赌场,致敬的正是"用大量随机抽样逼出确定答案"的思想。曼哈顿计划里冯·诺伊曼与乌拉姆用它研究中子输运,今天它是金融、物理、可靠性工程的通用车床。本节把它拆成五步标准动作。
第一步:问题形式化
模拟之前先回答两个问题。**要估计的量是什么?**写成期望的形式 E[g(X)],其中 X 是某个过程的(全部或部分)路径,g 是收益或指标函数。估计概率也没问题:P(A) = E[指示变量 1_A],概率就是 0-1 变量的期望。**精度的目标是多少?**事先声明"期望误差不超过 e,置信水平九成五"——没有精度声明的模拟实验等于没有验收标准。
本节靶子:估计 X(T) 的期望,其中 X 满足 dX = −θ(X − b)dt + σ dW(均值回归过程,利率与温度模型的标准形态),取参数 θ = 0.8、b = 5、σ = 0.6、T = 2。这个例子挑得刁:它有解析答案(X(T) 服从正态,均值可闭式写出),方便对账——做方法实验永远挑有解析答案的靶子,方法本身练熟了再去打无解的真目标。
第二步:离散化格式
计算机没有无穷小,要把连续方程切成小步。欧拉–丸山格式是最常用的离散化:
X(tₖ₊₁) = X(tₖ) + a(tₖ, Xₖ)·Δt + b(tₖ, Xₖ)·√Δt·Zₖ,Zₖ 为标准正态
即漂移走一步、波动按正态走一步。它的强弱收敛阶分别为一阶与二分之一阶——记不清阶数没关系,记住后果:误差大致与步长成正比(路径误差与 √步长),步长减半误差近似减半。米尔斯坦格式在波动项多乘一个 (b'·b/2)·(ΔW² − Δt) 修正,把路径误差阶提到一阶;波动系数恒定(如本例)时两者等价,波动随状态变化的模型(如几何布朗)才见差别。
⚠️ 离散化第一坑:格式稳定域。刚性系统(含快变量)用大步长的显式欧拉会数值爆炸——步长必须小于稳定域,或改用隐式格式。判断口诀:跑出的路径飞到天文数字,先查步长再查模型。
第三步:收敛验证
两道关卡必须过。第一关,自洽收敛:固定路径数,把步长折半再折半,估计值应当稳定(波动幅度按预期阶衰减)。若折半后估计值大幅挪动,说明步长还没进收敛区。第二关,外部对账:与解析解、已知文献值或另一条独立方法(比如更高阶格式)对照。两关全过,数值层才算合格。
第四步:误差预算与方差缩减
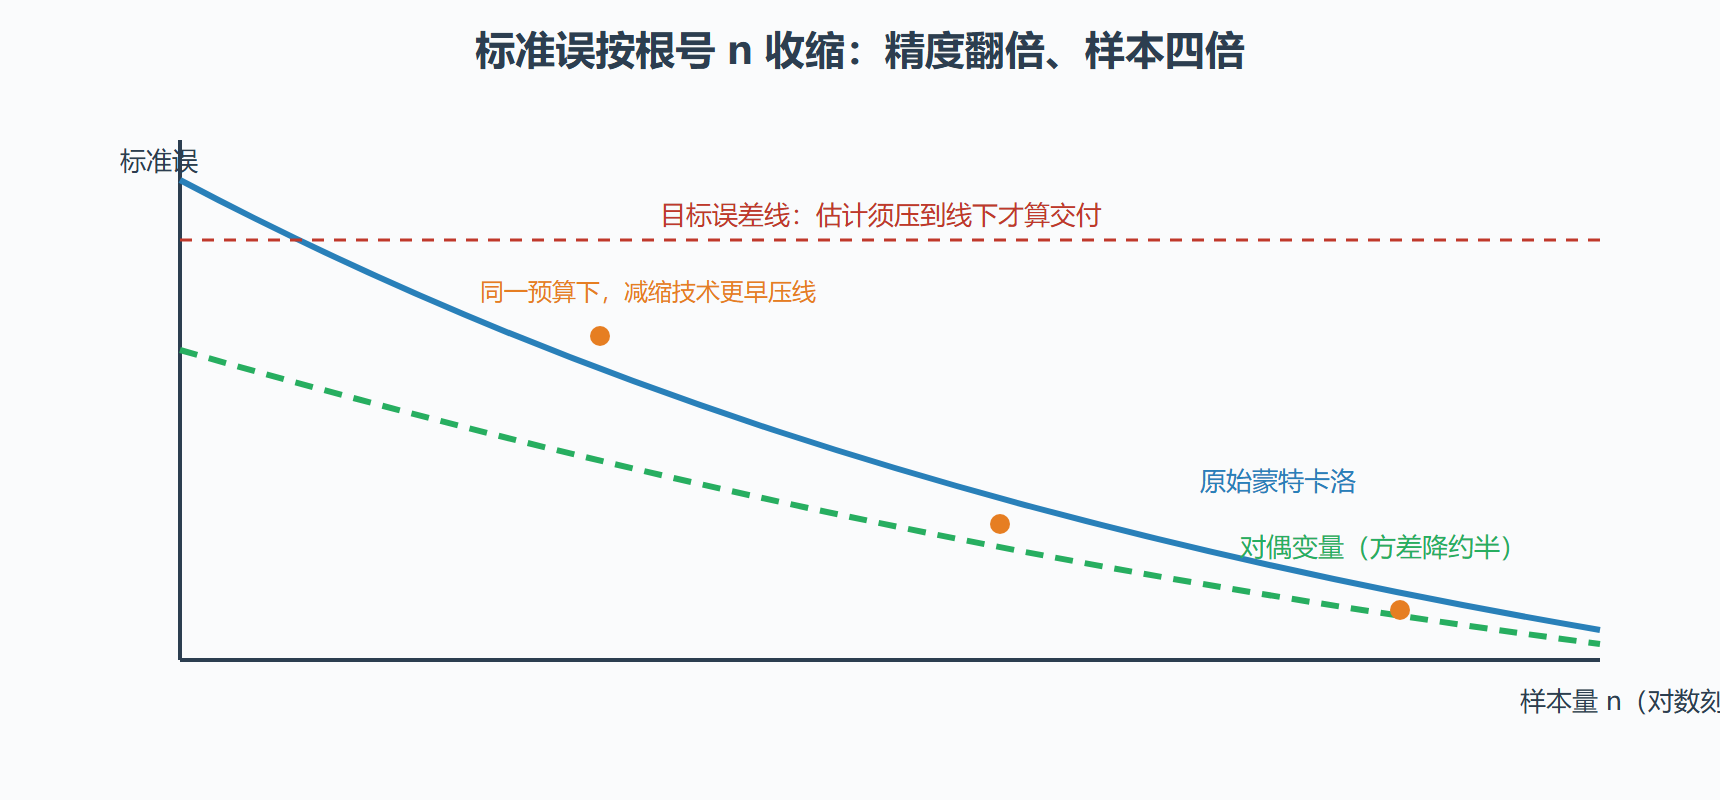
蒙特卡洛的统计误差由中心极限定理(3.5 节)包办:估计值近似正态,标准误为样本标准差除以 √n。由此得到预算公式——误差减半,样本翻四倍。设精度目标后倒推样本量,是实验设计的基本功:
n ≥ (z·样本标准差 / 目标误差)²,z 取 1.96 对应九成五置信
样本量动辄百万时,方差缩减技术开始赚钱。三件套按使用频率排列:对偶变量(同一随机数取正负各跑一遍取平均,单调收益函数下方差骤降);控制变量(找一条期望已知的相关量做锚,用其偏差修正估计);重要性抽样(改抽签分布让稀有事件多发生,再用权重修正——估计"小概率大损失"事件时的救命稻草)。三者的共同本质:用已知结构信息兑换随机开销。
图:蒙特卡洛误差随样本量的平方根收缩
第五步:敏感性分析
交付数字之前做最后一道体检:参数动一动,结论动多少。把关键参数(本例的 θ、σ,或精度目标)各挪动合理幅度重跑,记录输出的变化方向与幅度。目的有三:找出结果对哪个参数过敏(那才是值得花成本精确估计的参数);暴露脆弱结论(对参数轻微变动即翻盘的结论不该写进报告);为审阅者提供复算入口。缺敏感性分析的模拟报告,在严肃场合会被打回——它等于宣称"我的数字是孤证"。
完整复盘:五步流水线的参考实现
import numpy as np rng = np.random.default_rng(2026) theta, b, sigma, T = 0.8, 5.0, 0.6, 2.0 exact_mean = b + (0.0 - b) * np.exp(-theta * T) # 解析均值,供对账 print(f"解析均值 = {exact_mean:.5f}") def euler_estimate(n_paths, n_steps, antithetic=False): """欧拉-丸山模拟 X(T) 的均值;antithetic 开关启用对偶变量""" dt = T / n_steps Z = rng.normal(0.0, np.sqrt(dt), size=(n_paths, n_steps)) if antithetic: X = np.zeros((2*n_paths, n_steps+1)) for sign in (1.0, -1.0): Xs = np.zeros((n_paths, n_steps+1)) for k in range(n_steps): Xs[:, k+1] = (Xs[:, k] + theta*(b - Xs[:, k])*dt + sign*sigma*Z[:, k]) X[k*n_paths:(k+1)*n_paths] = Xs else: X = np.zeros((n_paths, n_steps+1)) for k in range(n_steps): X[:, k+1] = (X[:, k] + theta*(b - X[:, k])*dt + sigma*Z[:, k]) est = X[:, -1].mean() se = X[:, -1].std(ddof=1) / np.sqrt(X.shape[0]) return est, se # 第三步:自洽收敛(折半步长,估计值应稳定) for n_steps in (8, 16, 32, 64): est, _ = euler_estimate(20_000, n_steps) print(f"步数 {n_steps:>3}: 估计 {est:.5f}") # 第四步:误差预算与对偶变量对照 est, se = euler_estimate(200_000, 32) est_a, se_a = euler_estimate(100_000, 32, antithetic=True) print(f"原始: {est:.5f} ± {1.96*se:.5f}") print(f"对偶: {est_a:.5f} ± {1.96*se_a:.5f}") # 典型输出:解析 4.65699;折半步长时估计稳定到第三位小数; # 原始方案 95% 半宽约 0.012,对偶方案约 0.007——同一总计算量精度明显提高
解读与变式:复盘里三处细节最容易被省略,也最不能省。其一,随机种子要记录——实验可复现是底线。其二,对偶方案的总计算量与原始方案对齐(各跑一半路径)再比精度,否则是假节省。其三,变式:把 σ 放大到 2.0 重跑,你会发现步长 8 时估计开始漂——波动变大后离散化误差抬头,"步长够不够"必须结合参数回答,不能一劳永逸。
本节要点回顾
- 蒙特卡洛 = 大数定律的工程化:期望变平均、概率变频率。
- 五步流程:形式化(含精度声明)、离散化、双关验证(自洽加对账)、误差预算与方差缩减、敏感性分析。
- 误差按 1/√n 收缩:精度翻倍样本四倍;预算公式先算样本量再开机。
- 三件方差缩减工具:对偶、控制、重要性抽样,本质是用结构信息换随机开销。
- 格式有稳定域:路径爆炸先查步长;米尔斯坦在波动依赖状态时才显示优势。
- 没有敏感性分析的模拟报告是孤证,过不了严肃评审。
流水线验收完毕。下一站是最成熟的商业应用现场:用这套车床给期权定价、算风险,并与解析公式当场对账。