5.3 排队论与运筹优化:从 M/M/1 公式到容量决策
5.3 排队论与运筹优化:从 M/M/1 公式到容量决策
本节摘要:排队论把"到达流 + 服务机制 + 排队规则"组装成可计算的模型。本节推导 M/M/1 与 M/M/s 的核心指标(利用率、队长、等待时间),讲透 Little 定律的使用与误用,再用仿真处理指数假设失效的真实系统,最后以客服中心扩容决策的完整案例收尾——从公式到仿真到成本权衡的全程演练。
医院挂号窗口该开几个?客服中心夜班留几人?云端自动扩容阈值定多高?这些问题表面千差万别,数学骨架同一个:随机到达的任务排在随机时长的服务后面。排队论(丹麦工程师爱尔朗 1909 年为哥本哈根电话局所创,是随机过程的第一个工业应用)给出这套骨架的算法。它最迷人的地方在于一条反直觉铁律:利用率逼近一时,等待时间爆炸——系统越"饱和高效",用户越痛苦,且痛苦是非线性的。
M/M/1:一图流公式推导
记号 M/M/1 读作"指数到达、指数服务、单个服务台":到达是率 λ 的泊松流(第 2 章),服务时长是率 μ 的指数分布(第 2、3 章的老朋友),一名服务员。把"系统内人数"当状态,就是 3.4 节的生灭过程:λₙ = λ、μₙ = μ 恒定。全部指标从那个乘积形状的平稳分布 πₙ = (1 − ρ)ρⁿ 一路读出,ρ = λ/μ:
| 指标 | 公式 | 一句话读法 |
|---|---|---|
| 利用率 | ρ = λ/μ | 服务忙的时间占比,必须小于一 |
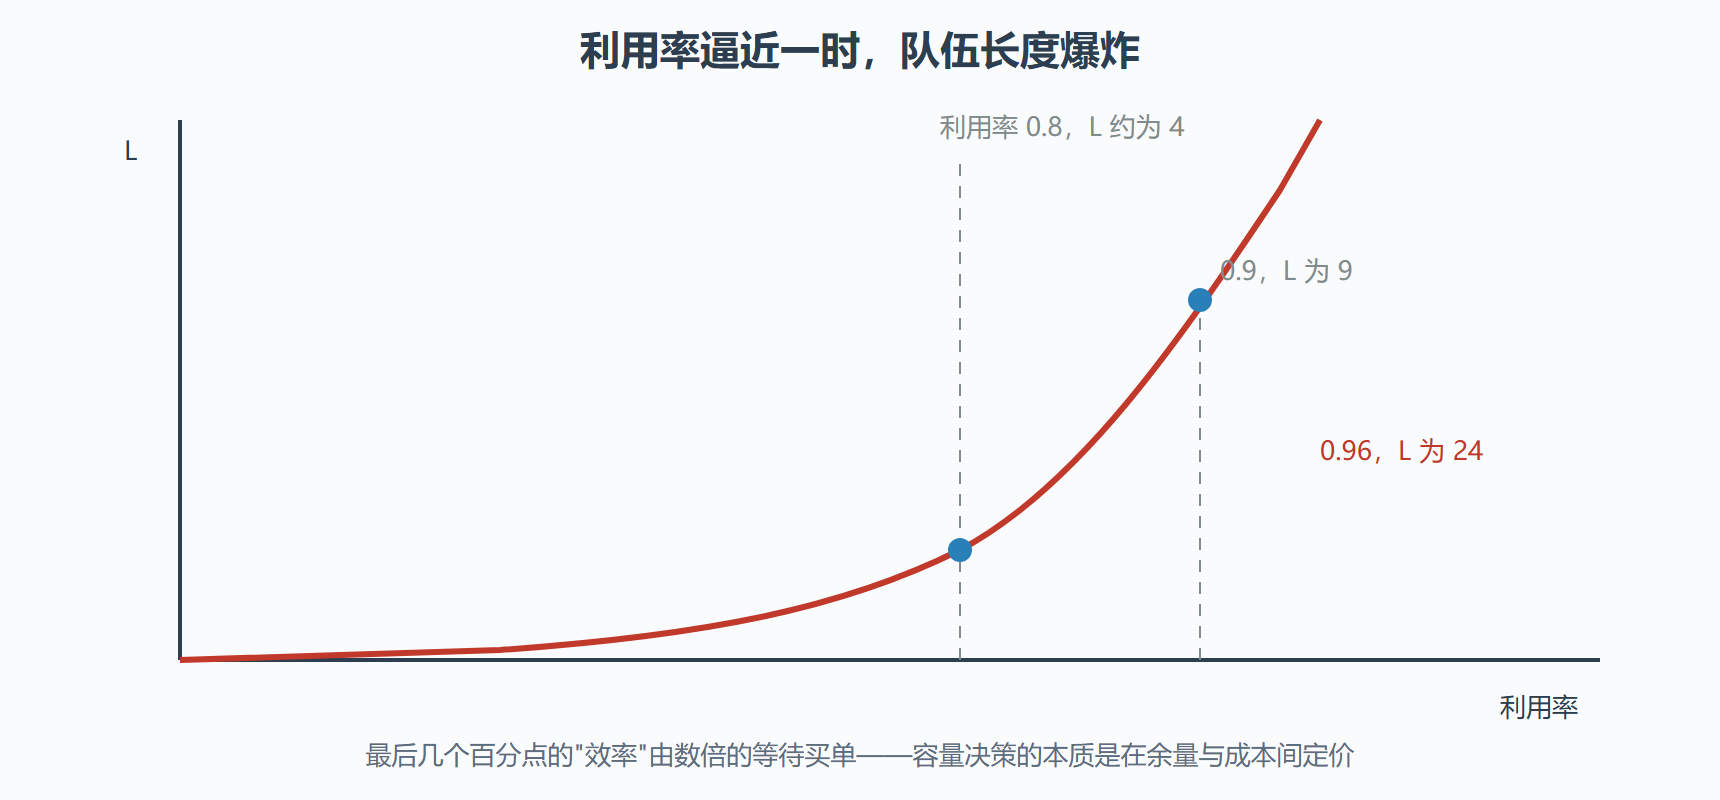
| 系统平均人数 L | ρ/(1 − ρ) | ρ = 0.8 时 L = 4;ρ = 0.96 时 L = 24 |
| 平均等待时间(含服务)W | 1/(μ − λ) | 分母是"净处理余量" |
| 排队人数(不含服务中)Lq | ρ²/(1 − ρ) | ρ = 0.8 时 3.2 人 |
重点钉住 W = 1/(μ − λ) 的形状:μ 与 λ 靠得越近,等待越长且无界。ρ 从 0.8 提到 0.9,L 从 4 涨到 9;从 0.9 提到 0.96,L 从 9 涨到 24——利用率最后几个百分点的"效率"是用数倍的等待买来的。管理者天然追求"员工别闲着",排队论给出的恰恰是反建议:留出余量,整体成本才最低。这不是管理哲学,是公式。
Little 定律:万能的会计恒等式
L = λ_effective·W:系统内平均人数 = 到达率 × 平均逗留时间。它几乎不设前提(只需系统稳定),因此应用面极广:餐厅里"店内平均人数 = 客流率 × 平均用餐时长",于是测得客流与时长就能推算桌位占用;DevOps 里"在制品数 = 吞吐 × 周期时间"是精益开发的核心等式,同一行字。
误用也集中在一点:把 L = λW 当预测工具逆推。有人测得低负载下的 W,代入未来更高的 λ 预测 W——但 W 本身随 λ 非线性增长,恒等式只在你已有两个量时告诉你第三个,不提供外推能力。它是对账单,不是水晶球。
超过公式的地方:仿真兜底
真实系统几乎从不老实满足 M/M/1:到达有早晚高峰(非平稳)、服务时长偏厚尾(变异系数大于一,见 3.4 节变式)、顾客会不耐烦离开(弃号)、多服务台共享一条队(M/M/s 才勉强贴合)。此时闭式公式让位,事件驱动的仿真顶上——5.1 节的流水线原样适用,事件驱动替代时间步进。
图:M/M/1 系统平均人数随利用率的非线性爆炸
全流程案例:客服中心的夜班扩容
背景:某电商客服中心,深夜时段来电率 λ = 18 通每小时,单通处理均值 3 分钟(μ = 20 每小时),KPI 要求"平均等待不超过 2 分钟、等待超 5 分钟的来电占比不超过 5%"。当前夜班一人,是否加人?
第一步,闭式估算。单人 M/M/1:ρ = 0.9,平均等待(仅排队)Wq = ρ/(μ − λ) = 9 分钟——远超 KPI,一人不行。双人 M/M/2:利用率降为 0.45,公式给出平均排队等待约 0.35 分钟、超 5 分钟占比不足 1%——两人达标且有富余。
第二步,仿真修正。真实处理时长变异系数 1.4(有快速咨询也有纠缠半小时的投诉),指数假设偏乐观;到达也有波动。事件驱动仿真十万个夜间时段:两人配置下平均等待 0.6 分钟、超时占比 1.8%——仍达标,但富余比公式宣称的薄了一半。公式给量级,仿真给承诺:对客承诺必须按仿真数字定。
第三步,成本权衡。每名夜班坐席的班次成本约合每月两万元;超时 KPI 每超标一个百分点折算商誉与流失成本约每月八千元。单人配置 KPI 失败(超时占比约两成),月隐性成本约 1.6 万,且投诉升级风险另计;双人配置达标,总成本 2 万。结论:加人。
第四步,变式与加固。仿真显示 21 点到 23 点存在呼入尖峰,双人配置在尖峰两小时内超时占比升至 6%。不必全员加码——错峰排班(把一名坐席的班次后移两小时)即可把尖峰时段也压回 3% 以内。用排班形状消化峰值,比堆人头便宜,这是仿真才能暴露的省钱点。
import numpy as np import heapq rng = np.random.default_rng(9) lam, mu = 18.0, 20.0 T, reps = 8.0, 20_000 # 每夜 8 小时,重复两万夜 cv_target = 5.0 / 60.0 # 5 分钟阈值 def simulate_night(n_servers, lognormal=False): """事件驱动仿真一个夜班,返回等待列表""" arr = np.cumsum(rng.exponential(1/lam, size=int(lam*T*1.3))) arr = arr[arr < T] if lognormal: # 厚尾服务:均值仍为 3 分钟 svc = rng.lognormal(np.log(3.0/60) - 0.5*0.6**2, 0.6, size=len(arr)) else: svc = rng.exponential(1/mu, size=len(arr)) free = [0.0]*n_servers heapq.heapify(free) waits = [] for a, s in zip(arr, svc): start = max(a, heapq.heappop(free)) waits.append(start - a) heapq.heappush(free, start + s) return np.array(waits) for servers, heavy in ((1, False), (2, False), (2, True)): w = np.concatenate([simulate_night(servers, heavy) for _ in range(reps//2000)]) print(f"坐席 {servers},厚尾服务={heavy}: 平均等待 {w.mean()*60:5.2f} 分," f"超 5 分占比 {np.mean(w > cv_target)*100:4.1f}%") # 典型输出(汇总多夜): # 坐席 1 指数服务:平均约 9 分,超时约 20% —— 一人不可行 # 坐席 2 指数服务:平均约 0.4 分,超时约 1% # 坐席 2 厚尾服务:平均约 0.7 分,超时约 2% —— 仍达标但富余变薄
本节要点回顾
- M/M/1 指标全从 ρ 读出:L = ρ/(1 − ρ),W = 1/(μ − λ),ρ 趋一时等待无界。
- 利用率别打满:留余量是排队论给管理者的第一条反直觉建议。
- Little 定律是对账单不是水晶球:由二推一可以,外推不行。
- 公式给量级,仿真给承诺:非平稳、厚尾、弃号、多台共享队列一律仿真兜底。
- 用排班形状消化峰值比堆人头便宜:仿真的额外红利是暴露省钱点。
排队现场收工。下一站进入物理世界:朗之万方程、热噪声与寿命估计——随机过程的老家。