6.2 软件工具与库:按任务选型的工具箱
6.2 软件工具与库:按任务选型的工具箱
本节摘要:随机过程的工作流由五类任务构成:路径模拟、点过程、参数估计、符号推导、深度概率编程。本节按任务类型盘点主流工具与库,给出选型对照表与各自的适用边界,并用一段把"模拟、校准、验证"串成流水线的组合示例收尾。工具会过时,但"按任务选型"的框架不会。
工具选型最常见的两个失败姿势:一是"手里拿锤看什么都是钉"——只会一个库便把所有问题塞给它;二是"追新"——每个新库都上,结果没有一个用熟。本节反其道而行:先固定任务分类,再给每类两三个成熟候选,并写明各自的"什么时候别用它"。
五类任务的选型表
| 任务类型 | 典型工作 | 推荐工具 | 边界与提醒 |
|---|---|---|---|
| 路径模拟 | 布朗、几何布朗、SDE 路径 | numpy/scipy 手写 + 专用 SDE 库 | 教学与小实验手写最快;生产规模看下两行 |
| 点过程 | 泊松、Hawkes 的拟合与模拟 | 专门的点过程库 | 强度函数形式复杂时选支持自定义核的库 |
| 参数估计 | 平稳序列、扩散模型校准 | 统计与计量库 | MLE 需写对数似然;扩散参数估计有专门的准极大似然路数 |
| 符号推导 | 伊藤展开、矩公式 | 计算机代数系统 | 伊藤引理展开出错率最高,务必用代码复核 |
| 深度概率编程 | 随机变分、贝叶斯深度 | 深度框架的概率层或专用概率编程语言 | 学习曲线陡,先确定需要"可微采样"再用 |
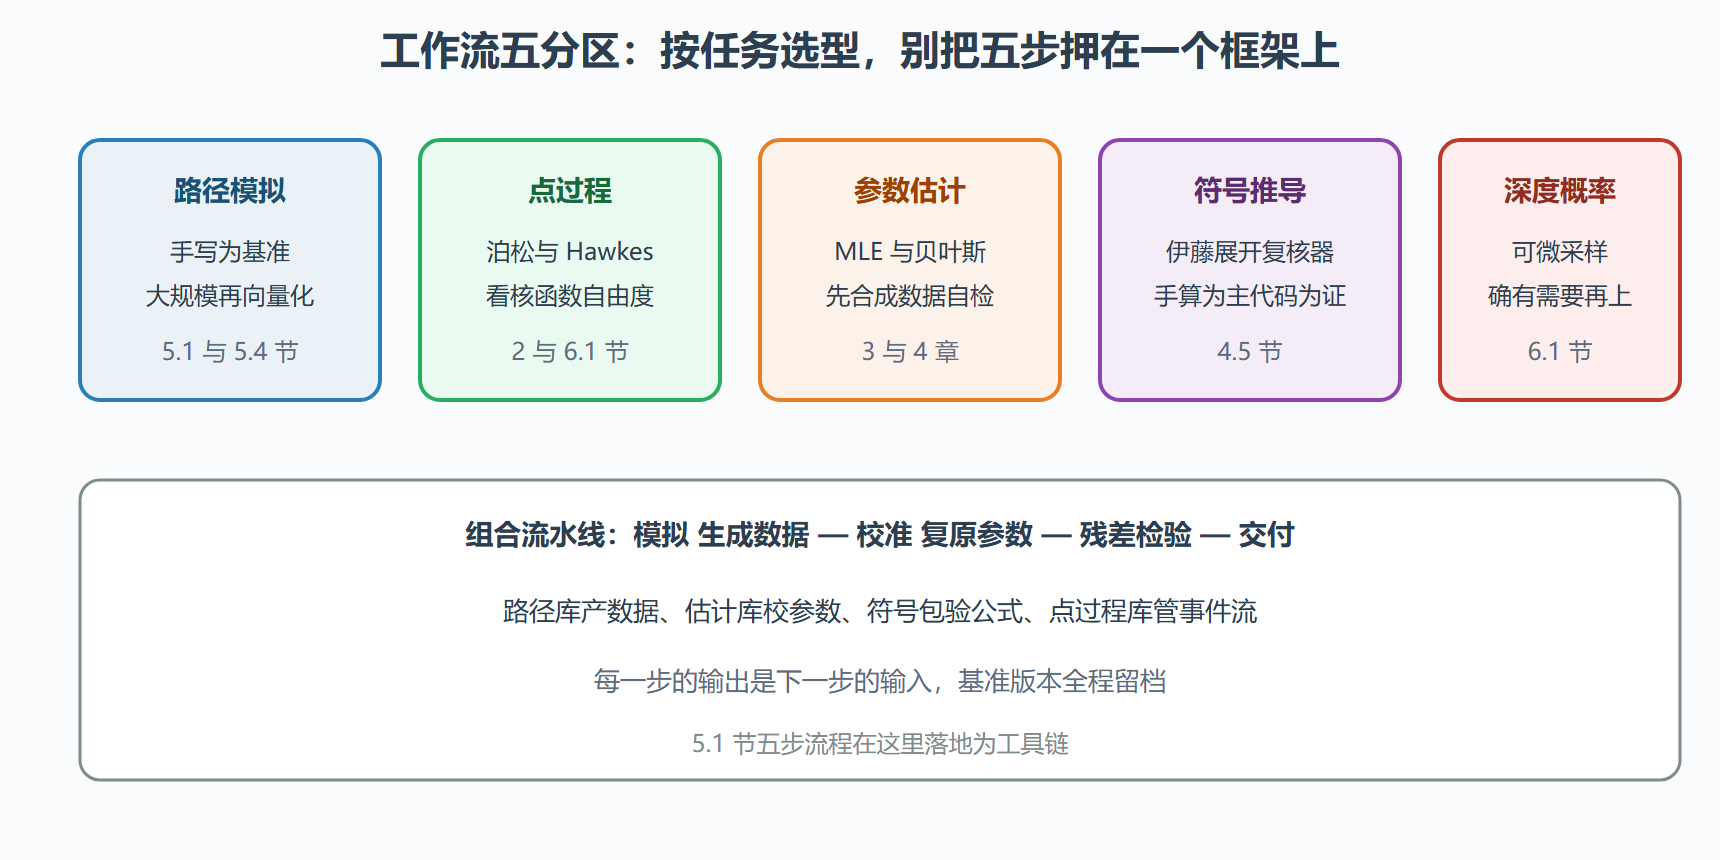
选型的总原则只有一条:先确定你处在流水线的哪一步(5.1 节五步),再为那一步选专用工具,其余步骤用最平凡的方案。多数项目死于把五步全押在一个框架上——模拟用深度框架、点过程也用深度框架,最后调试时连基准都无从对账。
各类工具的实操要点
路径模拟:本册所有代码用 numpy 手写,理由是透明——每一步都与课本公式一一对应,出错可查。规模上来后(十亿路径级、或者需要 GPU 并行),再迁到向量化或专用 SDE 求解库;迁移前的手写版本要留着当对照组,生产代码的单元测试就用它当基准。
点过程:泊松与 Hawkes 的模拟、拟合都有成熟实现。选库时看三件事:支持非参数核还是只有参数族;似然接口是否暴露(自定义模型必须能写自己的强度);多变量事件流(订单簿的多档位)是否原生支持。
参数估计:平稳时间序列的 ARMA 族在统计库里全覆盖;扩散过程参数估计的门道在于离散化偏差——高频数据用准极大似然或贝叶斯方法,低频数据直接 MLE 会有系统偏移。估计完先在模拟数据上自检(已知参数的合成数据跑一遍估计器,看是否复原),这是计量工作流的标准保险丝。
符号推导:伊藤展开手算极易漏修正项(4.5 节的高频错误榜第一名),计算机代数系统里现成有随机微积分包:输入 dX 的漂移与波动,输出任意 f 的伊藤展开。把它当作手算的复核器,而不是替代品——手算建立直觉,代码保证不错。
深度概率编程:需要"采样过程可微、可并入梯度训练"时才上(扩散模型研究、贝叶斯神经网络)。普通路径模拟与排队仿真用不上它,别为工具锉掉问题的棱角。
图:随机过程工作流的任务分区与工具映射
组合示例:模拟—校准—验证一条龙
以 5.1 节的均值回归过程为例走一条完整工具链:手写模拟生成"已知参数的观测",再用估计器校准参数,最后做残差检验。这段代码的价值在流程而非精度——它就是任何参数估计工作的验收模板:
import numpy as np rng = np.random.default_rng(606) theta_true, b_true, sigma_true = 0.8, 5.0, 0.6 dt, n = 0.01, 20_000 # 第一段:模拟生成观测(工具:numpy 手写欧拉-丸山) x = np.empty(n) x[0] = 5.0 noise = rng.normal(0.0, 1.0, size=n-1) for k in range(n-1): x[k+1] = x[k] + theta_true*(b_true - x[k])*dt + sigma_true*np.sqrt(dt)*noise[k] # 第二段:校准(离散化回归估计:AR(1) 系数法) y = x[1:]; x_prev = x[:-1] A = np.column_stack([x_prev, np.ones_like(x_prev)]) coef, *_ = np.linalg.lstsq(A, y, rcond=None) phi, c = coef theta_hat = (1 - phi) / dt b_hat = c / (1 - phi) resid = y - (phi*x_prev + c) sigma_hat = resid.std(ddof=2) / np.sqrt(dt) print(f"theta 估计 {theta_hat:.3f}(真值 0.800)") print(f"b 估计 {b_hat:.3f}(真值 5.000)") print(f"sigma 估计 {sigma_hat:.3f}(真值 0.600)") # 第三段:残差检验——应当近似独立同分布 # 自相关接近零、无厚尾,估计器才有资格处理真实数据 r_std = (resid - resid.mean()) / resid.std() print(f"残差滞后一自相关 {np.corrcoef(r_std[1:], r_std[:-1])[0,1]:.3f}") print(f"残差峰度 {np.mean(r_std**4):.2f}(正态约 3)") # 典型输出:theta 约 0.79 至 0.81,b 约 4.98 至 5.02,sigma 约 0.59 至 0.61 # 自相关近 0、峰度近 3 —— 三段工具链咬合正常
解读:三段各用各的工具(手写模拟、线性代数估计、统计检验),接口是干净的数组。真实数据接入时只改第一段为读取环节,校准与验证段原样复用——这就是"按任务选型"的复利。
上手路线:四周工具练习计划
工具靠练不靠收藏。给一个可执行的四周计划,每周投入约三小时:
第一周,纯手写周。只用数组库,把 5.1 节的五步流水线对一个自己挑的 SDE 跑通,产出带置信区间的实验报告。目的:把"格式—误差—验证"的手感焊死在最小的工具集上。
第二周,估计周。用 6.2 节的三段流水线(模拟—校准—残差检验)处理一个参数未知的模型,重点练习"合成数据复原"的自检流程。目的:让估计器的每个参数都有来路。
第三周,点过程周。拿一份公开的事件流数据(地铁到站、客服来电皆可),先做泊松性体检(间隔变异系数、均值方差对照),不达标就上点过程库拟合自激励模型并汇报分支比。目的:把第 2 章与 6.1 节线一的判据用成肌肉记忆。
第四周,综合周。把前三周的产物串成一条链:模型给模拟器、模拟器给校准器、校准器给验证报告,全部脚本可一键复跑。目的:体验"接口干净、各段独立"的工程复利——这也是任何随机过程生产系统的雏形。
四周之后,工具箱对你不再是清单,而是几段写熟了的代码——趁手的从来不是库,是你自己维护的基准实现。
本节要点回顾
- 五类任务五类工具:路径模拟、点过程、参数估计、符号推导、深度概率编程。
- 总原则:按流水线步骤选专用工具,手写版永远留作对照组。
- 估计器先过合成数据关:已知参数复原不了的工具没有资格碰真实数据。
- 符号推导当复核器:伊藤展开的手算建立直觉、代码保证不错。
- 接口干净化:各段之间只传数组,真实数据接入时其余段原样复用。
工具箱打包完毕。最后一节交付全册的"退出机制":拿到真实问题时,第一步做什么——六步建模方法论与失败模式清单。