5.1 块设备驱动:请求队列与 bio
5.1 块设备驱动:请求队列与 bio
本节摘要:块设备驱动的核心不是应答读写而是消化队列。本节讲清块层的三层结构、bio 与请求的关系、多队列框架下驱动的对接方式,并用一个内存盘驱动走完注册、队列处理、容量上报的完整闭环。
文件系统想读第 1000 号扇区,页缓存想把脏页刷盘,进程直接读设备文件——块设备的世界里,请求源头五花八门,但到达驱动时已经统一成一种形态:队列里的块请求。驱动要做的不是"接待每一位客人",而是"按批处理订单"。这个定位转变,是理解块设备驱动的钥匙。
块层三层结构
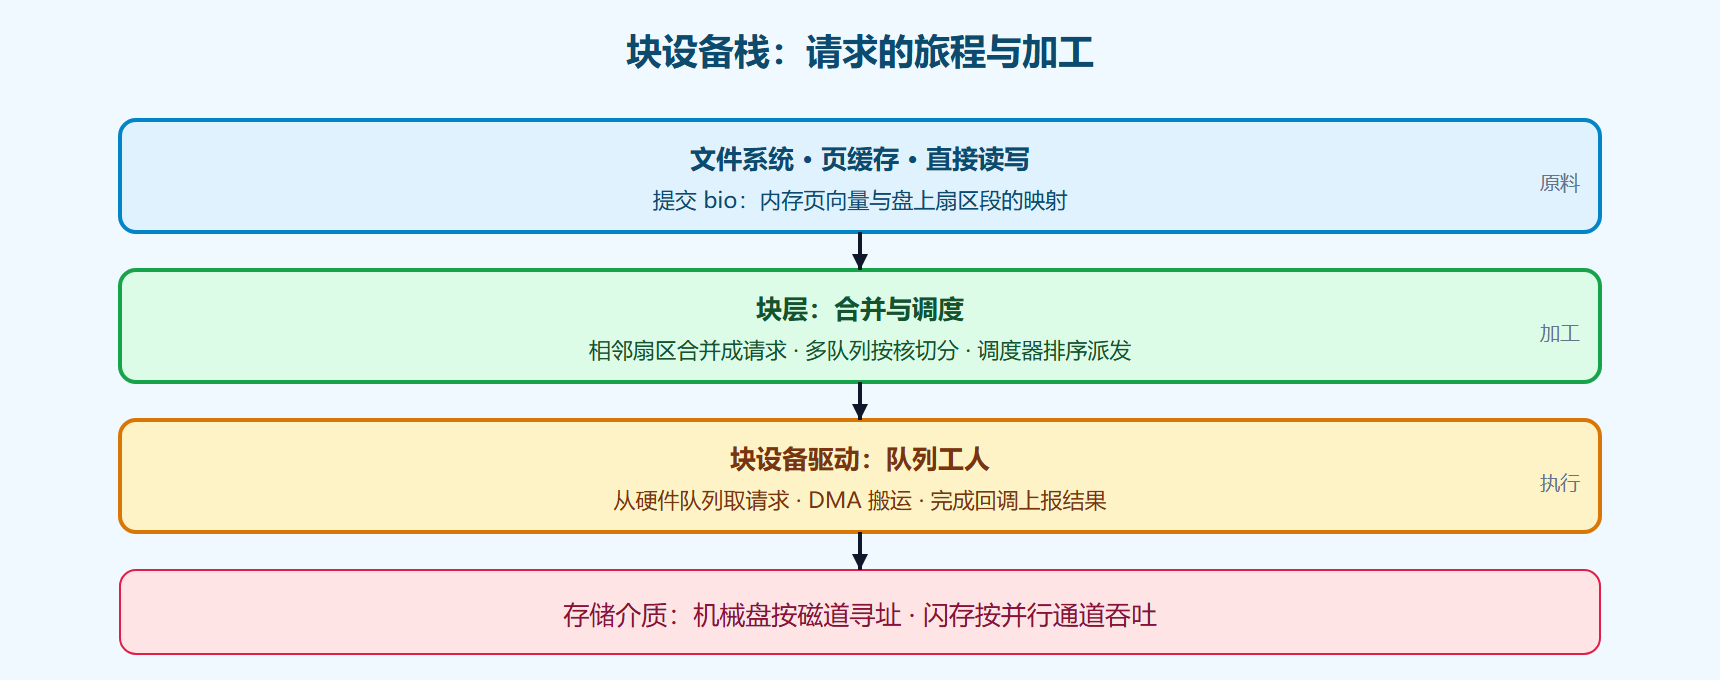
从用户请求到介质操作,中间隔着三层,各司一职:
通用块层接收上游请求。文件系统提交的最小单位叫 bio——它描述"这批内存页与哪些盘上扇区段对应",可能分散在多个内存页里(所以叫 bio 的项是向量数组)。bio 是"原料",还不是"订单"。
请求队列层把原料加工成订单:相邻扇区段的 bio 被合并成一个请求,散落的请求按调度策略排序。合并是这一层的杀手锏——磁介质时代它把随机寻道压到最低,闪存时代它把小写聚成大块、让介质并行通道吃饱。调度器有多种可选,从经典的Deadline到为固态盘优化的多队列调度,运维层面随时可换。
驱动层从队列取订单执行。现代内核的多队列框架给每个处理器核心配了软件队列与硬件派发队列,请求在软件队列里排队,成批滑入硬件队列,驱动从硬件队列取活——锁竞争被切分到各核心,多核伸缩性就此打通。
块设备栈分层透视图
一个内存盘驱动的骨架
用内存当介质写一个块设备,能把驱动的最小职责看得一清二楚——没有真硬件的干扰,剩下的全是框架对接:
#include <linux/blk-mq.h> #include <linux/module.h> #define RAMDISK_SECTOR_SIZE 512 #define RAMDISK_SIZE (4 * 1024 * 1024) /* 4MB 容量 */ static u8 *rd_mem; static struct gendisk *rd_disk; static struct blk_mq_tag_set rd_tags; /* 队列工人:框架把请求递到这里,驱动逐个执行 */ static void rd_queue_rq(struct blk_mq_hw_ctx *hctx, const struct blk_mq_queue_data *bd) { struct request *rq = bd->rq; struct bio_vec bvec; struct req_iterator iter; loff_t pos = blk_rq_pos(rq) * RAMDISK_SECTOR_SIZE; blk_mq_start_request(rq); /* 遍历请求里的每段内存:块层已把合并整理好 */ rq_for_each_segment(bvec, rq, iter) { void *addr = kmap_local_page(bvec.bv_page) + bvec.bv_offset; if (rq_data_dir(rq) == READ) memcpy(addr, rd_mem + pos, bvec.bv_len); /* 读:内存到页 */ else memcpy(rd_mem + pos, addr, bvec.bv_len); /* 写:页到内存 */ pos += bvec.bv_len; kunmap_local(addr); } blk_mq_end_request(rq, BLK_STS_OK); /* 立刻完成:内存盘无需等待 */ } static const struct blk_mq_ops rd_mq_ops = { .queue_rq = rd_queue_rq, };
队列函数是块驱动的灵魂:框架在合适时机调用它,把整理好的请求递进来;驱动用请求迭代器遍历每段内存,按读或写方向搬运,最后必须给请求一个"完成回执"。真硬件驱动里,搬运换成 DMA 启动、完成回执挪到完成中断里——框架不急,硬件节奏由驱动自己掌握。
注册:让系统认识这块盘
队列工人就位后,还要办理三件事:分配介质、注册队列与标签集、创建磁盘对象并设置容量:
static int __init ramdisk_init(void) { struct request_queue *q; rd_mem = vmalloc(RAMDISK_SIZE); if (!rd_mem) return -ENOMEM; rd_disk = blk_alloc_disk(NULL, NUMA_NO_NODE); if (IS_ERR(rd_disk)) return PTR_ERR(rd_disk); rd_tags.ops = &rd_mq_ops; rd_tags.nr_hw_queues = 1; /* 内存盘一个硬件队列足矣 */ rd_tags.queue_depth = 128; rd_tags.numa_node = NUMA_NO_NODE; if (blk_mq_alloc_tag_set(&rd_tags)) goto err_free; if (blk_mq_init_queue(rd_disk, &rd_tags)) goto err_tags; rd_disk->major = 0; /* 动态主设备号 */ rd_disk->first_minor = 0; rd_disk->minors = 1; rd_disk->fops = &rd_fops; /* 打开释放等基础操作 */ strcpy(rd_disk->disk_name, "ramdisk0"); set_capacity(rd_disk, RAMDISK_SIZE / RAMDISK_SECTOR_SIZE); add_disk(rd_disk); /* 上架:系统自此可见 */ return 0; err_tags: blk_mq_free_tag_set(&rd_tags); err_free: vfree(rd_mem); return -ENOMEM; }
add_disk 是上架动作,执行后设备出现在块设备清单里,分区工具与文件系统可以立刻使用。容量按扇区数上报,块层据此校验请求范围——驱动谎报容量,文件系统越界写就是迟早的事故。
$ lsblk NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT ramdisk0 249:0 0 4M 0 disk $ mkfs.ext2 /dev/ramdisk0 && mount /dev/ramdisk0 /mnt $ dd if=/dev/zero of=/mnt/test bs=4k count=100 && sync
合并的威力:为什么框架要修蓄水池
假设四个进程先后请求读相邻的四个 4KB 块。无队列世界里,驱动应答四次、介质往返四次;块层把它们合并成一个 16KB 请求,介质一次吞吐完成——请求数除以四,介质效率翻倍。对机械盘,合并加排序还把随机寻道重排成顺磁道扫掠,延迟差出数量级;对固态盘,合并让并行通道吃满。调度器在此之上再叠加策略:读请求设期限防饿写、写请求批量刷出防抖动。驱动侧的感受则是"取到的订单又大又齐"。
⚠️ 常见坑:在队列函数里睡眠或做耗时同步等待。多队列框架的调用环境不容拖延,需要等待硬件的驱动应启动异步传输、在完成中断里收尾,而不是在队列函数里干等。
本节要点回顾
- bio 是原料、请求是订单:块层合并排序,驱动只管消化队列。
- 队列函数是块驱动灵魂:遍历段、按方向搬运、必须回执完成。
- 多队列按核切分:锁竞争分散,多核伸缩性由此而来。
- 容量如实上报:块层与文件系统都拿它做边界信任。
同一道吞吐难题,网络世界交出了另一份答卷。下一节看网卡驱动如何在协议栈流水线上当好自己的工位。