6.5 驱动性能优化策略
6.5 驱动性能优化策略
本节摘要:性能优化是测量驱动的科学,不是改代码的玄学。本节给出"测量、定位、优化、复测"的完整闭环,重点讲锁优化四招、批量与缓冲策略、缓存友好布局与中断合并,每一招都配驱动场景的真实取舍。
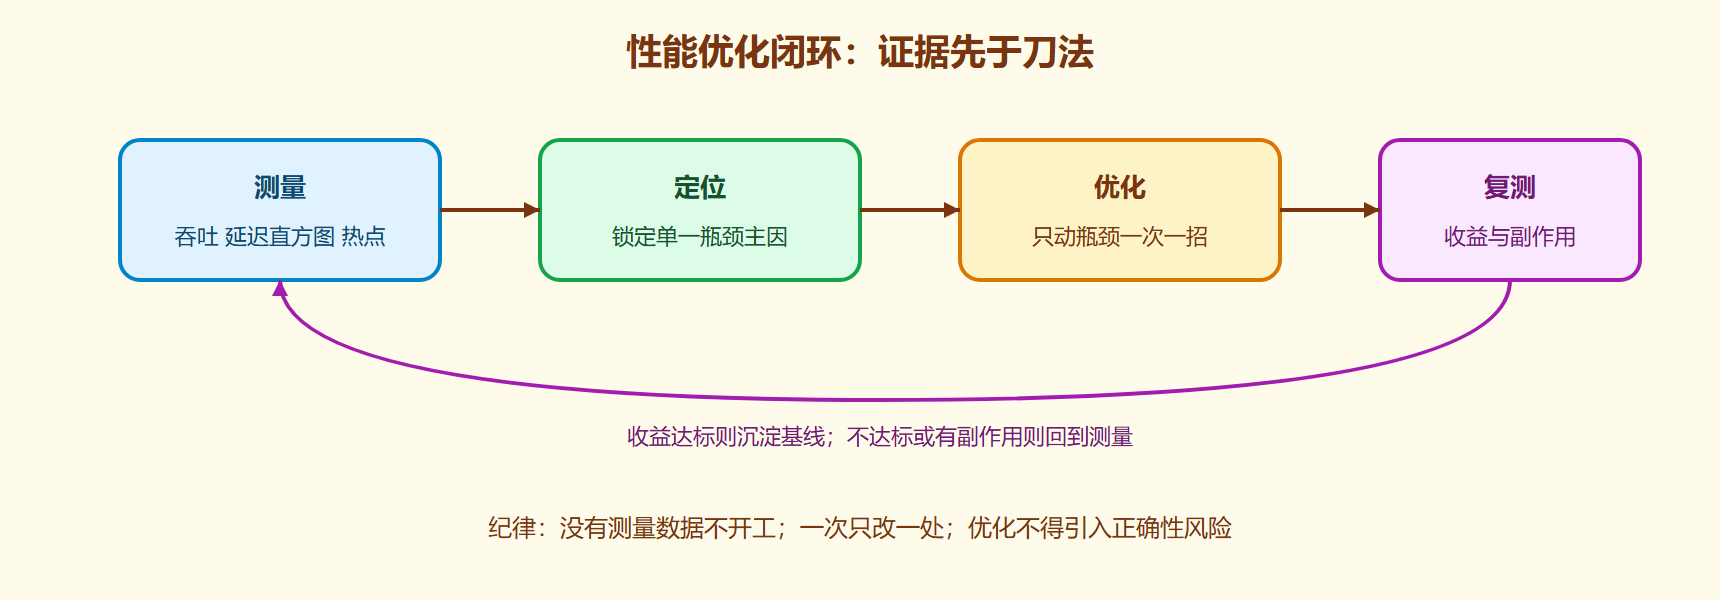
"感觉驱动有点慢,把锁拆了吧"——这句话是性能事故的常见起点。锁拆掉,竞态回来了,第 6.1 节的账实不符以更大规模重演。性能优化的第一原则恰恰相反:未经测量的优化是猜谜,猜错的代价往往不是慢,而是坏。正确的流程是一个闭环:先测量拿到瓶颈证据,再针对瓶颈动刀,改完复测验证收益,最后把结论沉淀成基线。
第一步:测量什么、用什么量
驱动性能问题分三类,各有对口的测量工具。
吞吐不足——每秒处理的包、扇区、帧数上不去。工具:性能计数器与吞吐统计,块层与网络栈自带分设备分队列统计目录,直接读数。
延迟超标——单次操作偶发卡到几十毫秒。工具:延迟直方图(块层与网络栈可开启分桶统计,看尾延迟分布而不是平均值——平均一毫秒、千分之一概率一百毫秒,对存储协议是灾难)。
处理器被吃光——软中断或系统态占比畸高。工具:性能剖析工具的采样报告,直接指出热点函数;函数追踪工具记录调用频率与耗时。
$ cat /proc/interrupts | grep eth0 # 中断速率:每秒多少万次? eth0-rx-0: 1842031 ... IR-PCI-MSI $ perf top -g # 热点在哪:抽样看调用栈 62.41% [k] rx_poll 11.08% [k] memcpy 4.72% [k] dma_unmap_single
这份假想报告的信息量足够开工:收包函数占六成处理器、其中搬运与解映射是可优化的邻居。
优化闭环
锁优化四招
测量显示热点在锁竞争时(多核下自旋空转占比高),按代价从低到高有四招。
缩临界区:锁里只放"必须互斥的序列",慢操作——分配内存、拷贝数据、打印日志、调用可能睡眠的接口——全部挪出锁外。6.1 节的修复就犯过"打印在锁内"的小毛病,高并发下日志序列化会放大锁竞争。
细化锁粒度:一把大锁管所有设备实例,多核竞争必然惨烈;改成"每实例一把锁"或"读路径与写路径分锁",竞争面立刻缩小。网络与块驱动的多队列设计(第 5 章)本质就是把锁拆到每个队列。
每处理器变量:统计计数这类"合起来有意义、分开算也不错"的数据,给每个处理器一份本地副本,读取时再求和——计数场景的锁竞争直接归零。
无锁环:单生产者单消费者的描述符环(第 5 章收发包环),用"生产者只动尾指针、消费者只动头指针"的所有权分割,配合内存屏障做到免锁。代价是设计复杂、正确性论证难,只在测量证明锁竞争是瓶颈后才值得上。
批量与缓冲:让硬件吃饱和让处理器歇脚
合并相邻操作。第 5.1 节块层合并请求是框架送的;驱动自己也能做——传感器驱动攒十次读数一次上报、显示驱动攒一帧像素一次刷新。批量的收益是双份的:硬件少跑往返,处理器少进中断。
预分配与池化。热路径上动态分配内存是延迟尖刺的常见来源:分配器偶尔慢、偶尔失败。收包环的缓冲池(第 5.2 节的补挂机制)就是预分配的实践——稳定路径上只做"从池里取、放回池里"。
中断合并。流量高峰里每个包一次中断,处理器光是进出中断就饱了。现代网卡支持"攒一批包或攒一小段时间再中断",5.2 节的轮询式收包接口再叠加合并参数——吞吐上去了,代价是平均延迟略增。吞吐与延迟的取舍没有免费午餐,参数要按场景调:存储后端重吞吐,交互设备重延迟。
缓存友好:最后五 percent 的功课
处理器缓存的命中率对热路径影响可观。三条实践:热数据结构对齐到缓存行边界,避免两个核的私有数据挤在同一行互相失效(伪共享);描述符环按硬件访问模式排布,让 DMA 与 CPU 各自顺路;频繁访问的字段放结构体前部、冷字段靠后。这些改动收益幅度不大(常见个位数百分比),但在压榨极限吞吐的场景里是必修课,且必须在测量证明缓存是瓶颈后再动手——结构体重排会影响代码可读性,得不偿失就是负优化。
案例:一次完整的收包路径优化
把方法论套进一个具体场景。某网卡驱动压测数据:小包线速打满时处理器占用畸高,收包函数占热点榜首,其中缓冲区解映射与内存清零占大头。按闭环流程走一遍。
测量:延迟直方图显示尾延迟正常,说明不是队列堵塞;剖析报告指向收包路径的两处热点。定位:逐段审读收包代码,发现两个问题——每个包独立解映射(批量收包时本可合并),以及收包后整包清零(实际只需清收到的长度)。优化:一轮只做一处,先改解映射批量化——攒一批包统一解除映射,配对验证数据正确性;复测处理器占用下降明显,尾延迟无恶化。第二轮再改清零范围,收益较小但稳定。沉淀:两处修改连同压测脚本一起入库,成为该驱动的性能基线。
这个案例里最值得回味的是"一轮只动一处"的纪律:两处一起改,复测收益时说不清哪处贡献大、哪处引入了尾延迟副作用——归因能力比优化本身更宝贵,而它来自实验设计的克制。
一个常见的负优化警示
并非所有改动都值得做,负优化的典型长这样:某驱动作者发现每次收包都要查一次设备状态寄存器,于是把状态缓存进内存,"省掉一次寄存器访问"。单次看确实快了,但缓存引入了失效问题——设备状态被别处改变时缓存是旧的,于是又加锁、又加刷新逻辑,代码复杂度翻倍;压测结果却是尾延迟恶化:缓存不一致路径偶发重试,把千分之一的请求拖到慢车道。寄存器读本身只花亚微秒,而正确性问题的代价以毫秒计——性能账要算总账,局部小账赢了全局大账输了,就是负优化。
判别方法回到闭环:任何优化合并前,吞吐、尾延迟、处理器占用三个指标一起复测,任何一项显著恶化都要回头审视。优化代码与功能代码同等待遇进回归用例——"优化引入的缺陷"是回归测试最该拦截的一类。
常见追问
追问一:性能优化是不是越早开始越好,免得返工? 恰恰相反,过早优化是性能问题的常见成因。骨架未稳时做优化,赌的是"这里将来是热点",而热点分布要等真实负载才能验证;等骨架定型、负载模型落地后再测量,往往发现当初赌的地方冷清得很,真正吃处理器的是另一段。顺序应当是:先正确、再清晰、最后才快——清晰的代码剖析起来热点分明,优化起来下手精准;为快而绕的代码,反而把热点搅成一团雾。
追问二:多核系统上锁竞争看单核数据看不出来,怎么测? 要看两类指标:一是全局统计里的锁等待时间(有些剖析工具直接给出锁上的停留分布),二是可扩展性曲线——负载不变、核数翻倍时吞吐不涨反跌,几乎可以断定瓶颈在共享数据上。缓解思路在 6.5 的四招之外还有一条路:按核分片,让每个处理器各自维护一份统计与队列、汇总时再合并,把"共享"变成"各管各的"。代价是汇总瞬间的复杂性,值不值,照旧由测量说了算。
本节要点回顾
- 测量先于刀法:吞吐看统计、延迟看直方图、热点看剖析。
- 锁优化按代价递进:缩区、细化、每处理器、无锁,逐步升级。
- 批量与池化双收益:硬件吃得饱、处理器歇得了。
- 中断合并是取舍:吞吐换延迟,按场景调参。
- 缓存优化是尾段功课:先证明瓶颈再重排结构。
稳健与性能的两翼都齐了。下一章进入检验环节——调试与排错,把前六章的一切放上手术台。