7.4 崩溃分析:从 oops 到根因
7.4 崩溃分析:从 oops 到根因
本节摘要:内核崩溃时会留下一份"遗书"——oops 报告。本节逐段解剖一份真实的 oops:寄存器快照、调用栈、出错指令的读法,地址翻译成符号的技巧,以及转储工具链在"整 机 panic"场景下的用法,最后给出崩溃分析的标准动作序列。
1.2 节说过,驱动里的一个空指针就是一场系统级停电。但内核在倒下前做的最后一件事,是把现场完整记录下来——出错指令、寄存器、调用栈,一个不少。这份记录叫 oops(程序员的黑话,意思是"哎呀"),读懂它,多数崩溃能在几十分钟内定位到源码行。先看一份真实的(稍作精简)报告:
BUG: kernel NULL pointer dereference, address: 0000000000000008 #PF: supervisor read access in kernel mode CPU: 2 PID: 1287 Comm: led-daemon Tainted: G O RIP: 0010:led_ioctl+0x3a/0xc0 [board_led] Code: 48 8b 7d ... 全零序列 ... RSP: ffff888100123e80 EFLAGS: 00010246 RAX: 0000000000000000 RBX: ffff888100400800 RCX: 0000000000000000 Call Trace: ? __x64_sys_ioctl+0x62/0x90 led_ioctl+0x3a/0xc0 [board_led] __x64_sys_ioctl+0x62/0x90 do_syscall_64+0x33/0x80 entry_SYSCALL_64_after_hwframe+0x44/0xa9 ---�[ end trace 0000000000 ]---
第一遍:先抓四个要害
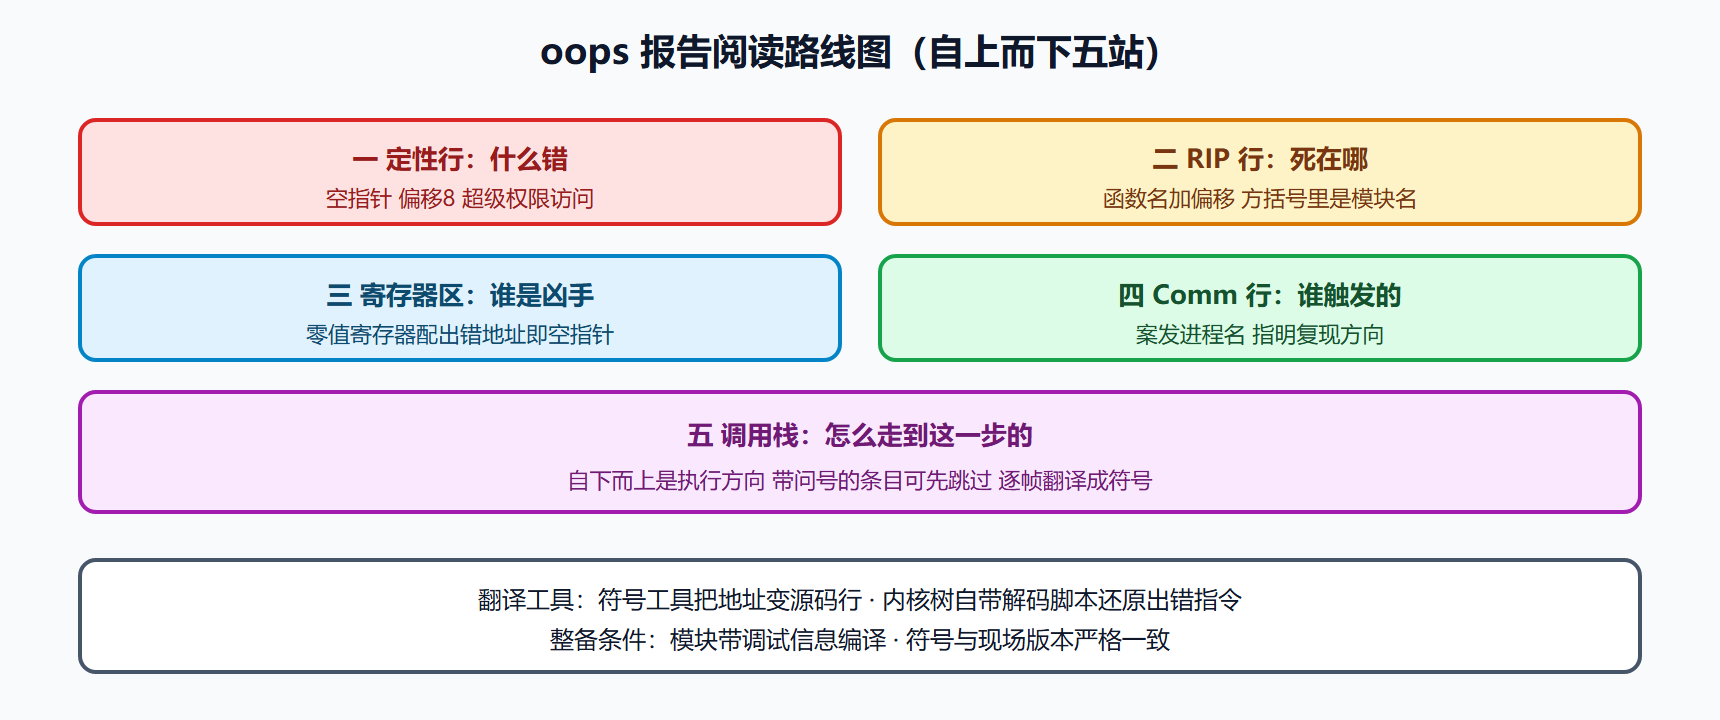
整份报告信息密集,但第一遍只需要四个字段。
第一行定性:空指针解引用,访问的地址是 8——注意不是 0,是"某个空指针加偏移 8"(访问结构体第 8 字节处的字段),这是"指针没初始化就当结构体用"的典型指纹。
RIP 行定位出错指令:程序计数器停在 led_ioctl 内偏移 0x3a 处,方括号里是模块名——模块名直接点名了你的驱动。内置驱动的崩溃没有方括号,需靠符号表翻译。
Comm 行给出案发时的进程:led-daemon——用户态守护进程正在调接口时崩的,方向直指接口代码。
Call Trace 倒着读:栈从下往上是"入口到现在"的路径,从上往下读则是"谁调谁":系统调用入口调了接口分发,分发调了你的接口函数,你在里面崩了。栈里带问号的条目(如示例中被略去的)表示"栈上残留、未必在当前路径",初读可跳过。
第二遍:地址翻译成源码行
RIP 里的偏移是机器码层面的,翻译回源码要用带调试信息的工具:
# 用符号工具把地址翻译成 源文件:行号 $ addr2line -e board_led.ko -f -i led_ioctl+0x3a led_ioctl /workspace/board-led/board-led.c:132 # 或在内核树上用解码脚本(模块需已加载符号) $ ./scripts/decodecode < oops.txt
board-led.c 的第 132 行是 cfg->mode = val;——cfg 是设备私有数据指针。再看寄存器区:RAX 为零,而那条出错指令是从 RAX 加 8 的地址读数据——RAX 就是那个空指针。回头看代码:
static long led_ioctl(struct file *filp, unsigned int cmd, unsigned long arg) { struct priv_data *cfg = filp->private_data; /* 第 128 行 */ ... cfg->mode = val; /* 第 132 行:cfg 为空 */
private_data 是 open 回调该填的字段,而这版驱动在 open 里忘了赋值——设备照样能打开(内核默认填零),直到某次控制命令踩上这颗雷。根因链条完整:open 漏初始化、接口函数未做判空、雷埋到第一次使用才炸。修复两处都补上:open 里正确赋值、接口里对私有数据判空返回错误——后者是 6.4 节防御性设计的直接应用。
oops 报告解剖图
oops 之后:系统还活着吗
oops 与 panic 是两种结局。oops 表示"当前上下文被处决":若是进程上下文,内核杀掉肇事进程、回收资源、继续运行——系统看起来还活着,但状态可能已受损(崩溃瞬间可能持着锁、改了一半数据);若是中断上下文崩溃,或后续发现无法恢复,升级为 panic——整机停机。工程铁律是:开发环境见 oops 立刻重启复测,生产环境见 oops 必须重启服务,别赌"还能跑"。
大案现场:转储分析
oops 是"轻案",栈还在、日志够用。最恶劣的"重案"——死锁挂死、断电崩溃、栈被破坏的 panic——需要完整内存转储:内核配置转储支持后,panic 时把全内存写入保留区,重启后用崩溃分析工具离线解剖:看任意进程的栈、翻任意数据结构、甚至回溯崩溃前的锁状态。分析命令风格如下:
$ crash vmlinux vmcore crash> bt -a # 所有处理器上的栈 crash> ps | grep led # 案发时进程状态 crash> struct file ffff888100400800 # 直接检视任意结构体
转储分析的门槛在配置(保留内存、收集机制)与体积(嵌入式设备常需网络转储),但其价值无可替代——它是唯一能事后检验"崩溃瞬间全系统状态"的手段。嵌入式资源受限场景下,至少保证:串口日志全量落盘、看门狗复位前的最后日志能带出来。
崩溃分析的标准动作
把全节收拢成一张动作卡:保存现场(日志全量导出,别让环形缓冲冲掉开头)→ 四字段定性(错误类型、出错函数、案发进程、调用路径)→ 地址翻译(符号工具定位到行)→ 复现条件推理(结合案发进程与接口路径,设计最小复现)→ 根因修复(修复点周围做防御性加固,参考 6.4 节清单)→ 回归沉淀(把复现条件写进 7.3 节的压测用例)。
💡 关键直觉:oops 分析的效率取决于"翻译链"是否常备——调试信息、符号文件、内核树版本三样东西与现场一致,翻译才能一次成功。发布流程(下一章 8.3 节)里必须把这三样的归档当成交付物管理。
常见追问
追问一:oops 里给出的调用栈,会不会把真正的元凶藏在更深的地方? 会,调用栈只是"案发时的路径",不是"案发的起点"。典型情形是破坏发生在 A 时刻(一段越界的写入踩了内存),崩溃发生在 B 时刻(另一段代码恰好踩到被污染的数据)——此时 B 的调用栈全是无辜者。识别这种"延迟案发"的线索有二:崩溃点周围的数据形态与嫌疑类型对不上(字符串混进结构体、 magic 数被改),以及复现时崩溃位置漂移不定。遇到这两种迹象,调查重心应从"谁崩了"转向"谁改了现场"——6.1 节的竞态清单与 7.3 节的注入手段此时联手上阵。
本节要点回顾
- 四字段先读:定性行、RIP、Comm、调用栈,其余字段按需深挖。
- 偏移地址是密码:配符号工具翻译成源码行,寄存器零值常是空指针本人。
- oops 不等于还能跑:状态可能已损,开发环境即刻重启复测。
- 重案靠转储:全内存快照是事后检验系统状态的唯一手段。
- 翻译链是交付物:调试信息与符号的归档要进发布流程。
调试的全部武器库到此巡礼完毕。最后一章走出单一驱动,看工程化的全貌:构建、兼容、发布、用户态方案与语言演进。