6.3 黎曼优化与机器学习
6.3 黎曼优化与机器学习:数据住进了弯曲空间
摘要:流形假设认为高维数据天然聚在低维弯曲流形附近,从而把学习问题搬上黎曼流形;黎曼优化用度量的梯度与回缩替代欧氏梯度与直线步长,约束条件化为几何身份。本节剖析流形假设的证据与限度,推导黎曼梯度下降的更新规则,盘点自然梯度与 Fisher 度量的亲缘,并在球面与低秩矩阵流形上完成实例演算。
一句行业黑话的实指
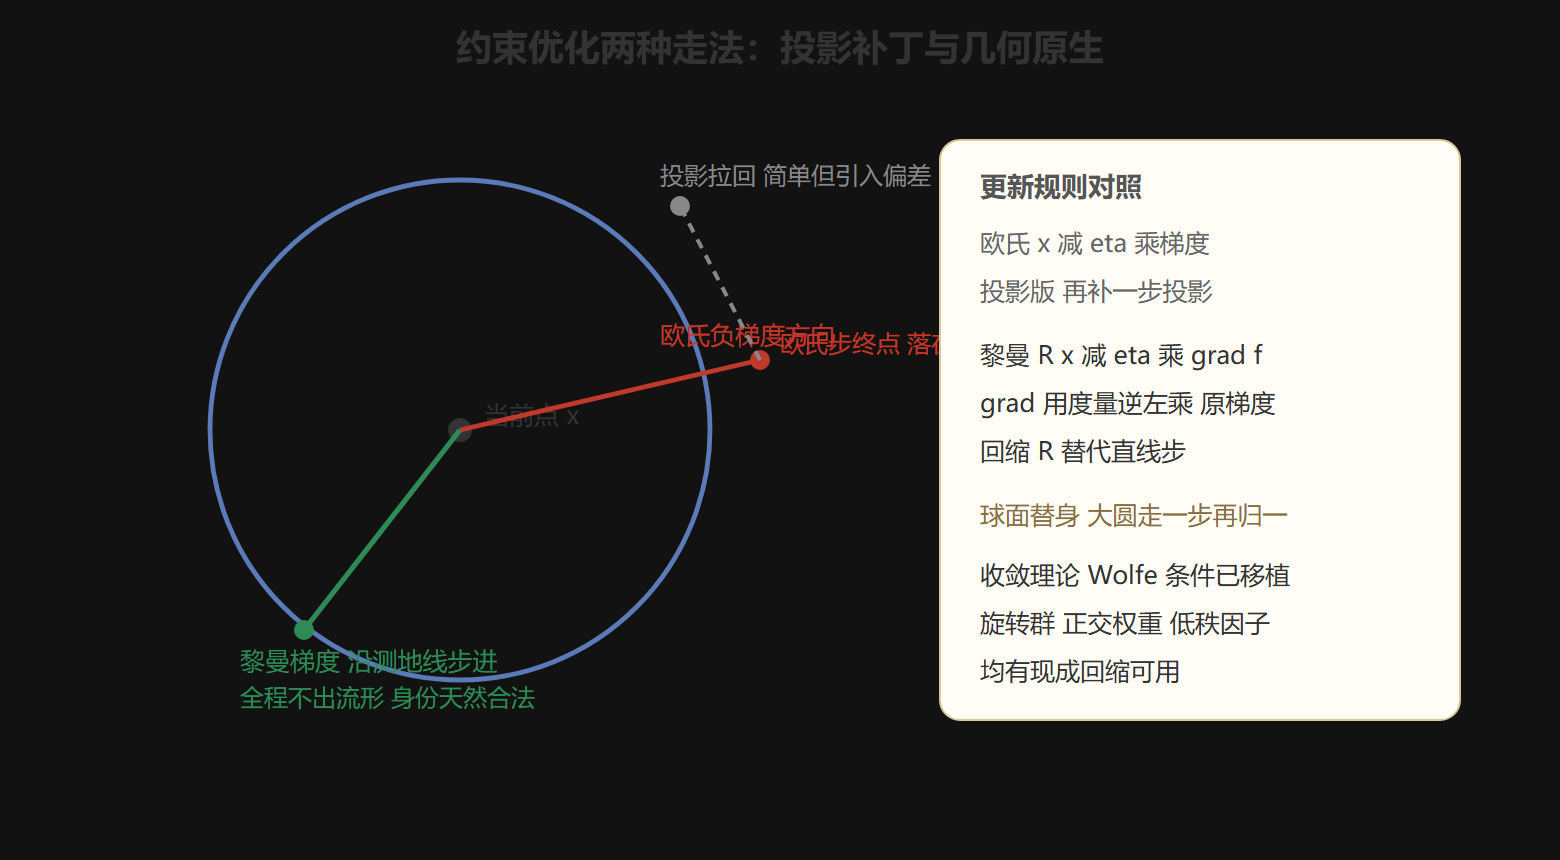
优化工程师说「参数不在欧氏空间里,得在流形上做优化」,外行听来玄虚,实指一件朴素的事:参数的合法取值域本身是弯曲的。神经网络的正交权重矩阵住在斯蒂弗尔流形上;协方差矩阵必须是正定对称的,全体构成一个「锥形」开流形;姿态估计的旋转矩阵构成三维旋转群;规格化概率分布全体在信息几何里弯成一张统计流形。在欧氏空间里做梯度下降再「投影回去」,步子大了会撞出合法域、投影引入偏差、收敛判据失真——而黎曼优化直接把整个迭代过程搬进弯曲空间,让「合法性」由几何身份自动保证,不再需要投影补丁。
另一条进路来自数据侧。把一张一千像素的人脸图片看作一千维空间中的点,全体人脸照片并不铺满整个空间,而是聚在一小片弯曲的「人脸流形」附近——光照、姿态、表情各张成流形上的一条低维曲线。这就是流形假设:高维数据的本征自由度远低于环境维度,数据集近似落在某个低维流形上。经典演示是瑞士卷:一张卷起来的薄饼状二维数据嵌在三维空间里,欧氏距离严重失真(饼的两端在三维里近、在流形上远),只有沿流形的测地距离才反映真实邻近关系。等距映射、局部线性嵌入、拉普拉斯特征映射、扩散映射等流形学习算法,全部在做同一件事:从采样点估计流形的结构与其上的一致距离——本质是对第 4.2 节「距离地图」的统计重建。
黎曼梯度下降:两处改写
欧氏梯度下降的骨架是「沿负梯度走直线步」:x_{k+1} = x_k - \eta \nabla f(x_k)。搬上流形要改两处。
第一处:梯度本身。 欧氏梯度依赖内积识别方向;流形上用度量 g 定义黎曼梯度 \mathrm{grad} f——它是满足 g(\mathrm{grad} f, v) = df(v)(对一切切向量 v)的唯一切向量。分量公式 \mathrm{grad}^k f = g^{kj} \partial_j f:普通梯度左乘度量逆矩阵。这一步与第 5.2 节哈密顿向量场「辛形式抬指标」完全同型——不同几何、同一动作,变化的是抬指标的机器(g 换成 \omega)。自然梯度算法(Amari)在参数空间配上 Fisher 信息度量后走的就是这个梯度,训练分布随参数弯曲的「最陡」方向由此修正——深度学习里自然梯度、K-FAC 等二阶方法的几何内核全在这里。
第二处:步进的执行。 流形上没有直线,负梯度方向只存在于当前切空间。标准做法是回缩 R_x(v):把切向量 v 送回流形上一点,要求在原点附近与指数映射 \exp_x(v) 吻合到二阶。工程首选不是真指数映射(要积分测地线方程,贵),而是等距性略弱的廉价替身——球面上的替身是「沿大圆走一步再归一化回球面」。更新规则成为
第 4.1 节的指数映射在此完成了从理论概念到算法原语的转变。收敛性理论(黎曼版的 Wolfe 条件、信赖域法)已由 Absil-Mahony-Sepulchre 的教材系统化,现代实现有专门的几何优化库支持(第七章工具链盘点)。
欧氏投影与黎曼步进的对照
实例演算:球面上的最小化
实例一:在单位球面上找最靠近给定外部向量 a 的点(球面投影问题)。目标函数 f(x) = \tfrac12\|x - a\|^2。欧氏梯度是 x - a;把它投到当前切平面(减去沿 x 的法向分量)恰等价于黎曼梯度——球面度量为单位阵时「黎曼梯度 = 欧氏梯度的切向分量」。回缩用归一化替身。几行即可跑通:
import numpy as np a = np.array([1.0, 2.0, 3.0]) x = np.array([1.0, 0.0, 0.0]) # 初始点(球面上) eta = 0.5 for k in range(60): grad_euclid = x - a # 欧氏梯度 grad_riem = grad_euclid - np.dot(grad_euclid, x) * x # 切向分量 = 黎曼梯度 x = x - eta * grad_riem x = x / np.linalg.norm(x) # 回缩:归一化回球面 print(np.round(x, 6)) # 输出: [0.267261 0.534522 0.801784] —— 恰为 a 的单位化,即球面上离 a 最近的点 print(np.round(x * np.linalg.norm(a), 6))
解析核对:球面上离 a 最近的点显然是 a/\|a\|,数值输出与解析解在小数点后六位一致。这个玩具问题有闭式解,但它演示的机制(梯度改造 + 回缩步进)正是复杂场景(正交权重、低秩分解)里唯一可用的机制。
实例二(要点式):低秩矩阵补全把 m \times r 因子矩阵 L 当作流形元素,固定秩矩阵全体 \{LR^\top\} 构成嵌入流形,黎曼共轭梯度在推荐系统场景中比带约束的欧氏法更稳、更快收敛——旋转群上的姿态估计、正交 RNN 权重、协方差学习(信息几何中的指数族流形配 Fisher 度量)都属同一谱系。共同点只有一句:约束不是包袱,是几何;几何不是障碍,是地图。
冷静的边界
流形假设有其限度,两点冷静提示。其一,真实数据只在「近似」意义上贴着流形——厚度、噪声、多分支交叉都会让测地距离估计失稳,流形学习算法对采样密度敏感;本册的精确几何在数据现场只能以估计量身份出现。其二,黎曼优化的每步成本高于欧氏法(回缩与度量运算),只在约束强、或欧氏投影失真大的问题上净赚。工程判断题:约束是硬的、参数维度中等、精度要求高——上黎曼;约束松弛可罚函数、维度巨大——欧氏加技巧仍是首选。
本节要点回顾
- 流形假设:数据贴着低维弯曲流形分布,欧氏距离失真,测地距离才是本真邻近(第 4.2 节距离地图的统计重建);
- 黎曼梯度:原梯度左乘度量逆矩阵,与哈密顿向量场「抬指标」同型异机;
- 回缩替代直线步:指数映射的廉价替身(球面即归一化),约束由几何身份自动保证;
- 实例链:球面投影数值解与解析解对表;低秩补全、姿态估计、自然梯度同谱系;
- 工程边界:约束硬且精度要求高才净赚;流形学习对采样密度敏感,本册几何在数据侧以估计量身份出场。