7.3 深度学习推理集成:分析支路的工程化
7.3 深度学习推理集成:分析支路的工程化
本节摘要:把推理模型接进管线有两条路线——专用推理元件(张量进出、管线内推理)与探针外挂(推理在旁路池异步跑、结果回贴元数据)。核心工程问题三个:推理不能阻塞数据流(异步与背压)、前处理不能破坏零拷贝路径、检测结果要可靠送达渲染端(元数据兑现)。本节给出完整方案与降载策略,是第七章的收口。
推理进管线的两条路线
路线一:专用推理元件。推理引擎被封装成标准变换元件:输入裸帧(或张量)、输出带结果的帧或张量。现成的推理插件家族覆盖主流引擎,第六章的手艺也能自己包一个。优点是一切都在管线语法里,命令行可描述;风险是推理时长直接卡在数据路径上——模型一慢,整支路的流返回值就堵。
路线二:探针外挂。主线管线保持轻快,在解码出口挂一个探针,探针把帧的引用投给外部推理线程池,自己立刻放行;推理完成后结果作为元数据回贴(或经另一通道送达渲染端)。优点是数据路径零阻塞;代价是两条通道的时序对齐要自己负责——帧已经流到渲染端,结果还在算,怎么对上?
两条路线的结构对照
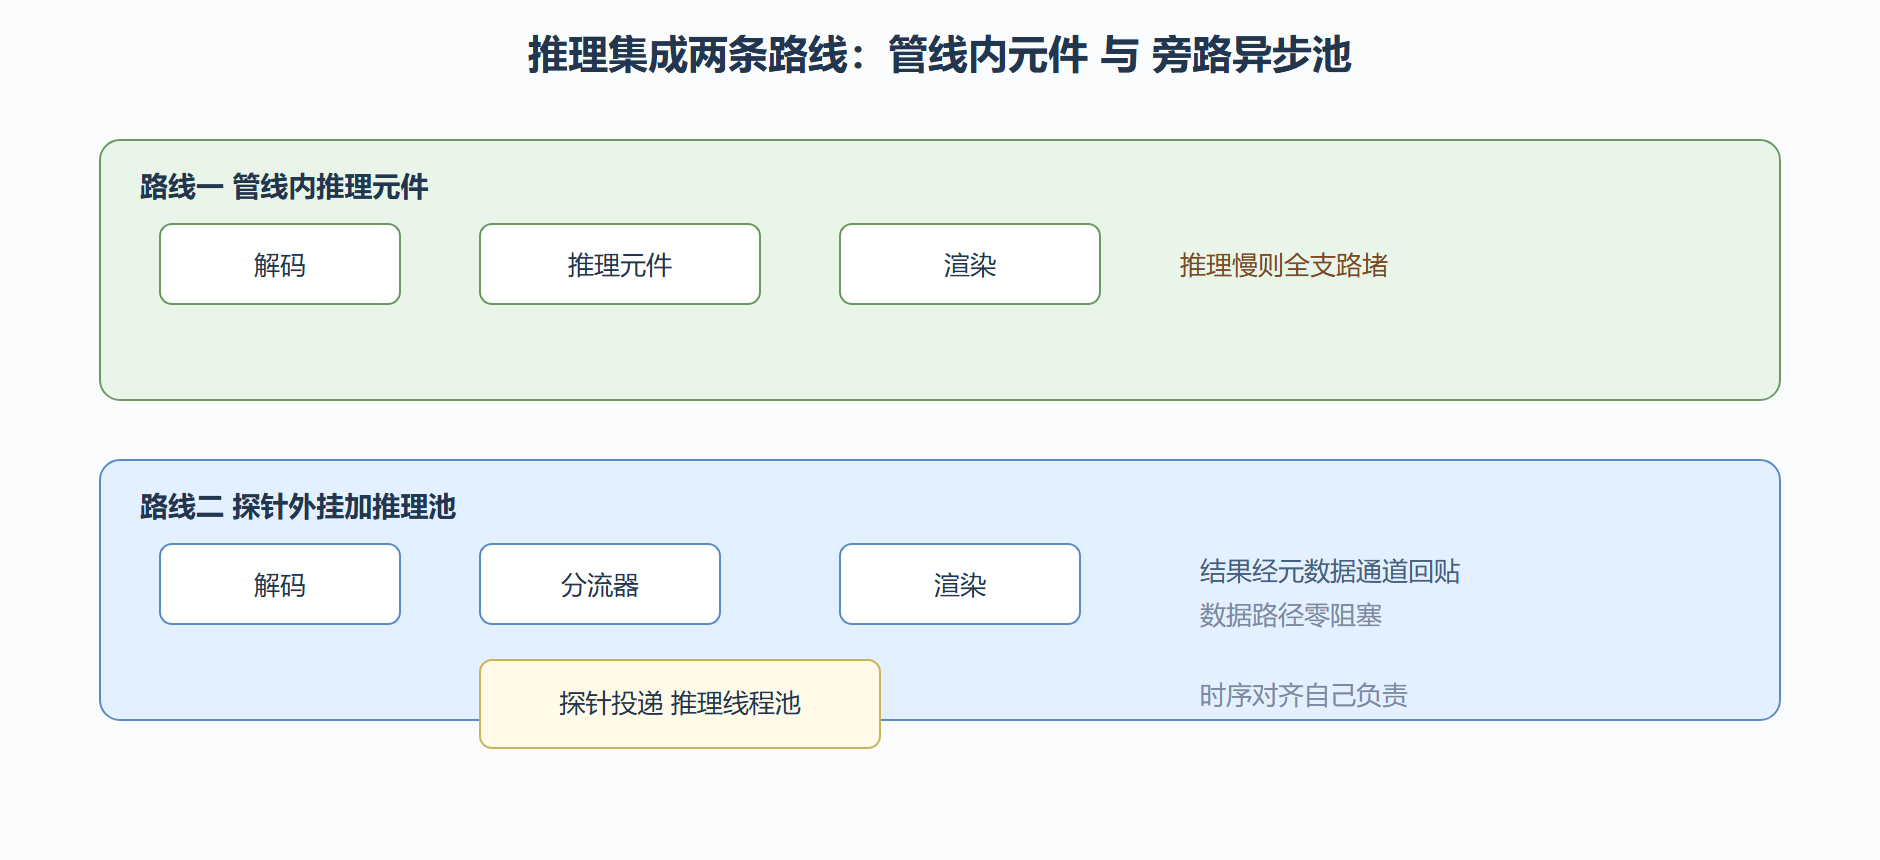
主线项目选了路线二,理由有三:四路解码已经吃满解码电路,推理必须与渲染彻底解耦;模型要热更新,旁路池换模型不动管线;结果只需要画框展示,不需要参与数据变换。路线选择判据——推理结果要参与数据变换(如超分辨率)选路线一;只要旁路结论(检测、统计、告警)选路线二。
背压与抽帧:算力对不上怎么办
推理吞吐跟不上帧率是常态,两种应对策略要分清。背压:推理池队列有界,满了就丢新帧——宁可漏分析,不可拖管线;这是探针外挂路线的天然优势,丢弃发生在旁路,主线毫发无损。抽帧:源头降载,分流器后接一个抽帧元件(或间隔丢帧的自写元件),每秒只送五帧去推理——多数检测场景对时间分辨率的要求远低于画面帧率。两者组合拳:抽帧做常规降载,背压做异常保护。
// 探针骨架:投引用 立刻放行 绝不等待 static GstPadProbeReturn probe_cb(GstPad *pad, GstPadProbeInfo *info, gpointer user_data) { InfraPool *pool = user_data; GstBuffer *buf = GST_PAD_PROBE_INFO_BUFFER(info); if (infra_pool_try_submit(pool, buf)) { // 有界队列 非阻塞 return GST_PAD_PROBE_OK; // 引用已在池内加计 } return GST_PAD_PROBE_OK; // 满则丢弃 旁路降载 }
前处理的零拷贝守卫承接 7.1 节:推理引擎若能直接吃显存帧(多数主流推理运行时的图像接口支持设备内存),前处理(缩放、归一化)留在显存系元件里做;若引擎只认主存,下载动作收拢到探针投递处一次完成,且在文档里写明这是路径的已知瓶颈。7.1 节"探针映射触发下载"的坑在这里反被利用——下载点集中一处,才好将来优化。
结果回贴:元数据的兑现
第六章注册的检测元数据在这里兑现。推理池完成一帧的分析后,按帧序号把结果写入结果表(键为帧序号);渲染端探针在每帧到达时查表——查到就取结果并挂到本帧元数据,查不到就空手放行(帧已过结果未到,正常丢弃);表要设水位淘汰(只保留最近数百帧),防止内存无限增长。画框元件读元数据、按 6.4 节的几何语义处理坐标,渲染完成。整条通路里,数据路径从头到尾没有一次同步等待——这正是路线二的设计目标。
⚠️ 常见坑一:结果表按时间戳对齐而不是帧序号。跨设备时钟微差与时间戳精度问题会让对齐漂移;帧序号是单调且同一来源的,永远优先。
⚠️ 常见坑二:推理池线程直接改管线内对象。旁路线程与流式线程共享的只有按值复制的结构(进队时拷贝、出队时只读),任何对管线对象的写都必须回到总线或探针投递完成。
💡 关键直觉:推理集成的全部工程要领浓缩成一句——重活出管线,结论进元数据,对齐靠帧号,降载靠抽帧。
三档工况合流后的资源观
一章三节至此合流:解码电路、网络、推理单元三处高压共享同一台设备。资源观的最后一条:峰值叠加预算——三档各自的压力测试都过,不代表叠加过;上线前必须做三档同时满载的联合压测,观察总线带宽、内存峰值、推理延迟百分位三项指标。第八章的试压验收会把这个联合压测写进清单。
推理支路的三个监控指标
分析支路上线后,值得常驻的监控指标有三个。推理延迟百分位:从帧到达探针到结果入表的全时长,看九十九分位而不是均值——长尾帧对应"漏检窗口",均值好看长尾难看是分析系统的典型病。结果表水位:表中未消费条目数,持续增长说明渲染端消费慢于推理端,是时序对齐要出问题的前兆。抽帧命中率:实际送去推理的帧占抽帧目标的比率,命中率跌破九成说明背压在常态性丢帧,该扩算力或再降抽帧率。三个指标都挂上告警,分析支路的健康状况才算看得见。
模型热更新补一段:旁路池换模型不动管线是路线二的既定优势,但要加一个约束——换模型与结果表清空必须原子完成,旧模型的结果带旧坐标约定混进新模型的表里,是画框错位的隐蔽来源。
前处理的规格对齐:模型输入与协商规格
推理支路有一处容易踩的规格错位:模型输入尺寸是训练时定死的,管线协商出的分辨率是动态的。对齐有三种做法,按优先级排。其一,能力集过滤器钉死推理支路的输入规格——抽帧支路加过滤器,把宽高钉在模型输入尺寸,框架自动插入缩放,最省心;代价是这一段协商空间变窄。其二,显存系缩放元件显式接在推理入口——路径清晰、可控性强,配合 7.1 节的零拷贝纪律不落地。其三,前处理引擎内部自适应——推理引擎的预处理接口自带缩放时,把对齐责任交给引擎;要确认引擎缩放用的插值方式与模型训练时的预处理一致,否则精度会莫名掉点。三种做法的共同底线:模型文档里的预处理约定(均值、归一化、色彩空间顺序)必须逐项核对,推理精度问题的半数根源在前处理而不在模型。
本节要点回顾
- 两路线判据:结果参与变换选元件内,只要结论选旁路外挂;
- 探针只投引用:数据路径零等待,满队丢弃是保护不是故障;
- 抽帧常规降载,背压异常保护:组合拳应对算力缺口;
- 下载点收拢一处:零拷贝路径的已知瓶颈要集中可优化;
- 对齐靠帧号:结果表带水位淘汰,帧序号优于时间戳;
- 峰值叠加要联合压测:三档各自过不等于合流过。
高压工况全部跑通。第八章进试压台:日志演练、故障复盘、瓶颈定位与生产清单——把工程师的经验变成可交接的资产。