3.1 InternalKey 与 KV 模型扩展
3.1 InternalKey 与 KV 模型扩展:键的时空坐标
本节摘要:RocksDB 对键值模型的扩展,核心全部藏在「内部键」的字节布局里:用户键原样保留,身后跟着序列号与类型标记。本节拆解这个布局的每一字节,推演多版本读取的裁决过程,解释类型标记如何让引擎「见字识义」,最后讨论键设计如何参与放大账目的定价。读完本节,你应该能为自己的业务设计出对存储友好的键编码方案。
从一个返回结果说起
设想这样一个会话:先后写入 user:1001 = Alice、user:1001 = Alicia,再删除 user:1001。三次操作,磁盘上留下了三条记录——注意,是三条,不是一条。用工具把 SST 文件 dump 出来,你会看到 user:1001 出现了三次,各自带着不同的序列号和类型。这就是「追加」公理在字节层的样子:引擎从不覆盖,只追加;新旧由看不见的尾巴裁决。
这条尾巴的正式名字是内部键(Internal Key),布局如下:
图3-1 内部键的字节布局
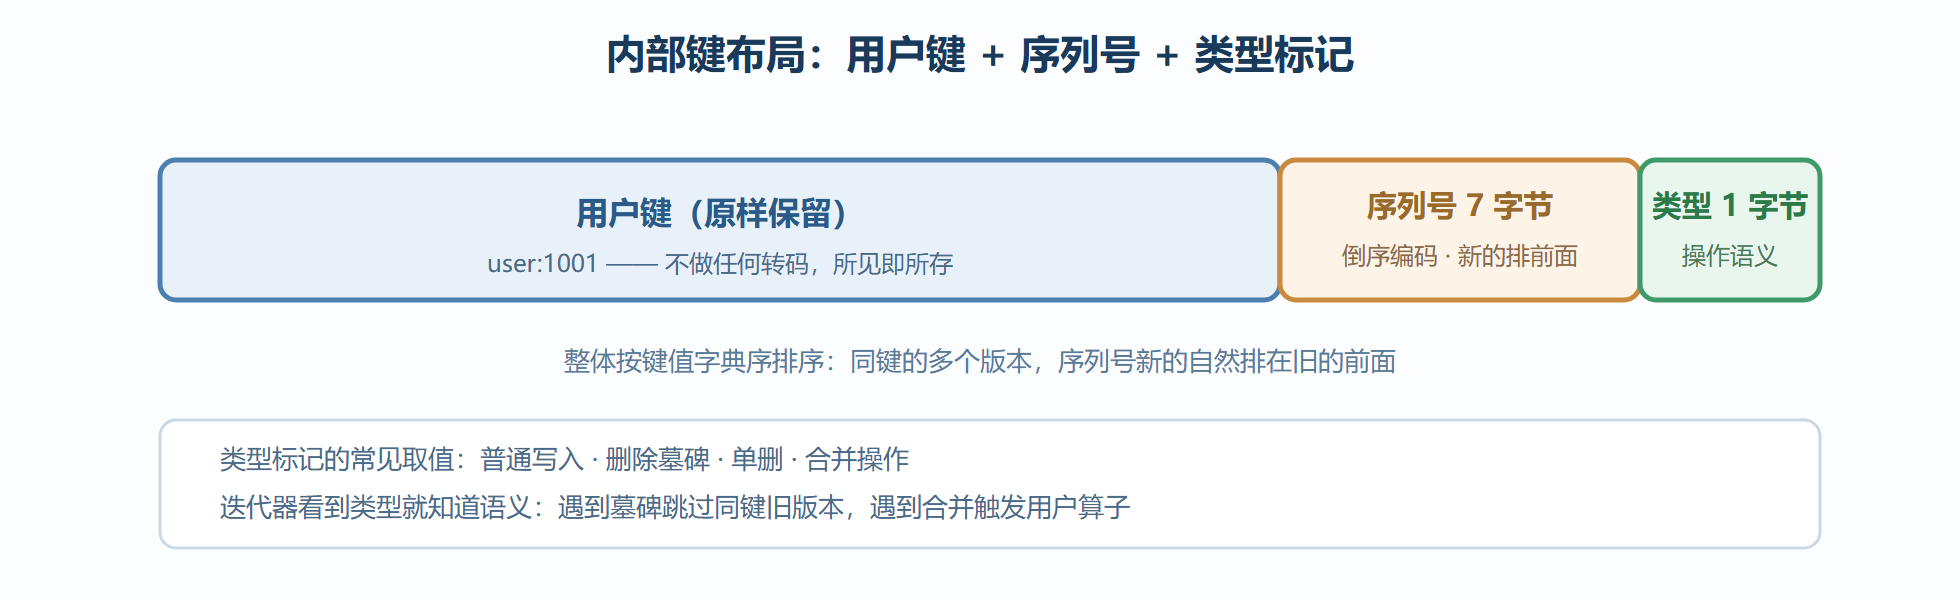
布局里有两个精妙的决定值得单独说。其一,用户键零加工。 你写入什么字节,遍历时就看到什么字节——键空间对使用者是透明的,任何满足字典序语义的编码方案都可以放心用。其二,序列号倒序拼进键尾。 拼接后的整体仍按字典序排序,于是一个巧妙的性质免费出现了:同一个用户键的所有版本自动聚集在一起,且新的排在前、旧的排在后。多版本检索不需要任何额外索引,字典序本身就是版本链。
类型标记:一字节的语义宣言
尾部的那个类型字节,宣告的是「本次写入是什么操作」,而不是「值是什么格式」。常见取值有四类:普通写入、删除墓碑、单删、合并操作。别小看这一字节,它让迭代器获得了「见字识义」的能力——遍历时无需解析值的内容,扫一眼类型就知道该怎么处理:
- 遇到普通写入,这是一条有效版本;
- 遇到墓碑,这个键从这个序列号起已死,同键更旧的版本全部可以跳过;
- 遇到单删,调用者保证此前只有一个版本,可以直接删除不必遍历版本链——批量场景下能省大量读放大;
- 遇到合并,需要调用使用者注册的合并算子做惰性计算。
第四类值得多看一眼。计数器是典型场景:与其「读出当前值、加一、写回」(一次读放大加一次全量重写),不如每次只追加一个增量,让合并算子在压缩时把增量一次性归并成总值。写入路径上移动的字节从「全量值」缩小到「增量」,写放大与并发冲突一起下降。这是把业务语义下沉进存储层的第一个范例,第 9 章会给完整实现。
多版本读取的裁决过程
现在把所有部件拼起来,推演一次带快照的读取。设当前序列号为 105,快照钉在 102,键 user:1001 在各处有这些版本:
| 位置 | 序列号 | 类型 | 值 |
|---|---|---|---|
| 内存表 | 104 | 删除墓碑 | — |
| L0 文件 A | 103 | 普通写入 | Alicia |
| L1 文件 | 100 | 普通写入 | Alice |
| L1 文件 | 98 | 普通写入 | Alina |
裁决按「从新到旧」扫描,规则两条:序列号大于快照的不可见;墓碑之后的同键版本全部无效。于是 104 因超过快照被忽略;103 是可见范围内最新的,直接命中返回 Alicia——根本不会去碰 L1。整个过程没有任何锁:版本的正确性由序列号的偏序关系数学保证,而非由互斥保证。
读不阻塞写,写不阻塞读,多版本的代价则悄悄记在另外两本账上:每个旧版本都要活到压缩确认「没有快照再看它」才能清退(空间放大),扫描同一键的版本链本身就是额外工作量(读放大)。模型的表达力和账单,永远是同一张纸的两面。
键设计:你在为放大账定价
既然排序完全由用户键的字节序决定,键的编码方案就直接决定了存储效率。几条被生产验证过的设计法则:
- 要扫描的字段放前面,只点查的字段放后面。
设备号 + 时间戳的键天然支持「按设备取时间段」的范围扫描,扫描连续落在一个键区间里,不会把全库翻一遍。 - 避免单调递增键做纯尾部——听起来反直觉,细节是:纯粹递增的键会让写入永远打在层级的最右端,压缩热点集中。要不要打散,取决于你的负载是「写满整条键空间」还是「只追新键」,第 5 章会给判断方法。
- 定长优于变长,能短则短。键不仅占自己的空间,还被复制进索引、过滤器与每一层的元数据里;键膨胀一倍,这些辅助结构全部跟着膨胀。
- 别把语义塞进值能表达的地方。需要按某个属性过滤,考虑前缀布隆或单独索引列族,而不是把属性编码进每个键里让所有文件陪跑。
一段对照实验能让这些法则落地。同一个百万级数据集,分别用「用户号 + 短后缀」与「超长变长键」两种方案灌入,对比文件体积、过滤器占用与点查延迟:短键方案的辅助结构占用明显更小、点查更快。键设计不是命名美学,是账目工程。
一场多版本读取的推演
字节布局的价值要靠一次实际读取来兑现。设一个具体场面:键「user:1024」先后被写入三个版本,序列号分别是七、十二、二十,其中序列号十二那次是删除——一个墓碑。三个版本可能散落在不同文件里:序列号七沉在深层,十二在中间层,二十还在零层。
此刻三种读取同时到来。不带快照的点查:从零层开始,先遇到序列号二十的版本,直接返回最新值,中间层的墓碑与深层的旧值根本不用看——首次命中即终局省下了全部深层数据访问。带刻度十五的快照读:序列号二十超出刻度被遮蔽,往下找到十二——是个墓碑,答案是「此键在刻度十五时不存在」,七号版本同样无权露面。带刻度九的快照读:二十与十二都越界,返回七号版本的值。三次读取、三份答案,互相都不算错——裁决全靠序列号不等式,没有一次加锁。
推演出一个工程结论:版本不是垃圾,是历史;清不清、留多久,是快照语义替你签的合同。 压缩在归并时只清理「所有活跃刻度都不再需要」的版本——若还有一个带着老刻度的快照活着,七号版本就还得留下。多版本读取的免费,账单寄给了空间账,付款人是活得最久的那个快照。这条因果链是第 4 章快照与第 5 章压缩之间的暗桥,值得在这里点明。
本节要点
- 内部键 = 用户键 + 倒序序列号 + 类型标记;用户键零加工,字典序天然构成版本链;
- 倒序拼接让「同键聚簇、新版本在前」免费成立,多版本检索不依赖额外索引;
- 类型标记让迭代器见字识义:墓碑截断版本链,单删跳过遍历,合并触发用户算子;
- 多版本读取无锁完成,代价记在空间与读放大两本账上;
- 键编码方案参与写放大与读放大的定价:要扫描的字段放前面,键要短、要定长。
键的字节契约清楚了。但「哪些文件属于现行版本」这件事,还欠一位记账人——下一节请出 Manifest。