5.1 Compaction 基础
5.1 Compaction 基础:搬运的机制账
本节摘要:压缩是 LSM 引擎里唯一同时动三本放大账的机制:它搬运字节(写放大)、重塑文件布局(读放大)、清退旧版本(空间放大)。本节先把压缩与刷盘两个工种划清边界,再盘点三类触发条件,然后钻进一次归并的内部——归并堆怎么裁决版本、墓碑何时可以销账、输出文件如何重建索引与过滤器,最后给出观测一次压缩任务成本的核心指标。
先把两个工种分清
很多事故的第一步误诊,是把刷盘和压缩当成同一件事。它们在账本上是两个独立工种。刷盘是泄洪闸:内存表写满,整体冻结,顺序写出为一个零层文件,目标单一——把内存腾出来,让写入不停摆。它只追加新版本,不解释、不取舍,一个旧值都不碰。压缩是新陈代谢:它响应的不是某个单点事件,而是文件分布的系统性失衡——零层文件堆多了、某一层容量超了、某片键区间的墓碑密度太高了。它做的事情带着判断:归并、去重、裁剪版本、清退墓碑,输出的是「编辑过」的数据。
划清边界的意义在排错:刷盘积压看内存水位和刷盘线程,压缩积压看待压缩字节和压缩线程,两套指标、两套药方。混为一谈的结果通常是给刷盘加线程治压缩的病,钱花了账不平。
触发的三种来源
压缩任务从哪里来?按账目压力分三类。第一类是文件数触发:零层文件数达到阈值(常见默认为四个)就触发零层向一层的归并;这是最频繁、优先级最高的一类,因为它直接卡着读路径——零层文件越多,点查要翻的文件越多。第二类是容量触发:每一层有个目标容量,第一层常配二百多兆,往下每层十倍递增;某层实际大小超过目标,就挑文件往下归并,直到账目归位。第三类是时间与指令触发:给数据设置存活期,到期由压缩顺手清理;或者由运维主动发起手动压缩——批量导入完成后整库整理一遍,就是典型用法。
触发之外还要记账优先级。不是所有待压任务生而平等:卡着写入咽喉的零层积压,紧急度远高于某层略超容量;墓碑密集的老文件,整理价值高于几乎全是有效数据的紧凑文件。引擎内部的选件逻辑就是一套评分器,综合层级压力、文件年龄、重叠程度给候选任务排序,把最高分的送进执行队列。理解这一点,才能看懂监控里压缩任务的排序为什么「不按先来后到」。
一次归并的内部流水线
选定了输入文件,归并正式开工。内部流程分四步,每一步都有账目含义。
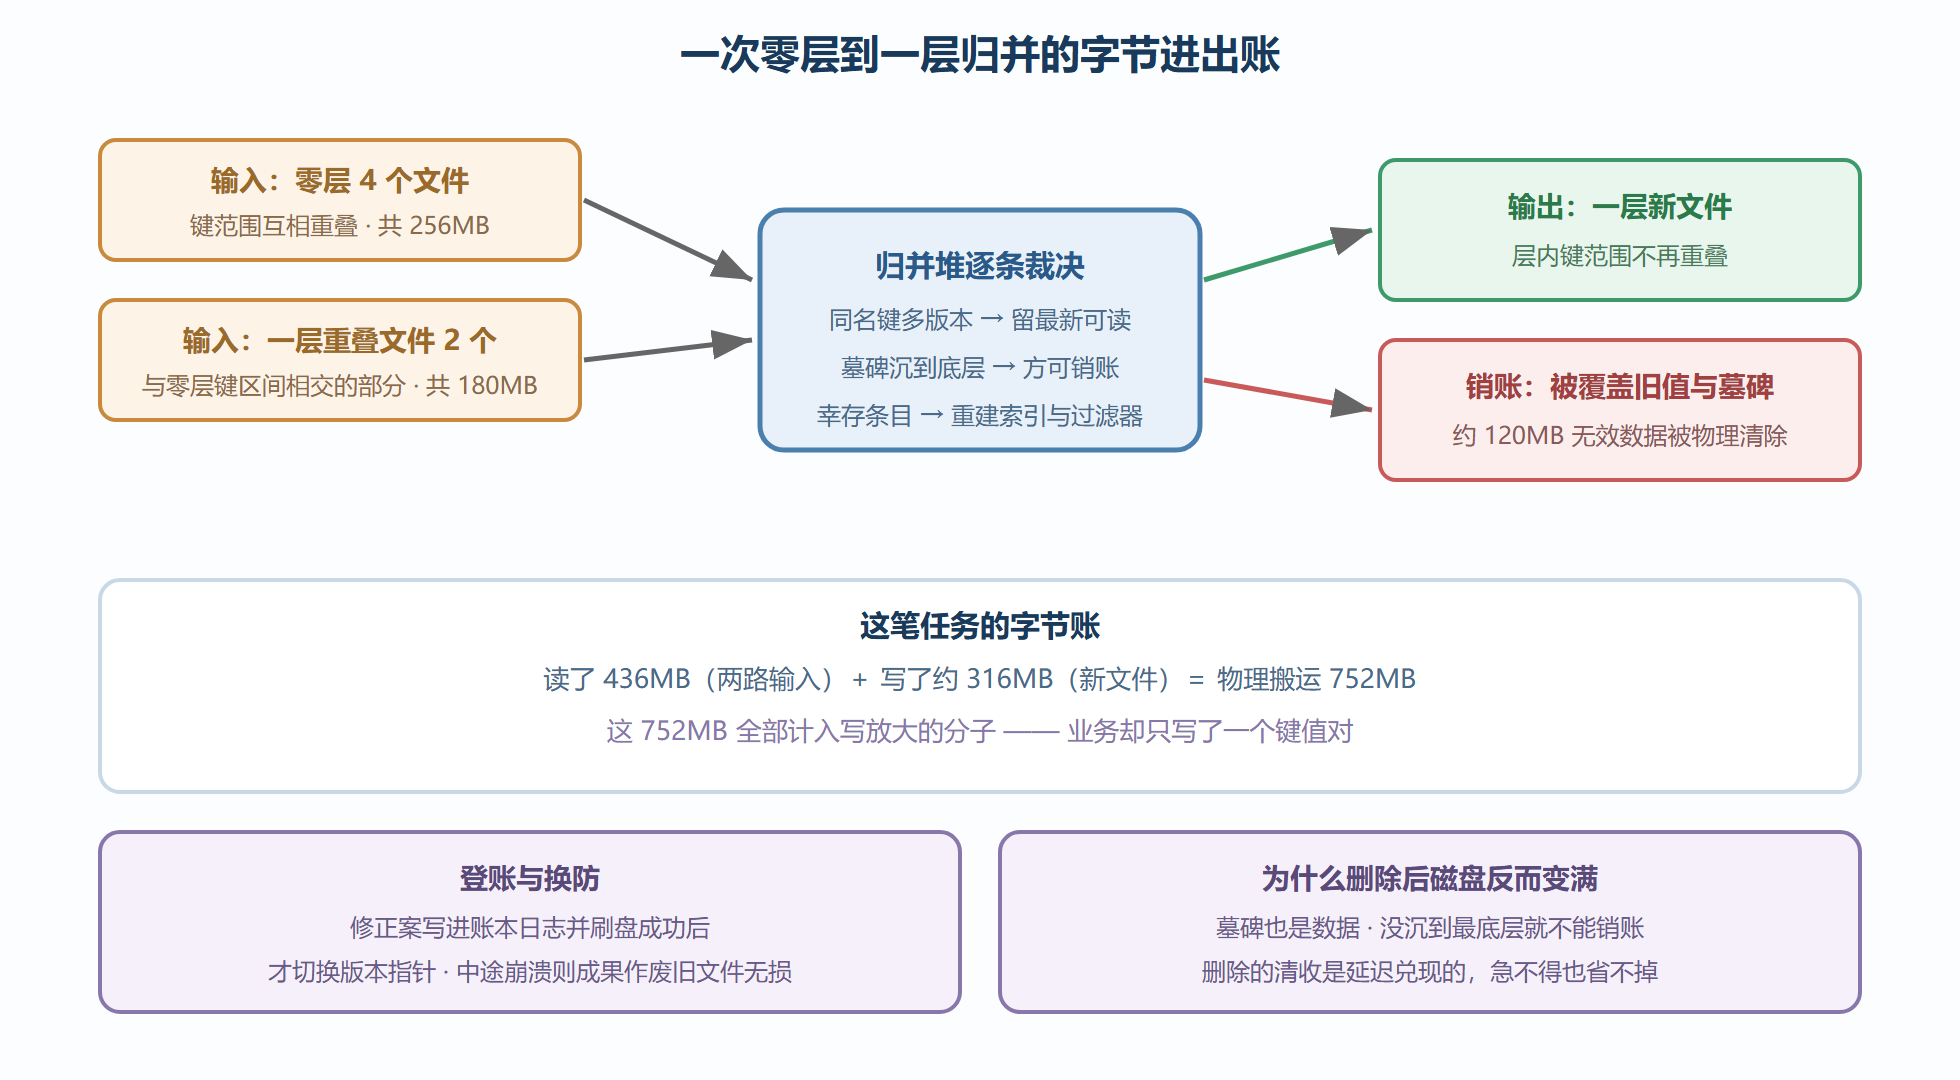
第一步,建归并堆。所有输入文件各出一个子迭代器,连同尚在内存的数据一起挂进一个小顶堆,按内部键排序——用户键相同的条目再按序列号从新到旧排。堆顶永远是全局最小的待处理条目。
第二步,逐条裁决。弹出堆顶,按类型分账:同一用户键若堆里有多个版本,只保留快照语义允许的最新可读版本,其余直接丢弃——这是空间放大被清收的核心动作;若弹出的条目是墓碑,引擎要判断它是否已经压到「最底层、且更深层不可能再藏有该键的旧版本」,条件满足才算销账完成,墓碑本身也不再输出;条件不满足,墓碑还得继续往下传,因为它下层可能还有旧值等着它去覆盖。这一步解释了一个反直觉的现象:删除一个键之后磁盘占用不降反升——墓碑也是数据,它要一路沉底才能完成使命。
第三步,写输出文件。幸存的条目按顺序写入新文件,写的过程中同步重建三样东西:数据块、索引块、布隆过滤器位图。第 4 章读路径用到的三级跳转与过滤器折扣券,就是在这里重新制作的。输出端还有一个可插拔的环节是压缩编码——新文件用什么算法压缩、每层用不用不同算法,都在这里落账,这是空间账与 CPU 账的交换点。
第四步,原子登账。归并完成后,引擎把「删了哪些旧文件、加了哪些新文件」打包成一条修正案写进账本日志并刷盘,成功后才切换内存里的当前版本指针。第 3 章讲的版本管理在这里兑现承诺:压缩中途崩溃,未登账的成果作废,旧文件毫发无损,重启后从账本末尾恢复一致状态。压缩可以失败重来,账本不能半截。
图5-1 一次归并的字节进出账
怎么观测一次压缩的成本
机制讲清了,落回账面。评估压缩系统健康度,盯四个指标就够用。待压缩字节:积压池的水位,长期非零说明消化速度跟不上生产速度,是停顿的前兆。压缩写入字节与业务写入字节之比:这就是写放大的实测口径,倍数越高说明同一笔数据被搬运的次数越多。零层文件数:读路径的咽喉指标,长期高于触发阈值说明零层向一层的管道堵了。压缩停顿与降速计数:三道闸门的动作记录,出现即说明引擎已经开始刹车。这四个数按顺序看一遍,压缩侧的问题基本能定位到段落;下一节的三种策略,本质上就是给这四个数设计的三种不同的「正常的形状」。
零层向一层:最繁忙的一条管道
所有压缩路径里,零层向一层的这条值得单独一段:它是整个压缩系统里最繁忙、也最容易堵的一段。繁忙是因为每一次刷盘的产物都要从这里过;容易堵是因为它的输入形状天生不友好——零层文件键范围互相重叠,归并时几乎要全量参与,输入永远比输出大。
管道的治理有两个旋钮、一个观察点。旋钮一是触发阈值:默认四个文件触发一次归并,调低让单次归并的输入更小更快、但归并更频繁;调高则攒一把大的、摊薄调度开销,代价是零层停留的文件更多、点查翻的文件更多。旋钮二是写缓冲大小:它决定每个零层文件的体量——文件越小,单次归并越轻,但刷盘越勤。两个旋钮实际上在共同调节同一条曲线:单次归并的成本与归并的频率。观察点是归并后一层的容量变化——一层是「十倍递增」层级体系的底座,它吃不下就会把积压往上传。第 8 章讲参数联动时说的「零层阈值随写缓冲容量一起审视」,根子就在这条管道的水力平衡上。给这条管道定的健康标准很朴素:零层在触发线以下停留的时间越短越好,归并排队能在秒级消化就是及格。
本节要点
-
机制账看懂了,第 5.4 节的排错实录里每个数字都能对号入座;
-
刷盘是泄洪闸只管腾内存,压缩是新陈代谢管三本放大账,两套指标两套药方别混诊;
-
触发三来源:零层文件数管读路径咽喉,层级容量管空间秩序,时间与手动指令管业务节奏;
-
归并四步:建堆、逐条裁决、写输出重建索引、原子登账,崩溃安全靠的是账本先行的老规矩;
-
墓碑沉底才能销账,删除的清收是延迟兑现的——删除高峰后磁盘变满是机制使然不是泄漏;
-
观测压缩健康度盯四数:待压字节、搬运比、零层文件数、停顿计数。