9.1 持久化与恢复
9.1 持久化与恢复:把抢救变成重放
本节摘要:持久化不是「写了盘就安全」一句话,而是两条轨道的精密分工:日志轨道高频强同步,保崩溃瞬间的完整;文件轨道异步批量,保长期存储的效率。本节讲清双轨制如何靠序列号对账、检查点如何凝出可迁移快照、恢复四阶段如何把灾难做成按图施工的重放,最后给一套持久化承诺的选价方法。
双轨制:一份借据与一笔资产
把持久化拆成两本账看。第一本是日志账:每次写入先序列化成一条日志记录,按写入选项的要求决定是否等到介质确认才返回。同步模式下,这一笔是「借据」——进程下一毫秒崩溃,借据仍在,恢复时照单重放;异步模式下,借据可能在内核缓冲里滞留几毫秒,代价是断电时丢最近的一小段。第二本是文件账:内存表冻结后异步刷成磁盘文件,排序、压缩、校验一步到位,这是真正的「资产」——有序、紧凑、可高效查询。
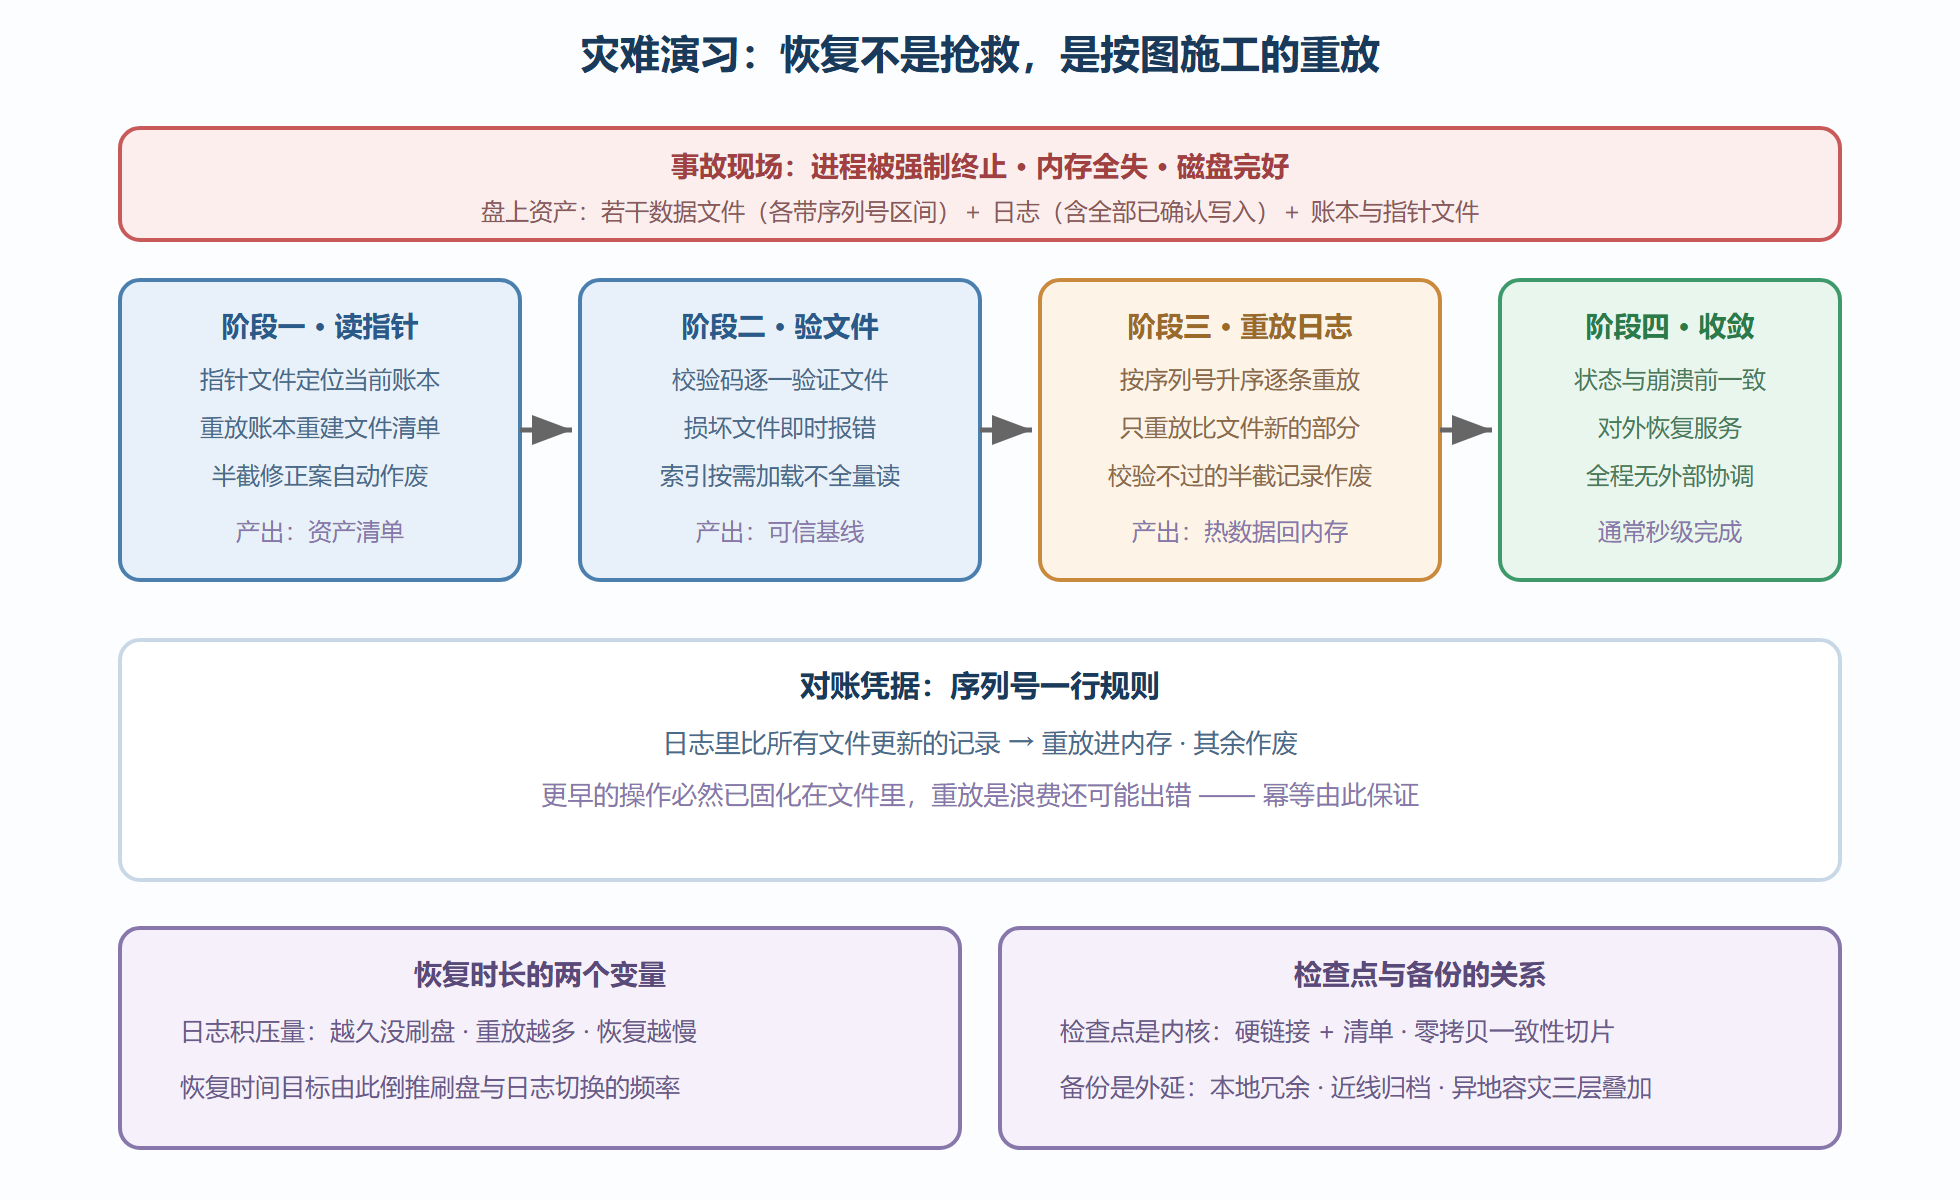
两本账的分工在第 2 章已立:日志保崩溃瞬间,文件保长期归宿。本节补上它们之间的对账凭据——序列号。每条日志、每个文件都带着序列号区间,恢复时的对账规则因此只有一行:日志里比文件更新的部分重放,其余全部作废。 更早的操作必然已固化在某个文件里,重放它们不仅浪费还会出错——序列号比较天然保证了重放的幂等。
还有一个容易忽略的配角:文件的诞生是原子的。新文件先写到临时名,全部落盘后才一步改名为正式名——改名在文件系统里是原子操作,外部观察者要么看到完整的旧状态、要么看到完整的新文件,绝无半截。元数据的切换同样走「先记账、后生效」的路子,这一切合起来,才撑得起「崩溃后账目不乱」的承诺。
检查点:一份硬链接的目录树
运行中的库怎么备份?直接拷目录不行——文件在变、账本在动,拷出来的是一锅夹生饭。检查点接口给出标准答案,它做的事比「拷贝」聪明得多:先领一个当前序列号刻度,筛出刻度之下的全部有效文件,然后不复制数据,只建硬链接——同一份物理文件在备份目录里多了一个名字,零拷贝开销;再导出一份只有清单不含数据的元数据文件。产物是一个自包含、可移植、与原实例解耦的目录树,体积只有原库的百分之几,却拥有与原库在该刻度完全等价的逻辑视图,可以被当作新库直接打开。
检查点与备份的关系是一句话:检查点是内核,备份是外延。生产级的备份管道都是拿检查点当起点,再叠加三道工序——本地冗余(防单盘故障)、近线归档(打包加密传对象存储)、异地容灾(跨区域复制)。引擎故意不内置这套编排,把管道留给使用者按自己的基础设施拼装;它只负责把最难的「一致性切片」这一步做稳。
图9-1 灾难演习:从崩溃到就绪的四阶段重放
恢复四阶段:按图施工
灾难真的降临——进程被强制终止、内存全失、磁盘完好。恢复流程四阶段,每阶段产物明确。
阶段一,读指针定位账本:指针文件指向当前生效的账本日志,重放账本重建出「有哪些文件、在哪些层、各覆盖什么序列号区间」的完整清单;半截的修正案(崩溃时没写完的)因校验不过自动作废,第 3 章的原子登账在这里兑付。阶段二,验证文件:逐个校验码核实文件完整性,损坏即时报错而不是带病上线;索引按需加载,恢复速度与数据总量呈亚线性关系。阶段三,重放日志:按序列号升序处理日志记录,只重放比全部文件更新的部分,校验不过的半截记录(崩溃时没写完整的)自动截断——重放完成,崩溃前最后一批热数据回到内存。阶段四,收敛就绪:状态与崩溃时刻一致,对外恢复服务。全程没有任何外部协调者参与,正确性完全由本地文件语义与序列号规则保证。
恢复要多久?取决于一个可以自己控制的变量:日志积压量。日志越久没固化成文件、切换得越少,重放的部分越大,恢复越慢。有明确恢复时间目标的业务,应该反过来推:恢复要在几分钟内完成,意味着日志积压不能超过多少,进而决定刷盘与日志切换的频率——恢复时间是买来的,用日常的刷盘开销买灾难时的重放时长。
持久化承诺的选价
最后把「持久化怎么配」的账算全。三个档位对应三种价格。第一档,完全异步:写入最快,代价是断电丢最近一小段——缓存类、可重建数据用得起。第二档,同步模式:每次写入等介质确认,延迟多付一次刷盘的钱,换来断电不丢已确认写——金融与交易类只能选它。第三档,批量手动同步:业务自己定批次,批次末尾统一刷一次——大多数业务的甜点位,把「持久」的粒度交给上层定义。
再叠加检查点的节奏:检查点不解决崩溃恢复(那是日志的事),解决「回到过去」与「搬去别处」。定期打检查点、检查点异地归档,这两条加上同步档位的日志,就是一套完整的数据保险方案——每一样都有明确的账单,按业务的丢失容忍度与恢复时间目标采购即可。
一次基于检查点的实例迁移实录
检查点的价值用一次真实迁移讲最清楚。场景:单机实例要搬到新硬件,数据量八百 GB,业务要求停机窗口不超过十分钟。
老方案是停机、拷贝全库、重启——拷贝八百 GB 远超窗口。检查点方案把流程改成三段:第一段,业务不停机,在源实例打检查点——硬链接秒级完成,得到一个自包含目录;第二段,不停机,把检查点目录整体同步到新机,耗时与停机无关;第三段,停机窗口内只做两件事——源实例停止写入、对新产生的增量再打一次检查点并同步。增量往往只有几个 GB,同步几分钟内完成,新机打开检查点目录对外服务。窗口实际用时六分钟。
这场迁移的账目要点:停机窗口的成本集中在「增量再同步」这一步,而增量大小取决于两次检查点之间源库新增的数据量——窗口前把批量任务停掉、让增量收窄,是流程里唯一需要动脑的地方。另外两处细节值得抄走:检查点目录同步用支持硬链接语义的拷贝方式,否则硬链接退化成全拷贝;新机首次打开后立即跑一次全库校验,确认迁移完整性再切流量。
恢复演练:把「应该没问题」变成「演练过没问题」
保险柜的最后一课是演练。恢复流程写过再多文档,没演练过就等于没验证——日志积压比预期大、校验发现坏文件、指针文件悬空,这些意外只会在真演练里露头。演练的标准动作是每季度随机挑一个备份检查点,在隔离环境走完恢复四阶段并全库校验,记录恢复耗时与数据量。耗时曲线连续几个季度平稳,恢复时间目标才算真正立住;哪一季曲线抬头,往往是日志积压或文件数量在悄悄恶化——演练报告同时兼任一份引擎健康度的体检单。
本节要点
- 持久化双轨制:日志轨道高频同步保瞬间,文件轨道异步批量保归宿,序列号是两轨对账凭据;
- 恢复规则一行:只重放比文件更新的日志,幂等自动保证;文件诞生靠改名原子性,账本靠先记账后生效;
- 恢复四阶段:读指针、验文件、重放日志、收敛就绪,全程无外部协调,通常秒级;
- 检查点是硬链接加清单的零拷贝切片,备份管道拿它当内核,叠加本地、近线、异地三层;
- 持久化三档位按丢失容忍度采购;恢复时长由日志积压决定,恢复时间目标是倒推配置的起点。