10.1 主流集成与应用
10.1 主流集成与应用:它藏在哪里,替谁扛活
本节摘要:它无处不在,因为它从不露面——没有端口、没有查询语言、不抢任何聚光灯。本节按集成深度画一张三层生态版图:外挂式把它当存储后端,融合式把它嵌进共识协议的日志链路,内生式把它编进计算框架的核心循环。每一层讲清它替上层扛了什么、上层让渡了什么,最后回答那个选型必问的问题:为什么是它。
先看它藏在哪里
找到它的最快方式不是找它,是找它的宿主。翻开几个你大概率每天都在用的系统:某关系型数据库的另一个存储引擎、某分布式事务数据库的本地节点、某流计算框架的状态后端、某缓存系统的冷数据层、某搜索系统的实时索引——拆开看底座,同一个名字。这个现象本身就是审计结论的第一行:它不是一款产品,是一种公共能力。谁需要「进程内、单机、高吞吐、崩溃安全」的键值存储,谁就可能成为它的宿主。
集成深浅不一,按深度分三层看。
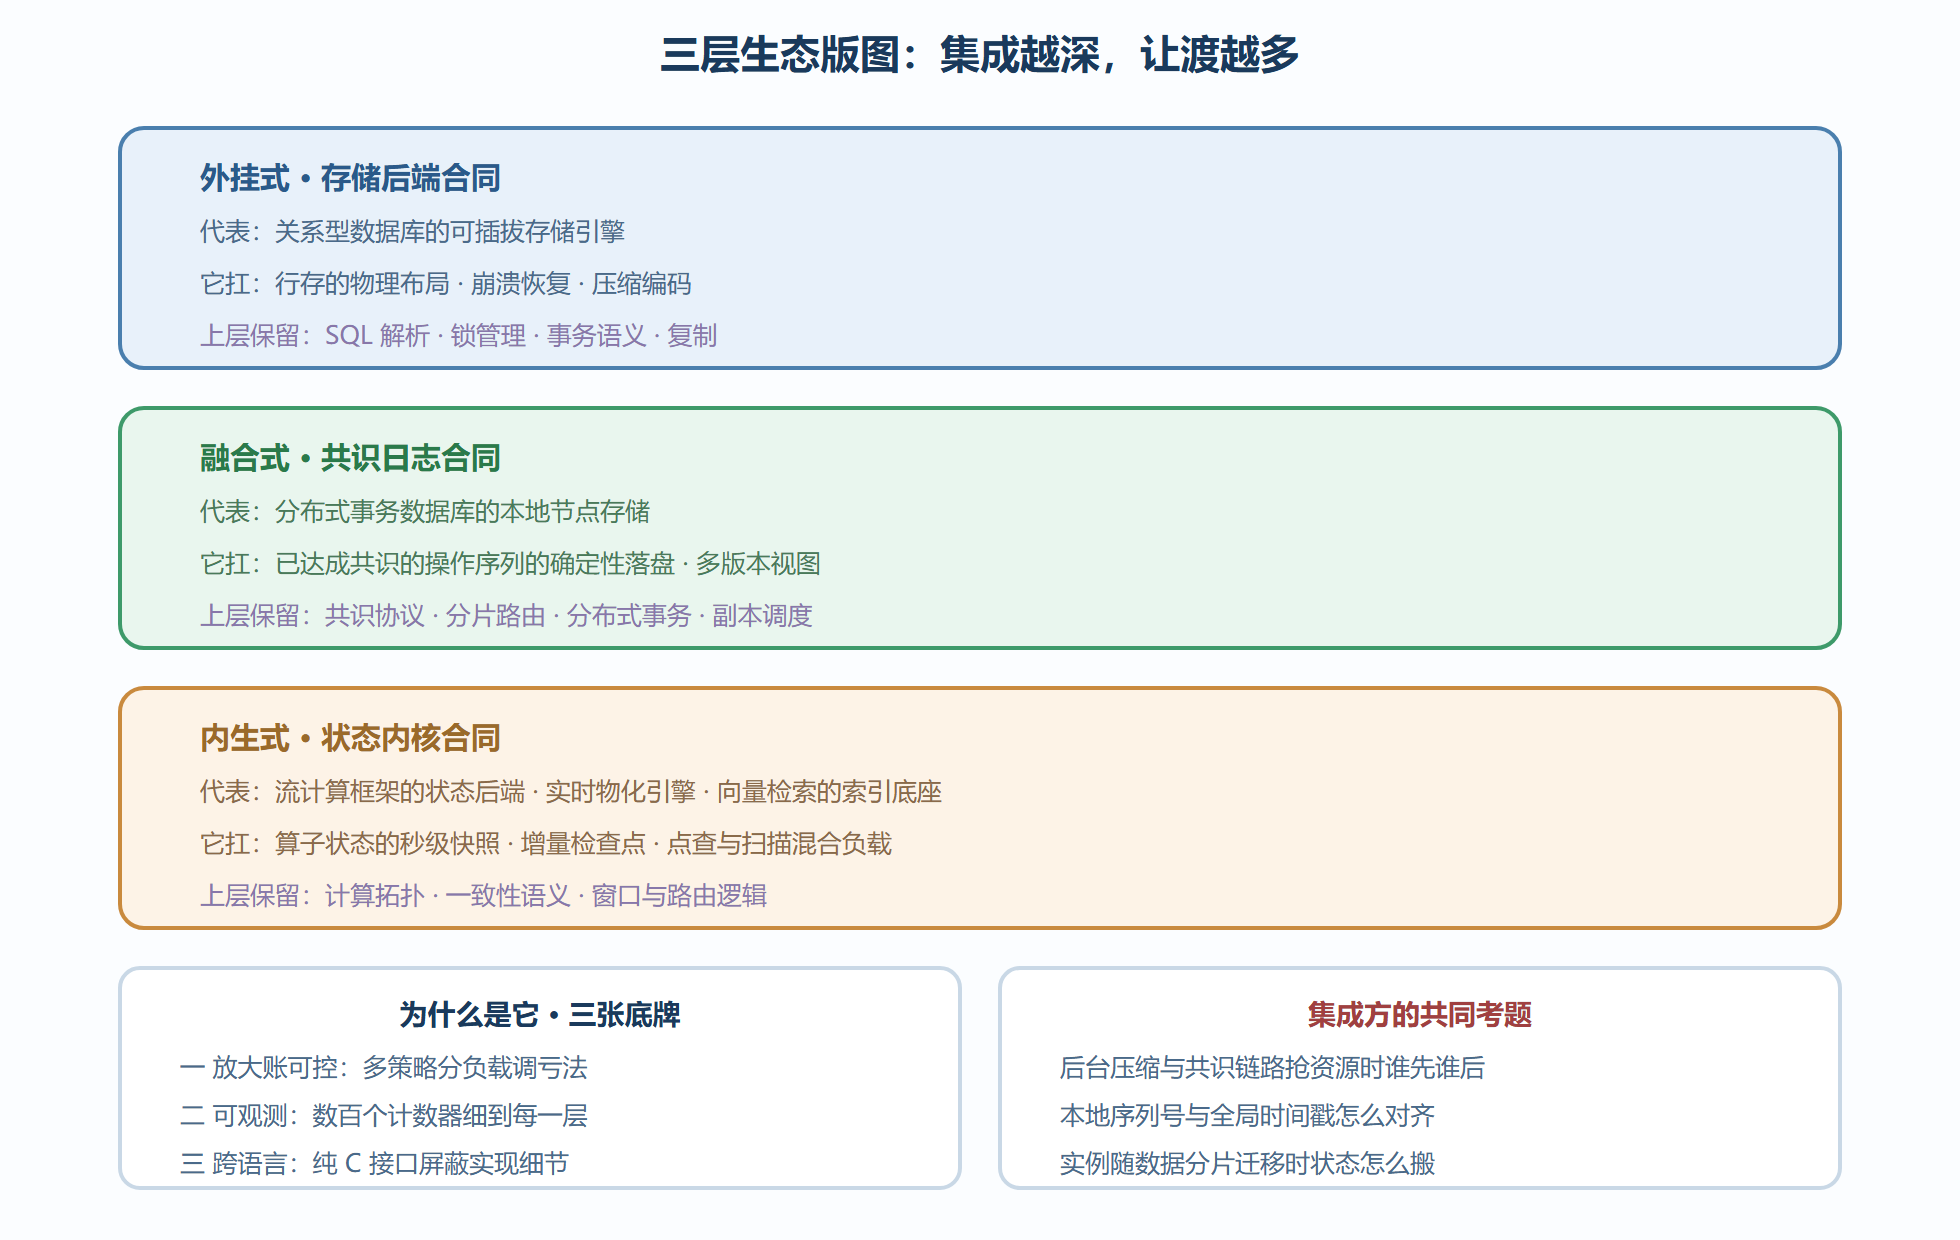
图10-1 三层生态版图:同一底座,四种合同
三层合同各管什么
外挂层是浅嵌入:上层是个完整数据库,只在存储引擎接口处换芯。它扛的是物理层——数据怎么编码成文件、崩溃后怎么恢复、磁盘上怎么压缩省空间;事务语义、锁、复制一概留在上层。集成方的收益立竿见影:写吞吐与压缩率换掉旧引擎后普遍立竿见影,尤其海量小更新场景下随机写瓶颈被顺序写替代。代价是语义对齐——上层的事务标记与本地日志必须严格绑定,恢复逻辑要跨两层对账,这正是第 9 章持久化规则在集成场景下的延伸考题。
融合层是深嵌入:上层是共识协议驱动的分布式系统,每个本地节点用它落盘「已经多数派确认的操作序列」。关键分工一句话:共识算法解决顺序,它解决顺序的确定性持久化。已提交的日志条目按序写入,多版本快照直接服务上层的一致性读。集成方要做的考题是把本地序列号与全局时间戳对齐、把后台压缩对共识链路的干扰隔开(限速器在这里是标配而非可选项)。
内生层是编织:计算框架的核心循环直接调用它的批量写、迭代器、快照。流计算的状态后端是典型——每个算子的状态放进去,秒级快照靠检查点切片,实例随数据分片迁移靠检查点搬运。这一层里,第 9 章的合并算子被大量复用:窗口聚合、计数器、会话状态,都是「追加操作、后台折叠」的范式。
选型问答:为什么是它
生态地位反过来就是选型依据。若你的问题同样是「进程内需要一个可靠的键值底座」,对照它手里的三张底牌做判断。
第一张,放大账可控:三种压缩策略分负载调亏、参数空间足够把三本账调到你的偏好——这一点在全书反复论证过。第二张,可观测性:数百个计数器细到每一层、每一步,出问题时它是少数能把「黑盒变白盒」的底座——第 5.4 节的排错实录依赖的就是这份细度。第三张,跨语言友好:纯 C 接口把实现细节全部屏蔽,各语言生态都能安全地把它嵌进自己的运行时——这是它成为公共底座而非单语言库的关键一步。
同样要记它的边界:单机引擎,分布式语义全部靠上层;没有二级索引,需要就要在键设计里自己做;值太大要靠值分离或外置存储。选型时把这三条边界写进评审记录,能省掉日后一半的「为什么不」。
三种集成各自的排错视角
集成深度不同,出问题时看的方向也不同,这是生态版图对运维者的实际意义。外挂式集成里,引擎的异常先表现为上层的慢查询,要往下钻一层才见真相——引擎指标与上层的执行计划要对齐着看;融合式集成里,异常常在共识与存储的接缝处——本地落盘的延迟直接拖累共识链路的心跳,限速器与队列深度的联动是第一现场;内生式集成里,引擎的停顿直接化成计算的背压,反压信号与压缩积压的对应关系是排查主轴。三种视角的共同点:越深的集成,越要求双方指标在同一条时间轴上对齐——跨层指标关联是集成运维的基本功,孤立看任何一侧都会误诊。
自建还是复用:一场推演
站在选型会上,「我们也需要一个本地键值底座」时该自建还是复用?把双方的账摆开。复用方省下的是三大件:崩溃恢复的正确性(十年事故换来的)、性能底盘(参数空间与压缩策略)、可观测体系(数百计数器);付出的是依赖治理——跟进版本、理解机制,本书的全部篇幅就是这个成本。自建方省下依赖成本,付出的是把三大件重做一遍——尤其崩溃恢复的正确性,几乎不可能用短平快的方式验证,那是真实故障逐年喂出来的肌肉记忆。推演的结论几乎注定:只要需求是「可靠的单机键值底座」而非「研究项目」,复用是账面占优的一侧;自建的理由只剩极端定制或受限环境——而那些场景里,第 9 章的扩展点往往已经够用。
版图上的一类新邻居
近年版图上多了一类值得关注的宿主:以引擎为状态层的机器学习基础设施。训练管道把样本与特征快照放进本地实例,推理服务把特征查询做成点查热路径——这类负载的账目特征是「读多、值大、批次重」,恰好落在本书记过的三组机制的交点上:值分离管大特征向量,批量写管样本灌入,检查点管训练任务的断点续训。它印证了版图扩张的老规律:不是引擎去找负载,是负载长着长着就发现自己需要一个「进程内、崩溃安全、高吞吐」的底座。预测下一个邻居是谁没有意义,守住底座的三个必要条件——进程内、单机强持久、键值语义——比追逐名单有用。
与第 4 章边界画的呼应
第 4 章末尾画过引擎的边界:复制、分布式事务、分片三笔账属于上层。把那句话放到本章的版图上,正好是三种集成各自要解的题:外挂层用主从复制解复制账,融合层用共识协议同时解复制与事务账,内生层用计算框架的分片调度解分片账。两次落笔互相印证:引擎把单机账做到极致、把多机账全部让渡,不是能力不足,是分工自觉——边界画得越清楚,集成方的考题就越好答。
本节要点
-
复盘版图的正确姿势:先找宿主再谈能力,先看合同再看名单;
-
它是无处不在的公共底座,按集成深度分外挂、融合、内生三层,集成越深上层让渡越多;
-
外挂层合同是存储后端:它扛物理层,上层留事务与复制;代价是跨层恢复对账;
-
融合层合同是共识日志:共识定顺序、它定顺序的确定性落盘,限速器是标配;
-
内生层合同是状态内核:快照、检查点、合并算子被计算框架大量复用;
-
三张底牌是放大可控、可观测、跨语言;三条边界是单机、无二级索引、大值需外置。