8.1 HLSL 与 GLSL:语法差异对照
8.1 HLSL 与 GLSL:语法差异对照
本节摘要:两门语言的差异集中在四个层面——类型拼写、内置函数名、语义标注、资源声明,外加一处最阴险的矩阵内存布局。本节用"同一效果双方言实现"开路,给出完整的对照表,最后单独拆解矩阵布局陷阱。
学习目标
读完本节,你应当能够:把本教程的任意 GLSL 片段改写成可编译的 HLSL;识别 HLSL 代码里语义(semantic)与寄存器绑定的含义;解释列主序与行主序差异如何影响矩阵乘法顺序。
同一个三角形,两种写法
先看全貌。GLSL 侧是我们熟悉的第 3 章模板,HLSL 侧完成同样的事:
// GLSL:顶点 + 片元(复习用) #version 330 core layout (location = 0) in vec3 aPos; layout (location = 1) in vec2 aUv; uniform mat4 uMVP; out vec2 vUv; void main() { vUv = aUv; gl_Position = uMVP * vec4(aPos, 1.0); }
// HLSL:顶点着色器 cbuffer PerFrame : register(b0) { // 常量块:对应 GLSL 的 uniform 块 float4x4 uMVP; }; struct VSInput { float3 pos : POSITION; // 冒号后是"语义":告诉管线这个字段是什么 float2 uv : TEXCOORD0; }; struct VSOutput { float4 pos : SV_POSITION; // SV 前缀 = 系统值,参与固定功能 float2 uv : TEXCOORD0; }; VSOutput VSMain(VSInput input) { // 入口函数名自由,编译时指定 VSOutput o; o.pos = mul(uMVP, float4(input.pos, 1.0)); // mul:矩阵乘法必须显式调用 o.uv = input.uv; return o; }
// HLSL:片元着色器 Texture2D uTex : register(t0); // t 开头:纹理寄存器 SamplerState uSamp : register(s0); // s 开头:采样器独立声明 struct VSOutput { float4 pos : SV_POSITION; float2 uv : TEXCOORD0; }; float4 PSMain(VSOutput input) : SV_Target { return uTex.Sample(uSamp, input.uv); }
三处结构性差异一眼可见。其一,HLSL 没有内置的 gl_Position,输入输出全靠自定义结构体加语义标注;其二,资源绑定显式写进代码(register 槽位),不像 GLSL 靠 location 编号在外部指定;其三,纹理与采样器在 HLSL 里是两个独立对象,GLSL 则合并成 sampler2D。除此之外,控制流、函数、数学运算的写法几乎可以无脑互译。
图:双方言对照矩阵:四大差异层一览
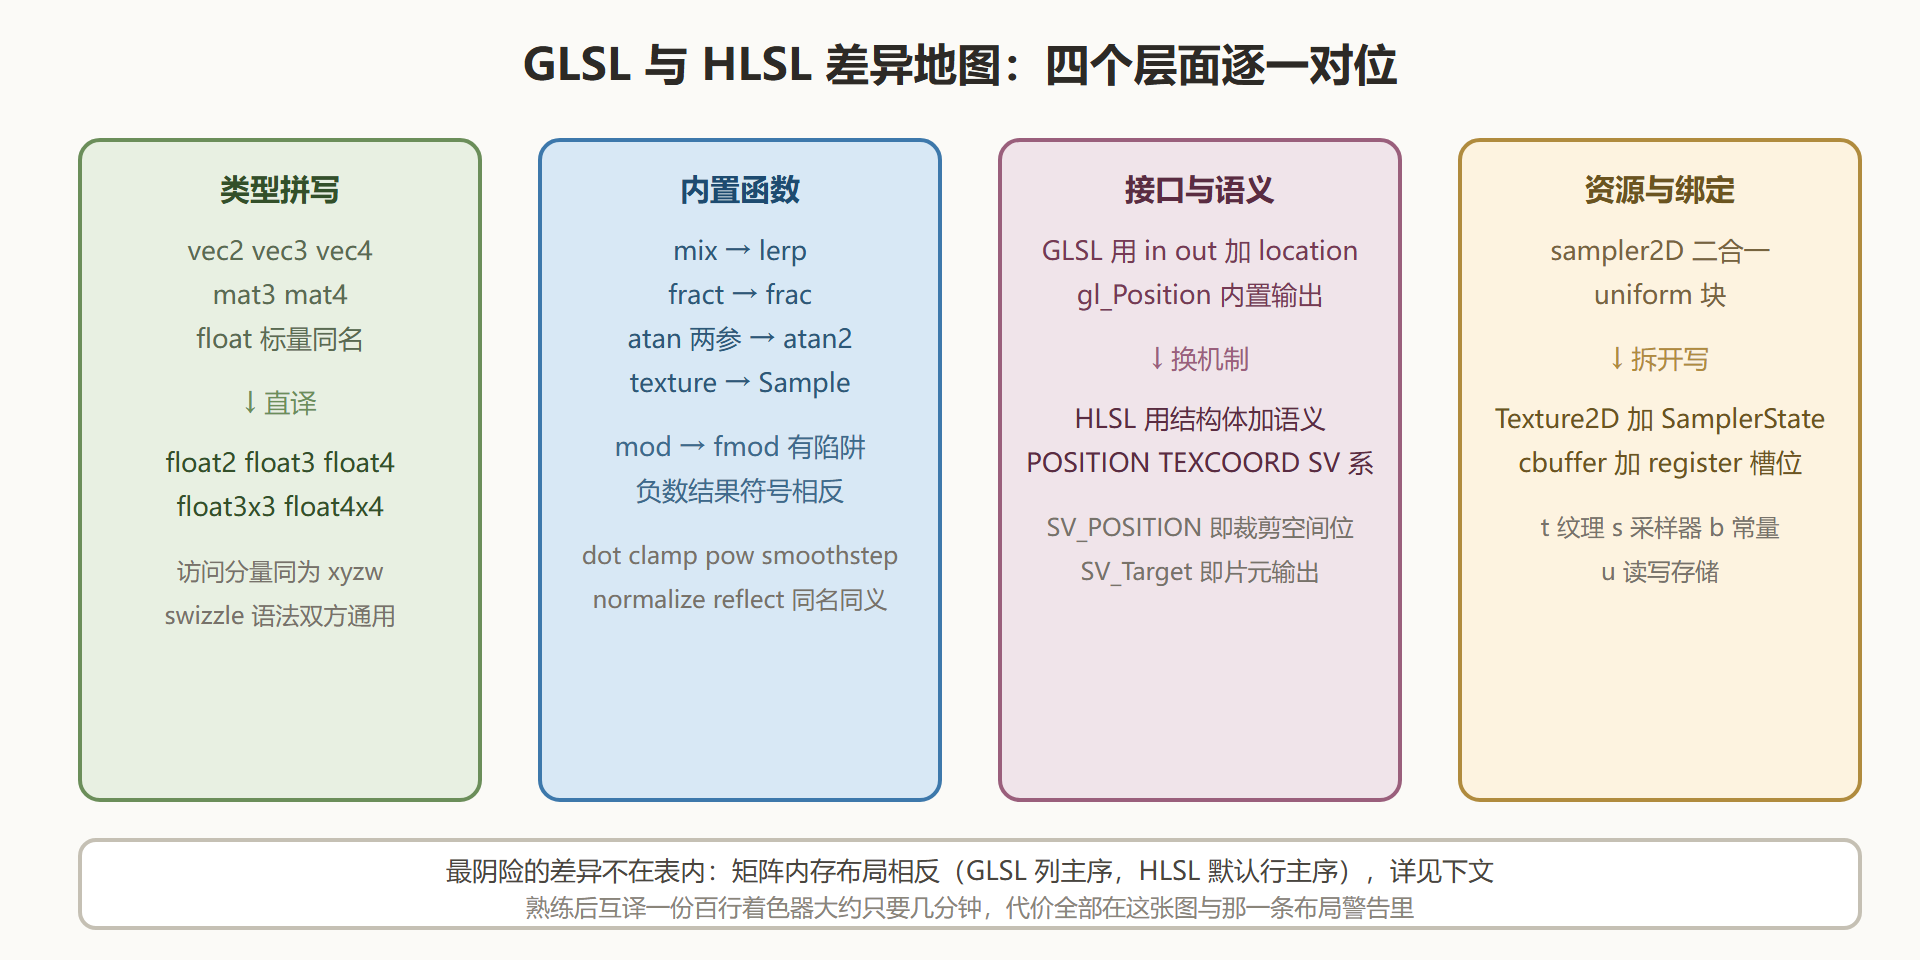
四大类映射速查
日常互译把这张表放在手边就够了:
| GLSL | HLSL | 备注 |
|---|---|---|
vec2/3/4、ivec、bvec |
float2/3/4、int、bool |
向量类型按分量数拼写 |
mat3、mat4 |
float3x3、float4x4 |
内存布局方向相反,见下文 |
mix(a,b,k) |
lerp(a,b,k) |
语义完全一致 |
fract(x) |
frac(x) |
同义 |
mod(x,y) |
fmod(x,y) |
负数行为相反,翻译时当心 |
atan(y,x) |
atan2(y,x) |
两参反正切 |
texture(s, uv) |
s.Sample(samp, uv) |
采样器作显式参数 |
textureLod(s,uv,l) |
s.SampleLevel(samp,uv,l) |
手动 mip 层 |
gl_Position |
SV_POSITION |
裁剪空间位置语义 |
gl_FragCoord |
片元 SV_Position 输入 |
片元侧可读的屏幕坐标 |
discard |
clip(-1) 或 discard |
clip 按标量条件裁剪 |
layout(location) 属性 |
语义 + 输入装配槽位 | 两套绑定体系 |
uniform 块 |
cbuffer + register(bN) |
常量缓冲 |
fmod 的差异值得单独点名:GLSL 的 mod(x, y) 结果与 y 同号(数学上更贴"取模"),HLSL 的 fmod 结果与 x 同号。UV 动画里出现负时间时,这一个差异就能让滚动方向凭空反转——典型的"编译通过、行为不对"。
矩阵布局:最阴险的差异
GLSL 按列主序存矩阵(第 2 章的构造器按列填充),HLSL 默认按行主序。同一块 GPU 内存,两边读出来的矩阵互为转置。转置矩阵乘向量的结果,等价于交换乘法顺序:
列主序:pos = mul(vec, mat) // GLSL 习惯 v * M 行主序:pos = mul(mat, vec) // HLSL 习惯 M * v
这解释了本节示例里 mul(uMVP, float4(input.pos, 1.0)) 的顺序——它与 GLSL 的 uMVP * vec4(aPos, 1.0) 恰好互为镜像。两条纪律保平安:其一,跨语言传矩阵时在 CPU 侧统一决定是否转置,一处负责,全程一致;其二,调试矩阵问题时第一个排查乘法顺序与转置状态,这是"模型消失"类故障的惯犯(第 3 章的排查口诀在此汇合)。
HLSL 也可以逐矩阵声明存储倾向(行主序或列主序修饰符),引擎级代码常用它把 HLSL 强扭成列主序,让 CPU 侧代码与 GLSL 路线共享——这是跨平台引擎的常见选择。
⚠️ 常见坑:把 GLSL 代码直译成 HLSL 后画面出现"整体错位或镜像"症状,八成是矩阵布局没统一。先查乘法顺序,再查转置,最后才怀疑矩阵内容。
本节要点回顾
- 四大差异层:类型拼写、内置函数名、语义标注、资源声明,逐层有对应表可查;
- 结构体加语义:HLSL 用自定义结构体贯穿阶段间数据流,SV 前缀标系统值;
- fmod 陷阱:负数取模符号相反,UV 动画翻译时的头号暗雷;
- 矩阵布局相反:列主序对行主序,乘法顺序互为镜像,CPU 侧统一转置策略;
- 寄存器显式化:register 槽位写进着色器代码,与 GLSL 的外部绑定哲学不同。
语言对照完成。下一节站到工具链高度:编译链、引擎集成与跨平台兜底策略。