6.1 优化器架构与连接顺序
6.1 优化器架构:连接顺序的搜索问题
本节摘要:SQLite 优化器分三段工作:重写、连接顺序搜索、计划生成。连接顺序是核心难题——N 张表的连接顺序有 N 的阶乘种,优化器必须在有限时间里裁剪这个空间。本节展示 SQLite 的搜索策略与剪枝手法,并对照 PostgreSQL 的动态规划与 MySQL 的贪心框架。
三段流水:重写、搜索、生成
优化器接手的是语义分析后的表达式树,产出的是字节码。中间三步:
- 重写阶段:子查询扁平化(把
IN (SELECT ...)与连接合并)、把 WHERE 谓词推进到最合适的查询块(下推)、把 HAVING 里有索引可用时转为 WHERE、常量传播。每一步的目标相同:给搜索阶段更多的候选路径。 - 连接顺序搜索:对 FROM 里的 N 个数据源(表或子查询),评估它们的排列与每种排列下每个表可用的访问路径,取总成本最低者。这是本章的主戏。
- 计划生成:把选中的顺序与路径翻译成 VDBE 指令——嵌套循环的外层到内层顺序、每层的游标操作、排序器与聚合器的装配。
阶乘爆炸与工程裁剪
四张表的连接顺序有 24 种,十张表有 362 万种,二十张表的排列数已经超过宇宙原子量级。所有优化器都必须裁剪,裁法各家不同:
| 策略 | SQLite | MySQL | PostgreSQL |
|---|---|---|---|
| 小规模 | 穷举全部顺序 | 穷举 | 动态规划(两两合并) |
| 大规模 | 启发式剪枝后搜索 | 贪心(超阈值只局部穷举) | 遗传查询优化(表数超阈值) |
| 搜索粒度 | 一次定全序 | 先定驱动表再逐层 | 自底向上合并等价类 |
| 左深或稠密 | 全序搜索,含 bushy 候选 | 左深为主 | 两者都考虑 |
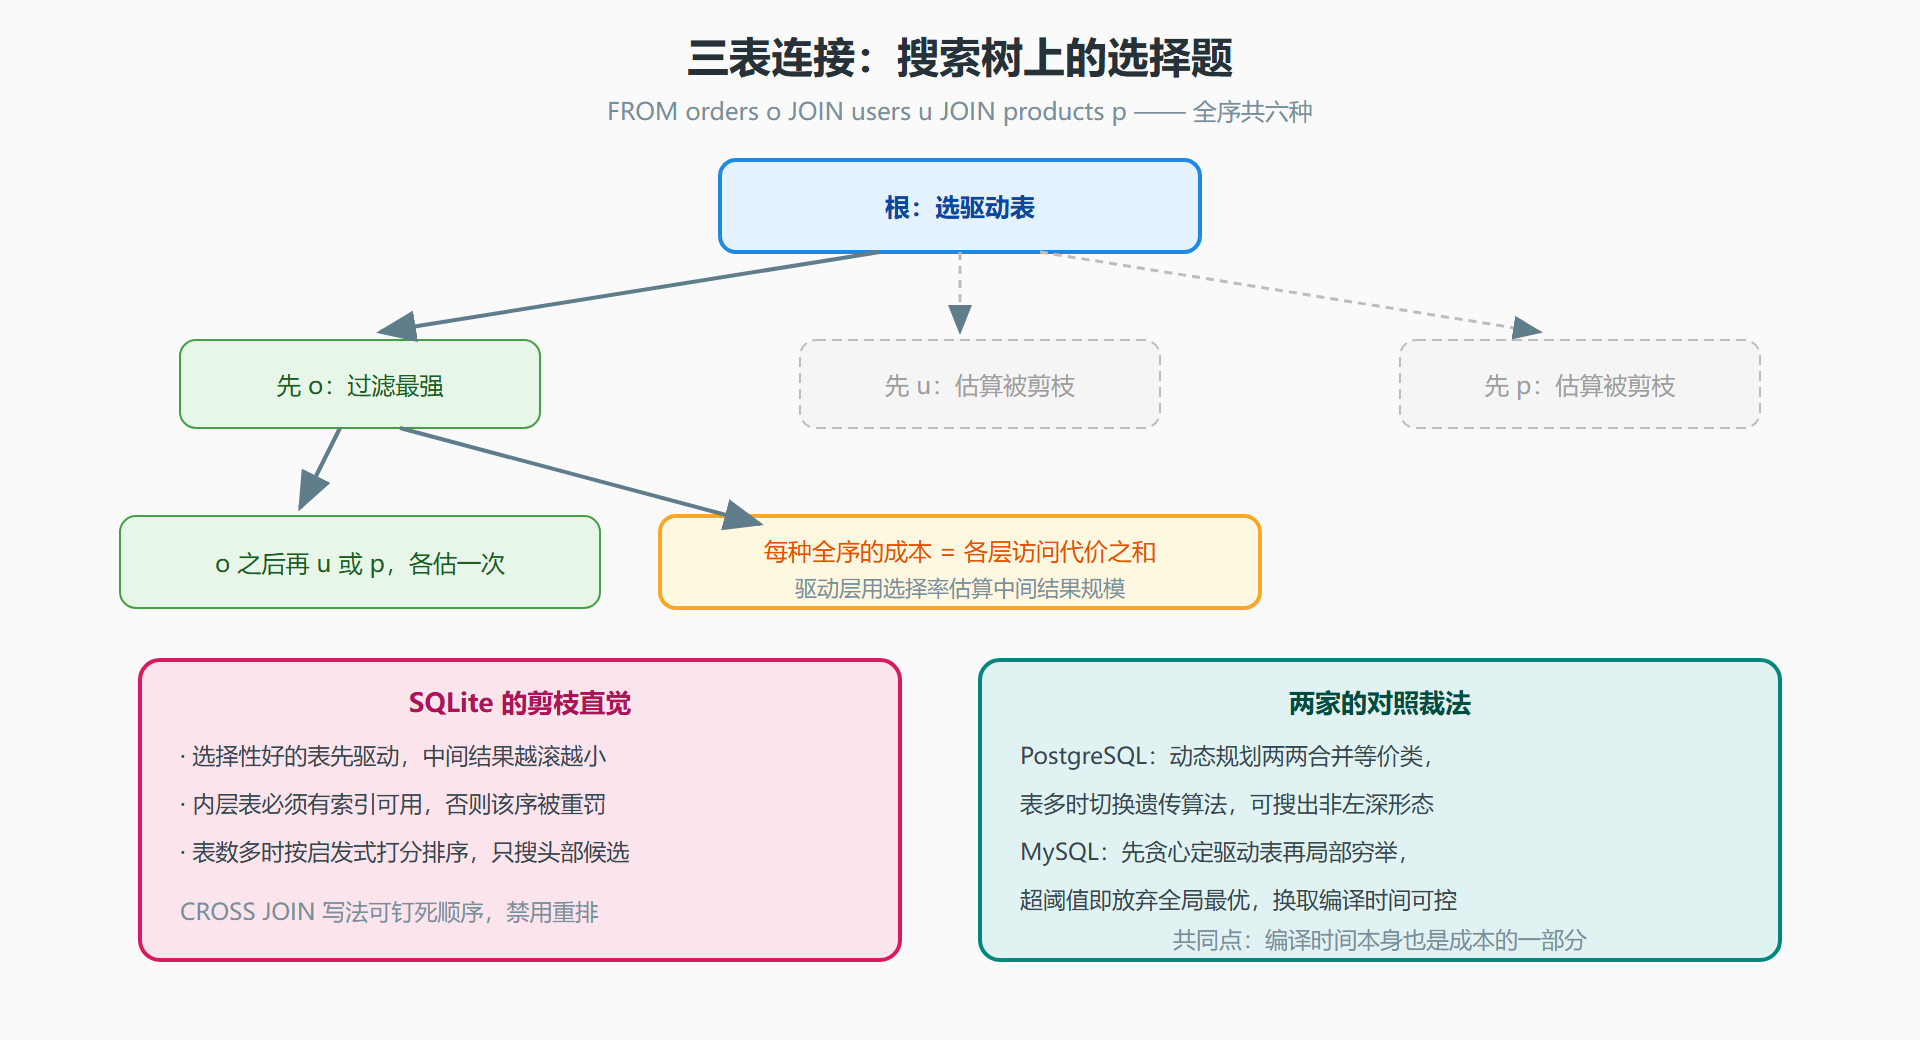
SQLite 的做法可以概括为"小题穷举、大题启发":表数不多时把可行顺序基本走完(内置上限防止失控),表多时按"哪个表过滤性最强就先驱动谁"的贪心直觉裁剪搜索树。这里有个工程上重要的结论:SQLite 对连接表数敏感,五六张表以内的连接它的搜索质量很稳;十几张表的长连接链,值得人工用 CROSS JOIN 语法(SQLite 里这是禁用优化器的强制顺序提示)把已知的优序钉死。
图:连接顺序的搜索树与剪枝
驱动表选择:一个可验证的例子
手工预判优化器的选择,用三张规模悬殊的表做实验:
-- users 50 行,orders 10 万行,order_items 100 万行 EXPLAIN QUERY PLAN SELECT u.name FROM order_items oi JOIN orders o ON oi.order_id = o.id JOIN users u ON o.user_id = u.id WHERE u.name = 'alice'; -- QUERY PLAN -- |--SEARCH u USING INDEX idx_users_name (name=?) -- |--SEARCH o USING INDEX idx_orders_user (user_id=?) -- |--SEARCH oi USING INDEX idx_items_order (order_id=?)
计划从 u 开始——不是因为 users 最小,而是因为 u.name = 'alice' 的选择率最强(预期命中 1 行),从它出发中间结果始终只有个位数。SQLite 把"每层之后中间结果的规模"乘进成本,选了这条滚雪球最慢的路径。若把 WHERE 换成 o.status = 1(命中五万行),驱动表立刻换成别的顺序——你可以亲手跑一遍观察这个翻转,比读源码更快建立直觉。
与重写阶段的配合
搜索质量的前提是重写阶段把查询整理成"可搜索"的形态。子查询扁平化是其中收益最大的一项:IN (SELECT id FROM t WHERE ...) 若不被转成连接,外层每行都要独立执行子查询;扁平化后它变成普通连接,进入连接顺序搜索的候选池。SQLite 在这里与另两家的分工不同——PostgreSQL 把子链接(sublink)提升做成独立的计划器步骤,MySQL 8.0 重写了半连接(semijoin)优化体系。判断你的查询有没有吃到这颗糖,看 EXPLAIN QUERY PLAN 里出现的是 SEARCH 加连接形态,还是 SUBQUERY 加 SCAN 形态——后者往往是性能悬崖的信号。
常见问题速答
**优化器选错了计划,第一步做什么?**按顺序问三个问题。统计新鲜吗——ANALYZE 跑过吗、跑完之后数据分布变过吗?查询形态友好吗——有没有本可扁平化的子查询、本可消除的排序?索引如预期存在吗——索引名拼写、复合索引列顺序是否与查询形态匹配。三个问题都排除后再谈"绕过优化器"(CROSS JOIN 钉顺序或 INDEXED BY 强制),绝大多数"选错"在第一问就解决了。
**CROSS JOIN 怎么就变成了强制顺序?**SQL 标准里 CROSS JOIN 与 INNER JOIN 的差别只是"没有 ON";SQLite 的优化器把这种差别当成开发者的声明——出现在 CROSS JOIN 两侧的表不参与连接顺序重排,严格按书写顺序连接。于是 FROM a CROSS JOIN b CROSS JOIN c 就是"必须 a 驱动 b 再驱动 c"。这是 SQLite 特有的约定(MySQL 与 PostgreSQL 不保证此行为),跨库 SQL 里不要依赖它,仅在 SQLite 项目里作为最后的顺序控制手段。用它时在 SQL 旁边加注释说明依据,半年后接手的同事会感谢你。
本节要点回顾
- 优化器三段:重写给搜索铺路,搜索在阶乘空间里裁剪,生成把选择翻译成字节码。
- SQLite 小题穷举、大题启发;表数超过六七张时考虑用 CROSS JOIN 钉死顺序。
- 驱动表由选择率决定,不是由表大小决定——从过滤最强的表出发,中间结果滚得最慢。
- 子查询扁平化是最值钱的重写;计划里出现 SUBQUERY 加 SCAN 常是性能悬崖。
**子查询扁平化有没有失败的可能?**有,且失败形态值得认识。外层查询带 LIMIT、内层带聚合、或子查询里有 DISTINCT 时,扁平化会改变语义(LIMIT 作用在连接后还是子查询上结果不同),优化器会保守地放弃改写保留子查询形态。此时的补偿手段是手工重写:把子查询的结果先物化进临时表,再让主查询与临时表连接——把优化器不敢做的事变成你的显式步骤,计划立即可控。
搜索给出了候选,谁来打分?下一节算成本模型的账。