4.1 事务模型与页级账本
4.1 事务模型:页级账本上的 ACID
本节摘要:SQLite 的事务单位不是行而是页。默认回滚日志模式下,任何一页在被改写之前,原页会先被整体抄进 journal 文件;提交点是把脏页刷进主文件的那一毫秒;崩溃恢复就是拿账本回放。本节完整走一遍这个流程,并解释原子性与持久性分别由哪一步保证。
从字节码看事务的骨架
用 EXPLAIN 看 BEGIN 与 COMMIT 涉及的指令,事务在虚拟机层面只有两个动作:
BEGIN; -- Deferred 开启,此刻不拿任何锁 UPDATE users SET name='A' WHERE id=1; COMMIT;
执行 UPDATE 的字节码里,除了第 3 章讲过的游标指令,会出现两条关键的账本指令:TableLock(延迟到第一次真正写页时才取写锁)与写路径上的 Savepoint/日志触发逻辑——实际名字随版本变化,但骨架不变:第一次有页要被覆盖之前,pager 自动进入记账状态。应用甚至可以完全不写 BEGIN:默认的自动提交模式下,每条写语句就是一个隐式事务,这也是新手性能问题的头号来源(一万条语句等于一万次提交)。
回滚日志怎么记账
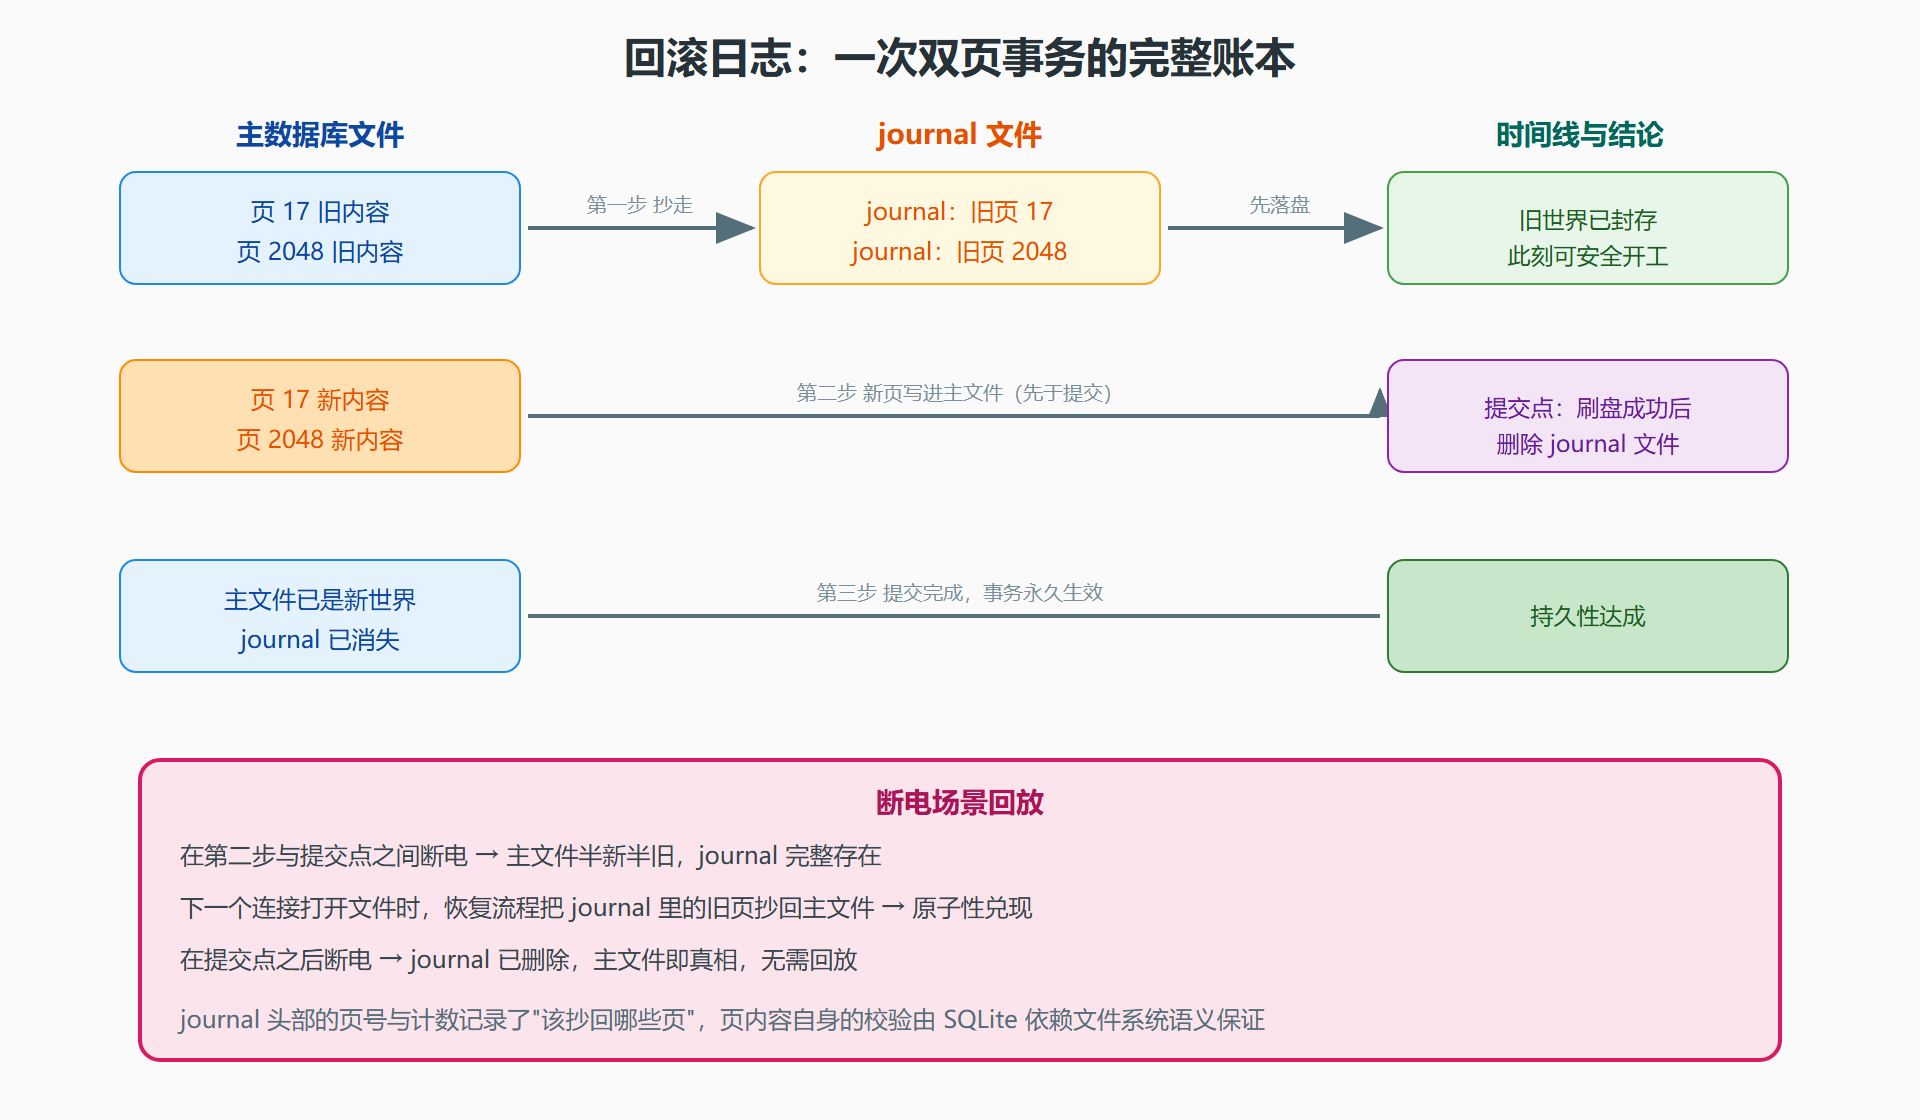
设事务要修改两个页(页 17 与页 2048)。回滚日志模式下发生的事情按时间顺序是:
- 取锁:从 RESERVED 锁升级到 EXCLUSIVE 锁的过程贯穿整个写事务(4.4 节展开锁状态机)。
- 抄旧页:把页 17 与页 2048 的原始内容(各 4096 字节)按序写入 journal 文件,并确保 journal 先落盘——这一步是原子性的根基:主文件还没动,旧世界已被封存。
- 写新页:把修改后的页写进主数据库文件的对应偏移。
- 提交点:按 synchronous 设置把主文件的变化刷到磁盘,然后删除或作废 journal 文件。journal 消失的那一刻,事务才算提交成功——这是全库最关键的一毫秒。
- 回放:若在第 4 步之前断电,重启后看到"主文件半新半旧、journal 完整存在",恢复流程把 journal 里的旧页抄回主文件,世界回到事务开始前。
图:回滚事务的页级账本
三笔重要的账
提交的真实成本。journal 模式下一次提交至少涉及两轮磁盘等待(journal 落盘、主文件落盘),机械盘上单次约几毫秒到十几毫秒。这解释了两个著名现象:不加事务的循环单条插入每秒只能做几百条(每条都要走完整账本流程);包进一个大事务后每秒能做几十万条(账本只走一次,后续写入都在页缓存里)。PRAGMA synchronous=NORMAL 可以省掉部分等待,换取断电时"最后几个事务可能回滚但库不会损坏"的保证——安全换速度的旋钮在第 7 章还会展开。
锁与日志的耦合。回滚模式下,写事务从第一个被改的页开始就阻塞所有读者——因为主文件正在被原地覆盖,读者读到一半的页可能是新旧混合的。这不是实现瑕疵而是回滚日志的结构性限制:旧世界只在 journal 里,主文件只有一个真相,谁都不能在覆盖时读它。WAL 模式正是为解开这个死结而生。
与另外两家的对照。InnoDB 的物理 redo 加逻辑 undo 双日志结构,提交只需 redo 落盘,旧版本留在 undo 里供 MVCC 使用——读写不互斥从结构上就是成立的。PostgreSQL 干脆不做原地覆盖,新版本直接写进堆页,旧版本留给 VACUUM。三个引擎的日志哲学排成一列:SQLite 把账记在"覆盖前",InnoDB 把账记在"覆盖时",PostgreSQL 不覆盖直接追加。第 4.3 节你会看到 WAL 把 SQLite 移到了中间位置。
SAVEPOINT:事务里的部分账本
完整账本之外,SQLite 还支持事务内的存档点,语义与三库通用:
BEGIN; UPDATE accounts SET balance = balance - 100 WHERE id = 1; SAVEPOINT before_transfer; UPDATE accounts SET balance = balance + 100 WHERE id = 2; -- 发现第二步有问题,只撤销它,保留第一步: ROLLBACK TO before_transfer; RELEASE before_transfer; -- 释放存档点,事务继续 COMMIT;
机制上,每个 SAVEPOINT 让 pager 在账本里多记一个"当前进度的书签",ROLLBACK TO 把指定书签之后的修改撤销。MySQL 与 PostgreSQL 的同名词法行为一致,跨库代码可以放心用。工程上它的价值在于长事务的分段容错:批量迁移脚本每处理一批打一个存档点,某一批失败只回滚该批,前面的成果仍在事务内——比"整事务重来"温和,比"拆成多个独立事务"更安全(整体原子性仍由最外层 BEGIN 与 COMMIT 保证)。
常见问题速答
**事务能不能无限大?**能,但要付三笔钱。页缓存要装下事务的脏页(超出预算的脏页会 spill 到 journal 或 WAL,写放大出现);回滚模式的 journal 或 WAL 模式的 WAL 文件会随事务变大;崩溃后的恢复时间与事务大小成正比——超大事务中断后,恢复要回放或清理的账本同样巨大。第 7 章的"分块提交"策略就是这三笔钱的平衡术。
**只读查询需要 BEGIN 吗?**WAL 模式下值得。不显式 BEGIN 时,一条查询自带隐式事务,两条连续查询之间世界可能已变(读到两个不同的快照)。把多条只读查询包进 BEGIN; ... COMMIT; 可以锁定同一个快照,保证组内读一致性——这是 WAL 模式送出的免费礼物,回滚模式下没有这个意义(读本来就互斥于写)。
本节要点回顾
- 事务的记账单位是页:覆盖前先抄 journal,提交点是"journal 被删除"的那一刻。
- 崩溃恢复 = 用 journal 回放旧页,原子性由"先封存旧世界再动手"保证。
- 自动提交模式下每条写语句一个事务,批量写入必须显式包进大事务。
- 回滚模式下写事务阻塞读,是主文件单真相的结构性限制,不是锁实现的问题。
**隐式事务的行为可以改吗?**可以,而且是个少有人知的旋钮。PRAGMA journal_mode 之外还有一个与事务行为相关的老参数:把多条写语句包进显式 BEGIN 是标准做法,但有些框架会替你自动加 BEGIN——行为不同版本有差异,部署前用 .log 或语句回调确认框架的实际行为,别靠文档想象。另一个相关习惯:只读连接不写就不产生事务开销,把读写连接分开(8.4 节的连接纪律)天然规避了隐式事务的意外成本。