5.1 测试金字塔与各层配比实操
5.1 测试金字塔与各层配比实操
本节摘要:单元测试不是测试的全部——它是金字塔的宽底座,上面还有集成层与端到端层,三层各答各的问题。本节讲清各层职责边界、数量级配比与失效模式,给出把三层放进 pytest 工程的操作办法(目录、标记、速度预算)。读完你应能为自己负责的服务规划三层配比,并诊断"该快不快、该真不真"的错位。
某天下午,灯塔小组翻老系统的测试目录,发现了一种熟悉的病态:几百个端到端脚本,每个都要起整套服务、灌整套数据,跑完一轮四十分钟;中间层几乎空白,单元测试零星几个。运维说这些脚本"测出的问题大多不是用户遇到的问题",开发说它们"红着也没人管"。老周把这张病态清单总结成一句话:分层错位——把该由单元测试回答的问题,全压给了最慢的那层。
三层各答一个问题
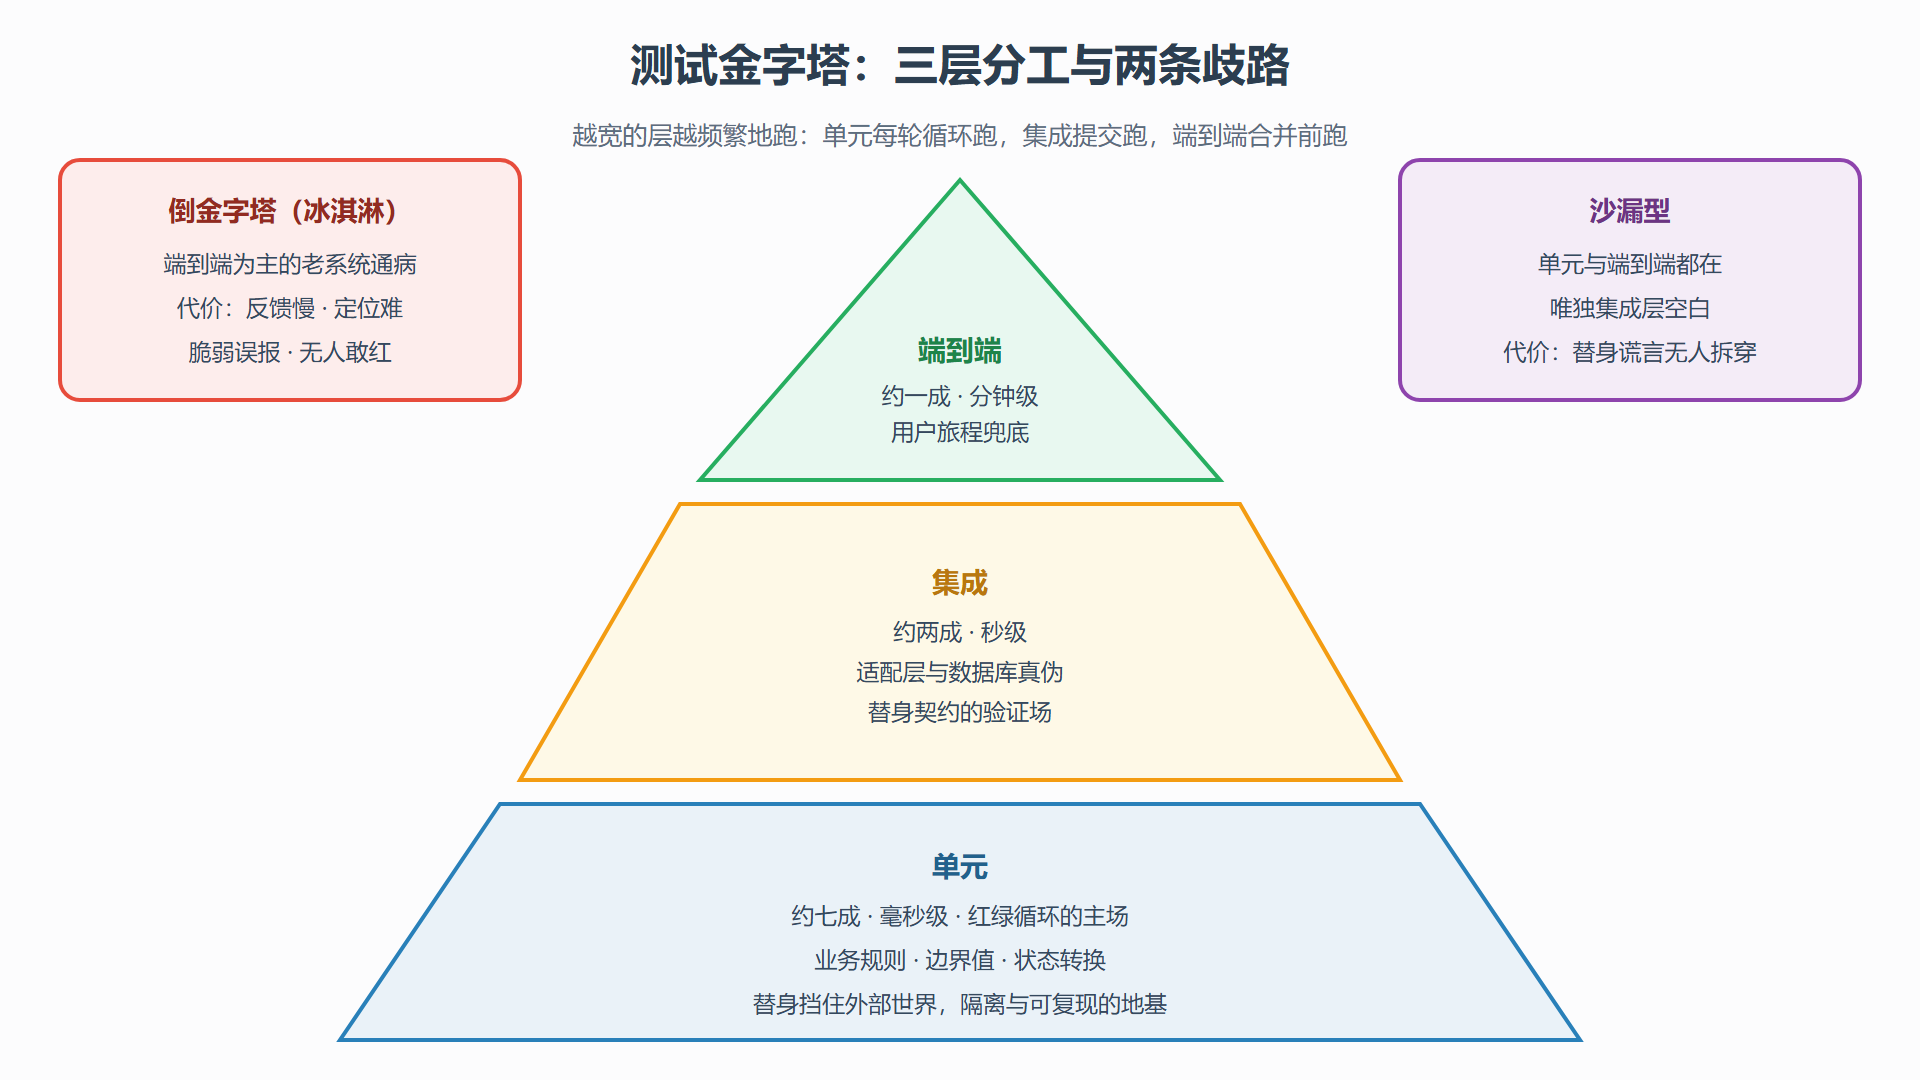
金字塔的价值不在形状好看,在于它按反馈经济学分工:越往下越快越便宜越频繁,越往上越慢越贵越接近用户真相。
| 层 | 回答的问题 | 数量级 | 速度预算 | 典型失败 |
|---|---|---|---|---|
| 单元 | 这个行为对吗(隔离地) | 数百到数千 | 毫秒级/条 | 锁实现细节、假绿(替身撒谎) |
| 集成 | 协作方拼起来还对吗 | 数十到数百 | 秒级/条 | 环境漂移、数据互踩 |
| 端到端 | 用户旅程走得通吗 | 十条以内 | 分钟级/批 | 脆弱、超时、维护费失控 |
配比的经验值是 70/20/10 上下浮动——但配比是结果不是目标:先保证"每个问题找对层级",数量比自然落在金字塔附近。倒金字塔(端到端为主)的三种代价都可以从表里推出来:反馈慢(改行代码等四十分钟才知道对不对)、定位难(红灯只知道旅程断了,不知道断在哪层)、脆弱(任何环境抖动都误报)。
图:测试金字塔对照图
在 pytest 工程里落地三层
分层不能只停留在嘴上,目录、标记与预算要同时立起来:
tests/ unit/ # 毫秒级,无网络无时钟无随机 integration/ # 秒级,真数据库或真适配层,容器起停在这里 e2e/ # 分钟级,完整服务与真实协议
# 注册标记后,三层可分开执行 @pytest.mark.e2e def test_checkout_journey_end_to_end(): ... # 常用命令(写入任务脚本或流水线配置) pytest tests/unit -q # 循环内:主战场 pytest tests/integration -q # 提交前 pytest tests/e2e -q # 合并前 pytest -m "not e2e" -q # 除端到端外全跑
速度预算写在规矩里而不是记在心里:单元条均一百毫秒封顶(3.1 立过的预算),集成条均五秒,端到端一批十五分钟。超预算的用例要么降层(把"能降的逻辑"抽出来在单元层测),要么替换身——降层是金字塔自愈的主要手段:集成测试里八成时间其实在测业务规则,把规则抽走,剩下的才是真正需要真环境的"接线"验证。预算超了不治理的代价是隐性的:慢测试没人愿意跑,不愿跑的测试形同虚设,最终连它的存在都记不清——金字塔的塌陷从不轰轰烈烈,都是从不跑开始的。
各层的失效模式与自查
单元层的失效是假绿:替身模仿错了真实行为,测试绿而线上红——解药是集成层:给每个替身对应的适配层留几条真环境用例(3.3 的边界外侧,正是在这里被拆穿)。集成层的失效是漂移与互踩:环境配置悄悄变了、用例共享数据互相污染——解药是 3.2 的独立柱子加一次性容器。端到端的失效是脆弱:选择器、时序、网络抖动都能红——解药是控制在十来条关键旅程内,并接受它"红必查"的地位,绝不允许带红合并。
各层写什么:灯塔小组的实测清单
三层分工落到具体用例名上最直观。单元层收业务规则:test_coupons_cap_at_ten_percent、test_blacklisted_user_gets_no_coupon、test_empty_cart_total_is_zero——条条毫秒级,条条有边界。集成层收"接线真相":test_coupon_repo_sqlite_roundtrip(4.3 契约矩阵的真实现列)、test_payment_adapter_parses_gateway_response(适配层解析真的对不对,替身说了不算)、test_ledger_migration_replays_sample_day。端到端层收关键旅程:test_guest_buyer_checkout_journey、test_member_refund_journey——十来条,条条对应一条真实业务命脉。
看用例名的分布就能诊断项目:名字全是 journey 的,金字塔倒了;一个 journey 都没有的,沙漏漏了;单元层出现真网络调用的,层间串味了。清单不用背,把这组名字抄给团队当样板,三层各自该长什么样就都清楚了。
金字塔的例外与变形
金字塔是默认形状,不是教条。批处理型系统(对账、报表)中间薄——它们大部分逻辑是纯数据变换,单元层奇厚,集成层只剩文件进出的接线;事件驱动型系统则是"双层金字塔"——单元层测消息处理逻辑,集成层测消息通道语义(至少一次、顺序、重投递),端到端几乎不需要。变形允许,判断标准不变:每类问题仍在最便宜的那层得到回答。变形失败的项目都有一个共同点:不是选择了某种形状,而是没得选——层间没有边界,什么问题都只能一套慢测试兜底。
⚠️ 别用"端到端通过"替代单元层对边界值的覆盖。端到端旅行订票走通了,不代表积分抵扣在零积分、负库存、闰秒这些角落也对——角落的问题只在便宜的那层才测得起。
💡 诊断自己项目的快捷动作:随机抽条跑得最慢的测试,问"它到底在验证什么"。答案里若大部分是业务规则,它就该降层;剩下的接线部分才是它存在的理由。
配比回顾
- 三层各答各的问题:行为对吗、拼起来对吗、旅程通吗。
- 配比是结果,"每问找对层级"是因;倒金字塔三种代价:慢、散、脆。
- 落地三件套:目录分家、标记分批、速度预算成文。
- 降层是金字塔自愈手段:把业务规则抽回单元层,集成层只留接线。
- 下一节处理金字塔之外的特殊地貌:没有测试的老代码——织网工序全解。