1.1 贵与慢发生在哪一步:拆解一次生成请求
1.1 贵与慢发生在哪一步:拆解一次生成请求
本节摘要:生成式推理分为 prefill(一次性处理输入)与 decode(逐字产出)两个阶段。decode 阶段每生成一个 token 都要读取全部模型权重与全部上下文的注意力状态,是典型的"访存受限"场景。本节把一次请求的成本拆开,定位"贵"与"慢"各自发生在哪里,为全册的追因线立下第一个坐标。
凌晨一点,负责大模型服务的工程师被告警叫醒:对话接口的排队时长从两秒涨到了半分钟,用户开始流失。他盯着监控面板,GPU 利用率曲线却是漂亮的满格——卡明明在满负荷跑,为什么吞吐就是上不去?
本节就从这条被叫醒的告警出发。它是第 1 章主线的第一次落地:在指责算力之前,先把一次生成请求拆开,看时间和钱分别花在了哪一步。读完本节你应当能分清 prefill 与 decode 的成本结构,并能解释一个反直觉的现象:GPU 利用率打满,与推理吞吐高,是两回事。
先把一次请求拆成两段
用户发出一段输入(prompt),模型流式吐出一串输出。这个过程在工程上被精确地分成两段:
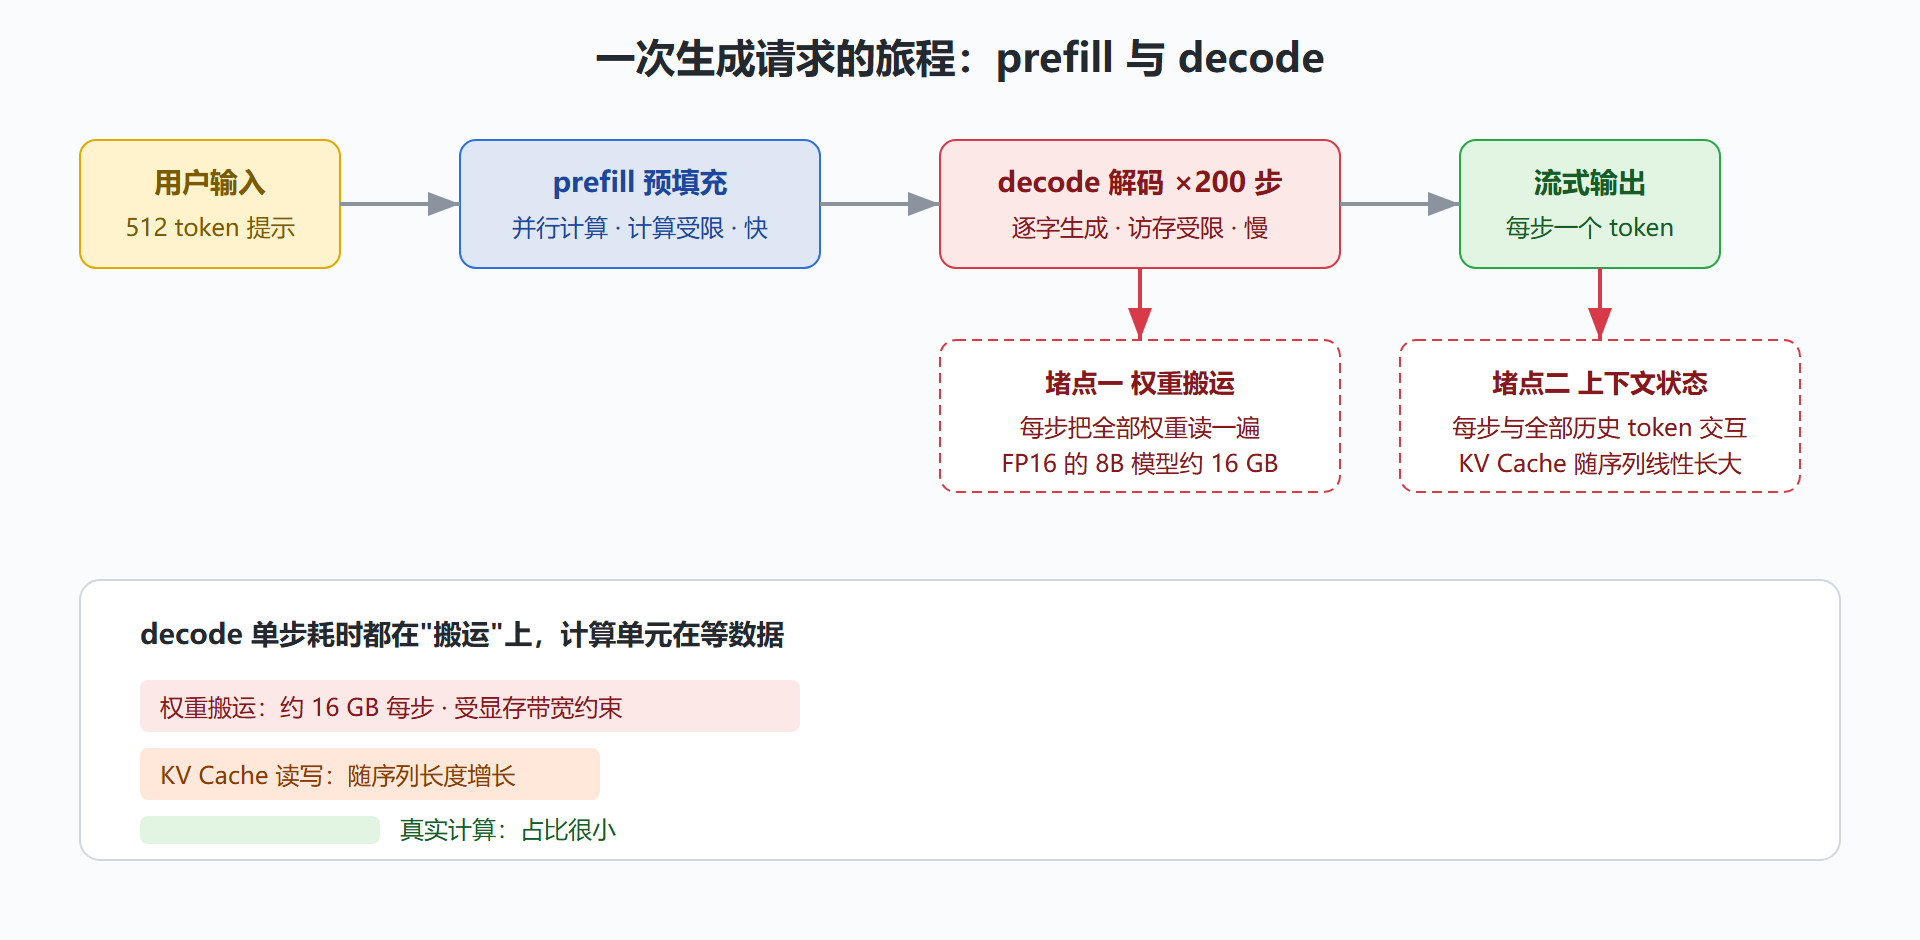
prefill(预填充)阶段:模型把输入的所有 token 一次性并行喂进网络。因为输入是已知的,所有位置的计算互不依赖,可以摊成一个大矩阵乘法,把成百上千个 token 的计算密集地压在一起跑。这一段的特点是计算受限——GPU 的张量核心真正在满算力干活,就像把一整车货物一次性装卸,效率很高。
decode(解码)阶段:输出只能一个 token 接一个 token 地产生,因为下一个字的分布依赖于之前已经生成的所有字。每生成一个 token,都要把整个模型(动辄几十 GB 的权重)从显存过一遍,再对当前序列做一遍注意力计算。这一段的特点是访存受限——计算量其实很小(就是一次"猜下一个字"),但为了这一点计算,要把海量数据从显存搬运进计算单元。
一次生成 200 token 输出的时间构成(示意,Llama-3-8B 级模型、单卡): prefill(输入 512 token) ██████ 约 60 ms decode(输出 200 token) ████████████████████████████ 约 4000 ms(每 token 约 20 ms) decode 每一步的计算量 ≈ prefill 单层计算量的 1/512, 但每一步耗时不小——因为瓶颈是"把全部权重搬一遍"的带宽,不是算力。
这个对比解释了开头那个反直觉现象:decode 阶段的 GPU "利用率"指标可能很高,因为显存带宽确实一直在被占用;但张量核心(真正做计算的部分)大量时间在等数据到达。利用率高不等于干了很多有用的计算——这是推理优化的第一课。
慢的根源:权重搬运与上下文状态
decode 每一步的耗时,主要由两部分搬运构成:
权重搬运:参数量决定。一个 8B 模型以 FP16 存放约占 16 GB 显存,每生成一个 token,这 16 GB 几乎都要被读取一遍。以一张带宽约 2 TB/s 的数据中心卡计算,仅权重搬运的理论下限就是约 8 毫秒——这就是为什么"每 token 20 毫秒"量级的解码速度如此常见,也是为什么量化(第 6 章)能直接把解码提速:权重砍半,搬运时间跟着砍半。
上下文状态搬运与计算:注意力机制要求当前 token 与之前每一个 token 都做一次交互,这些交互依赖的历史信息以 KV Cache 的形式存放在显存里。序列越长,这部分越大,decode 单步耗时越长。这也解释了长上下文场景为什么格外昂贵:同样的输出长度,输入从 512 token 涨到 8192 token,decode 每一步要照顾的注意力对象多了许多倍。
关键直觉:decode 是"每出一个字,把整个模型翻一遍书"的过程。快慢的关键不在翻书的手有多快,而在书架的布局让你少翻几遍——这本"书"包括权重,也包括越写越长的上下文笔记(KV Cache)。
图:一条生成请求的旅程与两处堵点
贵的根源:按 token 计费背后的时间账
"贵"有两种形态。自建部署的贵是显性的:一张数据中心级显卡按时计价,服务吞吐越低,摊到每个 token 上的硬件成本越高。假设一张卡一小时租金折合几十元,若该卡每秒只能产出几十个 token,那么每千 token 的硬件成本就是按"卡时除以产量"算出来的——产量翻几倍,单价就降几倍。这就是为什么吞吐优化直接等于成本优化。
调用 API 的贵是隐性的:服务商按 token 收费,定价里包含了他们的推理成本与利润。理解了 decode 的访存本质,你就能理解为什么输入价格通常低于输出价格——prefill 是计算受限的高效模式,decode 是访存受限的低效模式,输出每个 token 的服务成本天然更高。
还有一笔容易被忽略的账:长输出比长输入贵得多。2000 token 的输入加 500 token 的输出,用户感觉"输出少所以便宜",但 decode 那五百步每步都要完整搬运一遍模型,时间成本可能反超 prefill。做产品定价与限流策略时,按"输出 token 数"设防往往比按输入设防更有效。
一个案例:把告警拆成数字
回到凌晨的告警。第二天复盘,工程师做了一个最小实验:同一个模型、同一张卡,分别测单发请求与八条并发请求的吞吐。结果显示:单发时每秒约 45 个 token,八发并发时总吞吐只有约 120 个 token——远没有达到八倍,但也没有只维持 45。这个"并发能提升吞吐但远不到线性"的形状,正是访存受限系统的典型特征:单发时带宽只被一个请求的权重搬运占满大半,多个请求可以共享同一次权重搬运(同一批里大家用的是同一份模型权重),所以并发有收益;但传统部署方式下,并发请求各自为政地管理上下文,显存很快被预留空间吃光,并发度上不去,收益就封了顶。
这个实验给了复盘一个明确的方向:问题的第一优先级不是换更强的卡,而是提高单位显存能同时伺候的请求数。这条线索直接通往第 2 章——在动手之前,得先弄清楚显存到底被什么吃掉了。
⚠️ 常见误读:把 GPU 利用率监控当成吞吐指标。利用率衡量的是"GPU 有活干的时间占比",decode 阶段大量搬运低效计算也能把利用率撑高。判断真实效率要看吞吐、每 token 延迟与显存有效利用率,下一节就把这些指标定义清楚。
本节要点回顾
- prefill 与 decode 是两种成本结构:前者计算受限、并行高效;后者访存受限、每步都要搬运全部权重。
- decode 每步耗时由权重搬运与上下文状态主导,计算本身占比很小,所以"更强的算力"未必换来等比的提速。
- 利用率高不等于效率高:显存带宽被占满也可能只是在做低效搬运,判断要看吞吐与每 token 延迟。
- 贵是吞吐的反面:自建的按卡时摊销,API 的含服务成本,长输出因 decode 步数多而天然更贵。
- 并发有收益但受显存封顶,这引出了全册的第一主角——KV Cache 的显存账(第 2 章)。