1.3 vLLM 的解题思路:一张问题与机制对应图
1.3 vLLM 的解题思路:一张问题与机制对应图
本节摘要:把前两节收集的症状清单与 vLLM 的机制清单逐一对上号:PagedAttention 治显存碎片、连续批处理治调度浪费、前缀缓存与投机解码治重复计算、量化与并行治容量与精度。本节给出全册的总览地图与各机制的代价清单,让你在深入每个机制之前先知道"哪把钥匙开哪把锁"。
为什么一个来自加州大学伯克利分校 Sky Computing Lab 的研究项目,能在发布后短时间内成为开源推理服务的事实标准之一?答案不在它把算子调得更快——而在它把前面两节梳理的问题清单当成了一张作战地图:显存利用率低、调度粒度粗、重复计算多,每一个痛点都对应一个明确的机制解法,且这些机制可以叠加生效。
论文作者给出的实测结论是:在同等负载下,vLLM 相比当时主流的 Hugging Face Transformers 部署方式,吞吐提升从数倍起步,序列越长、并发越高,差距越大,极端场景可达二十倍以上。数字会随版本与模型浮动,但量级差距是结构性的:一边是按最坏情况预留显存、整批同进同出的部署方式,一边是页式显存管理与逐 token 调度的部署方式——差的不是工程打磨,是资源组织范式。
五个症状,五把钥匙
把第 1.1、1.2 节的证据摆到一张表上,对应关系一目了然:
| 症状 | 根因 | vLLM 的钥匙 | 深入章节 |
|---|---|---|---|
| 并发上不去,显存早早告急 | KV Cache 按 max_len 整块预留,碎片浪费大半 | PagedAttention 块表管理 | 第 3 章 |
| 混合长短请求时资源错配 | 内部碎片与外部碎片并存 | 按需分配 16 token 的块 | 第 3 章 |
| 吞吐低,GPU 在等请求凑批 | 静态批同进同出,短请求陪跑 | 连续批处理(迭代级调度) | 第 4 章 |
| 高峰期延迟雪崩 | 批满了只能排队或杀请求 | 抢占、交换与重计算 | 第 4 章 |
| 重复前缀反复计算 | 相同系统提示词各自算一遍 | 前缀缓存(自动前缀共享) | 第 5 章 |
| 逐 token 串行解码慢 | 每步只前进一步 | 投机解码(草稿-验证) | 第 5 章 |
| 大模型单卡装不下、精度浪费显存 | 权重与 KV Cache 超限 | 量化与张量/流水线并行 | 第 6 章 |
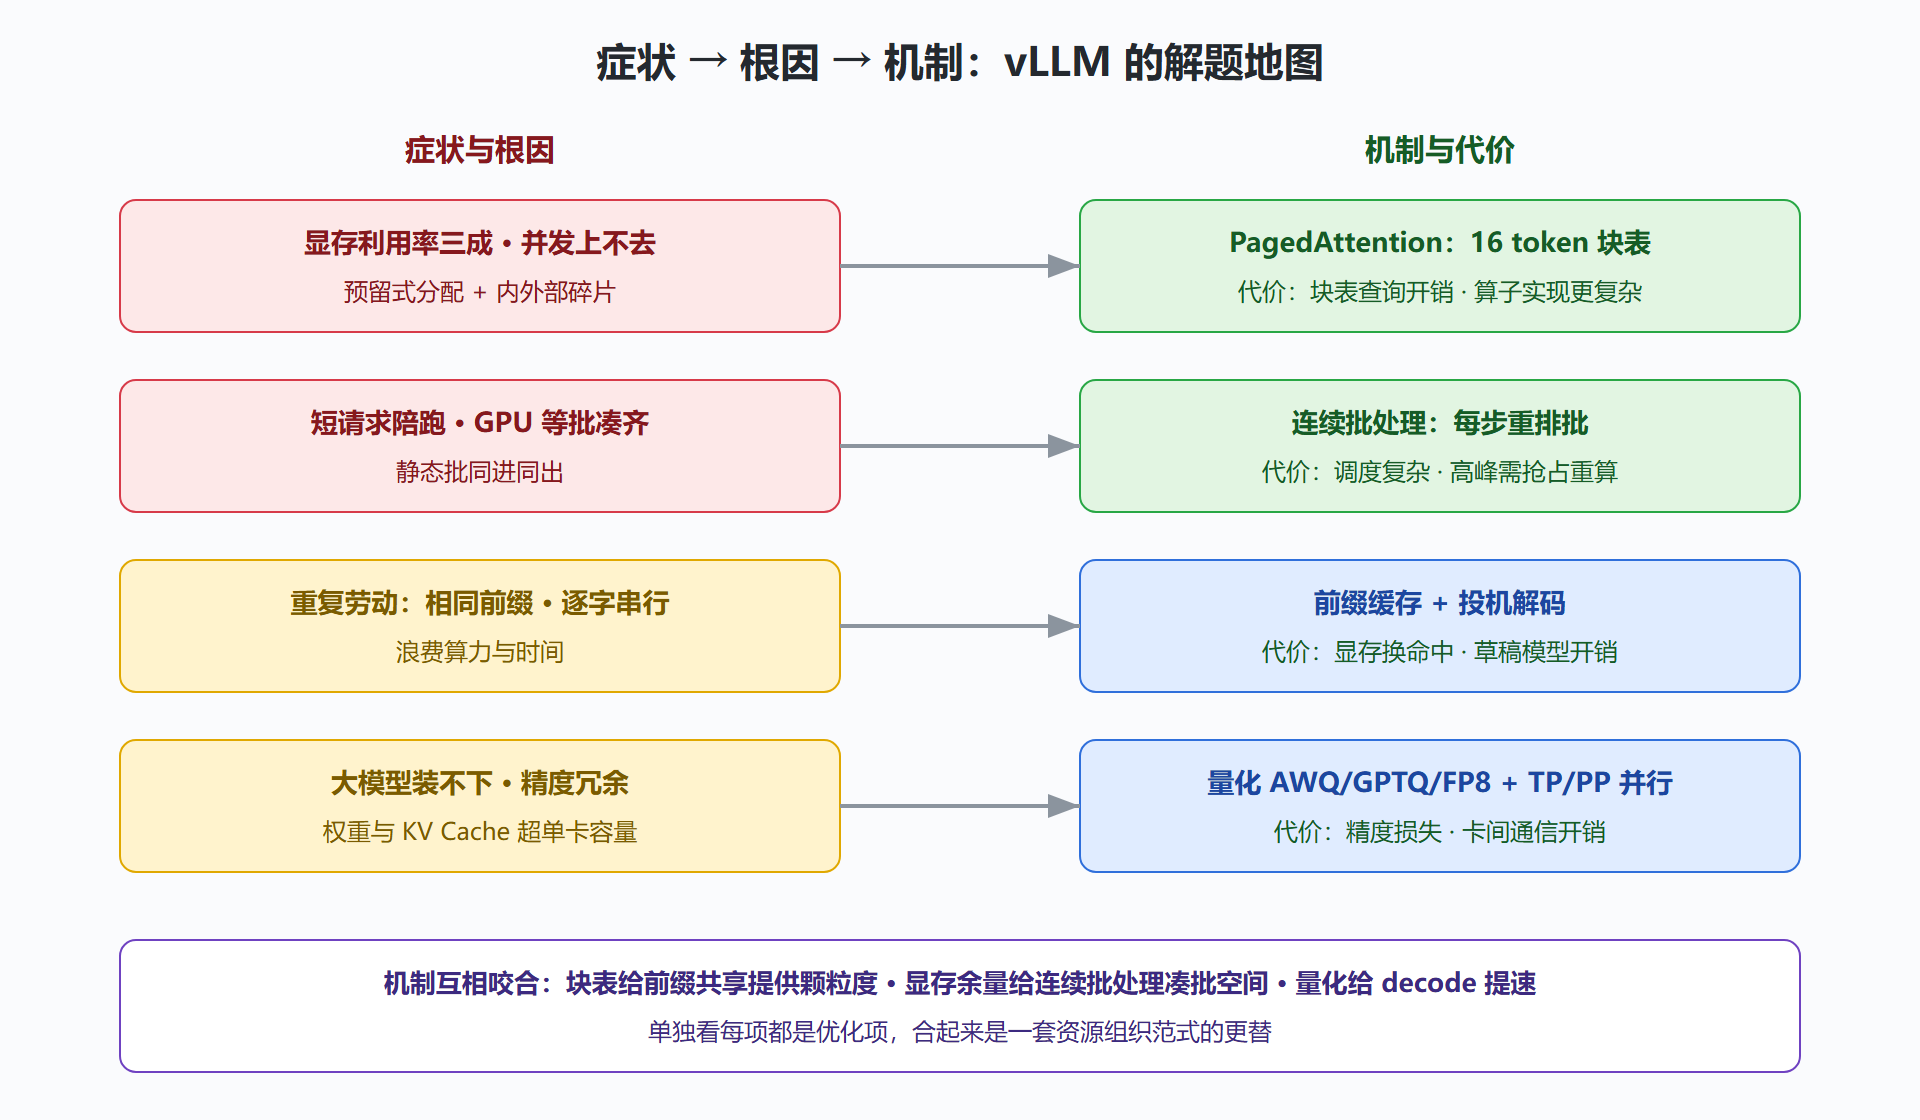
值得强调的是右下角那一行:量化不只省显存,还能提速——权重字节数减半,decode 每步的搬运时间随之减半,这正是第 1.1 节"访存受限"结论的直接推论。机制之间也相互借力:PagedAttention 把 KV Cache 切成块之后,前缀共享才有颗粒度合适的复用单位;显存利用率上去之后,连续批处理才有凑大批的空间。这些机制不是并列的功能列表,而是一套互相咬合的系统设计——这也是为什么本册按依赖顺序而非功能顺序编排章节。
图:问题清单与 vLLM 机制总览
每把钥匙都有代价
工程上没有免费的优化,vLLM 的每个机制也都带着自己的账单。提前看清代价,能帮你判断"该不该在你的场景打开它":
PagedAttention:块表引入间接寻址,注意力算子要处理非连续内存,实现复杂度高;块的粒度(16 token)意味着平均每条请求仍有一点内部碎片,只是从"百分之几十"降到了"百分之几"。
连续批处理:调度器每个迭代都要决策"谁进批、谁等待、谁被抢占",高峰期的抢占与重计算会浪费已完成的计算(第 4.2 节细讲);被抢占请求的 TBT 会出现毛刺。
前缀缓存:用显存存共享前缀的 KV Cache,命中率低的长尾场景等于白占内存;缓存块需要淘汰策略,处理不当会颠簸。
投机解码:需要额外的草稿模型(或多候选开销),接受率低的场景反而变慢——它赌的是"草稿大多是对的"。
量化:低位宽带来精度损失,部分任务(数学推理、代码、少样本)对量化敏感;低位宽 KV Cache 同样有质量权衡。
并行:张量并行靠高速互联(NVLink),跨机做 TP 会被通信拖垮;流水线并行有气泡,并行度越高气泡占比越明显。
动手前先想清楚的一个问题
你的场景里,瓶颈排在最前面的是哪一个:显存不够(并发低)、调度浪费(批凑不起来)、重复计算(前缀雷同/逐字串行),还是容量不足(模型装不下)?
不同答案对应不同的优先级:对话类产品前缀雷同度高,前缀缓存收益立竿见影;批量文档处理前缀各异但请求长,重点在块表与批处理;七零八落的小卡集群则先考虑量化。vLLM 把这些机制默认打包好,但调参的人得知道每个旋钮背后是哪把钥匙——这正是本册后面各章的任务。
常见追问
问:这些机制是 vLLM 独有的吗?别家框架有吗?
PagedAttention 与连续批处理的思路如今已被多个推理框架吸收,但两者都是 vLLM 论文首先系统化并提出完整实现的。理解原理的价值正在于此:无论你最终用哪个框架,看到"块大小""缓存命中率""抢占"这些词,都知道它们背后是同一套机制在起作用。
问:这些机制对生成质量有影响吗?
分两类看。资源组织类(块表、连续批处理、并行)不改变任何计算内容,输出与朴素部署逐位一致;压缩与加速类(量化、投机解码)有各自的质量边界——量化要看任务敏感度,投机解码数学上保证分布一致。第 5、6 章会给出各自的验证方法。
问:小模型也需要这套东西吗?
越小的模型越不需要并行的部分,但显存组织与调度部分照样受益——小模型单步更快,意味着调度开销与批组织的影响占比反而更高。一个几 B 的模型在朴素部署下每秒几十 token、换到 vLLM 后翻数倍,是社区里反复出现的实测报告。
问:先优化哪个机制的收益最大?
看瓶颈排序,而排序要用数据说话——这正是第 8 章压测口径存在的原因。粗略的先验是:多数对话类服务的前三大收益来源依次是显存利用率(决定并发上限)、批处理(决定吞吐)、前缀缓存(决定 TTFT 与成本),投机解码与量化排在之后按需启用。
本节要点回顾
- vLLM 的领先是范式级的:页式显存管理与迭代级调度替代预留式分配与静态批,吞吐对比传统部署从数倍到二十倍以上。
- 症状、根因、机制一一对应,遇到问题先定位根因,再找对应机制,不要无差别调参。
- 机制之间互相咬合:块表是前缀共享的地基,显存余量是大批的前提。
- 每个机制都有代价:间接寻址、抢占重算、缓存占用、接受率风险、精度损失、通信开销。
- 动手顺序由瓶颈排序决定,而不是把所有旋钮一起拧。
问题清单里排第一位的是显存。下一章我们把 KV Cache 这本账彻底翻开来算:公式每一项是什么、三重浪费各占多少、为什么传统框架救不了自己。