7.1 安装与第一条命令:从零到流式吐字
7.1 安装与第一条命令:从零到流式吐字
本节摘要:部署 vLLM 的最小路径只有四步:对齐环境版本、安装框架、下载模型、一条 serve 命令起服务。别被"生产级推理引擎"的名头吓住——跑通它比装一个数据库还快;真正的功夫在参数(下一节)。本节给出完整命令流与冒烟验证方法,并解释 OpenAI 兼容接口为什么是 vLLM 生态位的关键一子。
别以为部署一个推理引擎要从读源码开始——vLLM 的最小可用路径短得出奇:一条安装命令、一条启动命令,几分钟内就能看到模型流式吐字。本节把这条路径完整走一遍,重点不在命令本身,而在每一步背后"哪些东西必须对齐"的判断力。读完本节,你应当能独立完成一次冒烟部署,并理解 OpenAI 兼容接口给生态带来的乘数效应。
第一步:对齐环境的三件套
vLLM 是深度绑定 NVIDIA CUDA 生态的工程(对 AMD 等硬件的支持另行验证),部署前先核对三件事的版本兼容关系:
1. 显卡驱动:足够新即可,驱动向下兼容 CUDA 运行时。 2. CUDA 版本:vLLM 的预编译包按 CUDA 大版本发布(比如 12.x 系列), 安装时选择与本地 CUDA 匹配的包,或直接用自带 CUDA 运行时的镜像。 3. Python 版本:跟随官方支持的版本区间,一般取较新的稳定版即可。
最省心的方式是使用容器镜像(官方提供带齐全部依赖的镜像),把"三件套对齐"这个问题整体移交给镜像维护者;裸机部署则建议虚拟环境隔离安装。安装命令只有一行:
pip install vllm
安装体积不小(包含预编译的 CUDA 算子),首次安装预留几分钟与数 GB 磁盘空间。装完先做一个不加载模型的快速自检,确认框架与 CUDA 能正常握手——很多"装好了却跑不起来"的问题出在驱动过旧或 CUDA 版本错配,提前暴露比启动时排查便宜得多。
第二步:模型与第一条命令
vLLM 直接消费 Hugging Face 格式的模型仓库,主流开源模型(Llama、Qwen、DeepSeek、Mistral、Gemma 等家族)无需转换即可加载。首次启动会自动下载权重(几十 GB 起步,注意磁盘与网络),也可以提前手动下载到本地再指定路径。
启动服务同样只有一条命令:
# 最小启动:加载模型,在默认端口提供 OpenAI 兼容 API vllm serve 模型名称 # 常见的首次启动配置:指定端口、上下文上限与显存水位 vllm serve 模型名称 --port 8000 --max-model-len 8192 --gpu-memory-utilization 0.9
日志会依次打印:权重加载、显存预估、块池初始化(第 3 章的物理块数量会在这里出现)、API 服务就绪。看到"服务已启动"的提示后,用一条 curl 或一段 Python 冒烟验证:
from openai import OpenAI # 关键只有一个:把 base 地址指向本地 vLLM,其余与调用官方 API 无异 client = OpenAI(base_url="http://localhost:8000/v1", api_key="empty") stream = client.chat.completions.create( model="模型名称", messages=[{"role": "user", "content": "用一句话介绍你自己"}], stream=True, ) for chunk in stream: print(chunk.choices[0].delta.content or "", end="", flush=True)
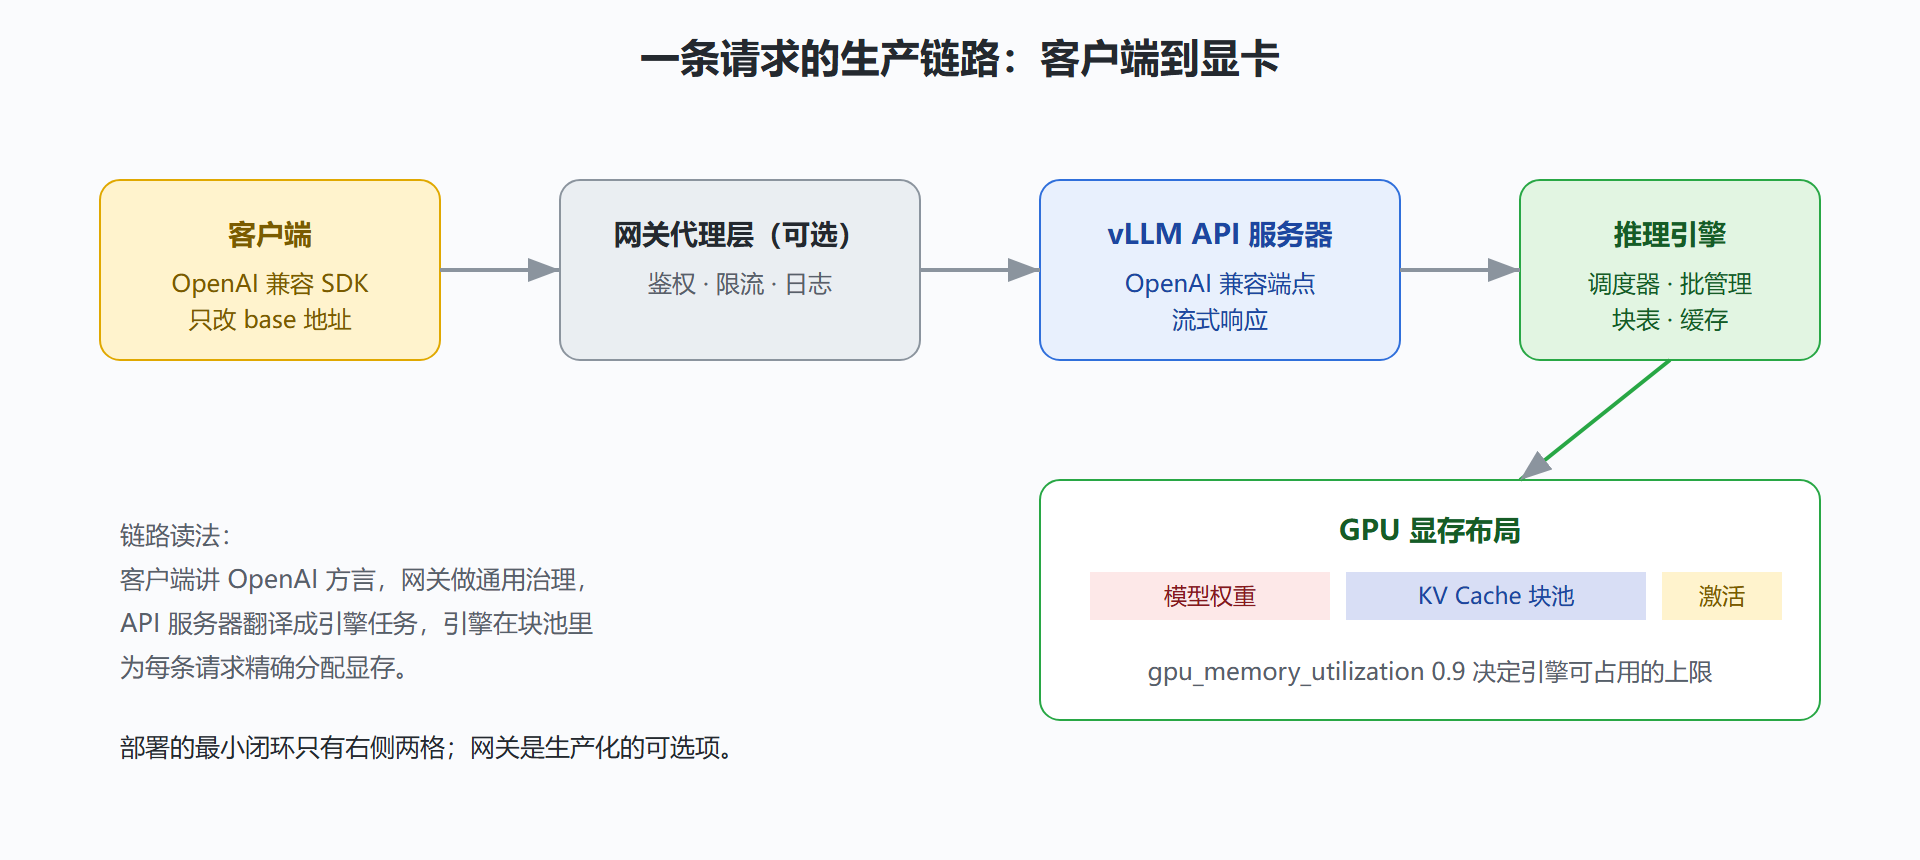
流式输出逐字打印的那一刻,前六章的全部机制已经在为你工作:块池在承接这条请求的 KV Cache,调度器把它排进批,prefill 与 decode 按部就班。冒烟部署到此完成——从零到吐字,真正必要的决策只有"选哪个模型"。
第三步:理解 OpenAI 兼容接口的分量
vLLM 内置的 API 服务器在请求与响应结构上对齐 OpenAI 的对话补全接口,这件事的分量需要放到生态里看:
- 客户端零成本迁移:几乎所有语言的主流 SDK 都支持 OpenAI 接口,把 base 地址从官方 API 改成本地 vLLM,代码不用动。自建服务与商用 API 之间可以随时切换、灰度、互为备份。
- 工具链即插即用:各家的应用框架、代理网关、观测工具都默认说这门"普通话",vLLM 接上就能被编排。
- 运维边界清晰:鉴权、限流、日志这类网关职责可以放在 vLLM 之前的代理层,引擎专注推理本身。
行为差异也要心里有数:个别高级字段(比如某些采样参数的边界行为)与官方 API 存在细节出入,迁移后建议对核心场景做一轮回归;模型名就是本地加载的模型名称,与官方 API 的模型代号无关。
图:从客户端到显卡的一条完整链路
冒烟之后:三个别急着跳过的检查
跑通不等于能上线,冒烟验证后建议立刻做三个廉价检查:
- 显存水位核对:启动日志里的显存预估与块池大小,和第 2 章公式的心算对一下量级,差得远就要查量化与并行参数是否生效。
- 并发冒烟:用压测工具发一小段并发(比如几十条),观察日志里批大小的爬升与 KV Cache 使用率曲线,确认调度器在正常工作。
- 流式与中断:验证流式输出与客户端主动断连后的资源回收——断连后请求应当被及时清理,块池占用应当回落。
这三项各花几分钟,能拦截绝大部分"上线第一天"的事故。剩下的参数功课,交给下一节逐个拆解。
三个高频启动失败与一句诊断
冒烟部署的失败场景高度集中,先备好诊断卡:
显存不够(启动即报分配失败):多半是 max-model-len 留在模型上限、显存预估超了卡容量。先用第 2 章公式心算一遍权重加缓存的峰值,再按业务长度下调上下文参数。
版本不兼容(加载或内核初始化报错):驱动过旧、CUDA 大版本与安装包不匹配是两大主因。读报错里的版本号对照安装文档,比盲试参数快得多。
模型加载失败(权重文件缺失或格式不符):下载不完整、或误拿了非标准格式的仓库。删掉本地缓存目录重新下载,或换官方格式仓库。
三个场景的共同点:报错信息里都带着答案,先读日志再动手,是部署环节最重要的肌肉记忆。
关于"模型从哪来"的一句提醒
生产环境建议把模型权重放在本地存储并显式指定路径,而不是依赖启动时自动下载——下载源的网络波动、磁盘空间不足、以及不可复现的版本漂移,都会让部署变成开盲盒。把"权重文件固定、路径显式、版本记录在案"纳入部署规范,服务的可复现性就有了地基。这一条不花任何性能成本,纯粹是工程纪律,却是新手环境与生产环境差距里最大的一块。
本节要点回顾
- 最小路径四步:对齐环境、安装、下载模型、一条 serve 命令;容器镜像是省心之选。
- 冒烟验证三件套:单请求流式、小段并发、断连回收,缺一不可。
- OpenAI 兼容接口是生态杠杆:客户端迁移只改地址,工具链即插即用,留意个别字段的行为差异。
- 启动日志值得通读一遍:显存预估、块池规模、调度器初始化,都是前六章机制的现场投影。
- 跑通之后立刻核对显存水位,与公式对账,别带着糊涂账进下一节。