6.1 张量并行与流水线并行:把大模型摊到多卡上
6.1 张量并行与流水线并行:把大模型摊到多卡上
本节摘要:张量并行把一层内的权重矩阵切片,多卡各算一块、每步前向互相同步;流水线并行把模型的层分组接力,各卡负责一段。前者通信密集、适合单机 NVLink 互联,后者通信稀疏、适合跨机扩展。本节讲两种切法的原理、气泡与通信的代价模型,以及在 vLLM 里各对应的一行启动参数。
「张量并行」这个词听起来吓人,做的事情却很朴素:一张卡装不下的矩阵,切成几份,每张卡拿一份,算的时候互相递个纸条。难点全在"递纸条"的频率与代价上——这也是两种并行方案分野的根源。本节沿"切在哪里"这条线走:切在层内,还是切在层间。
张量并行:切在层内,通信在每一步
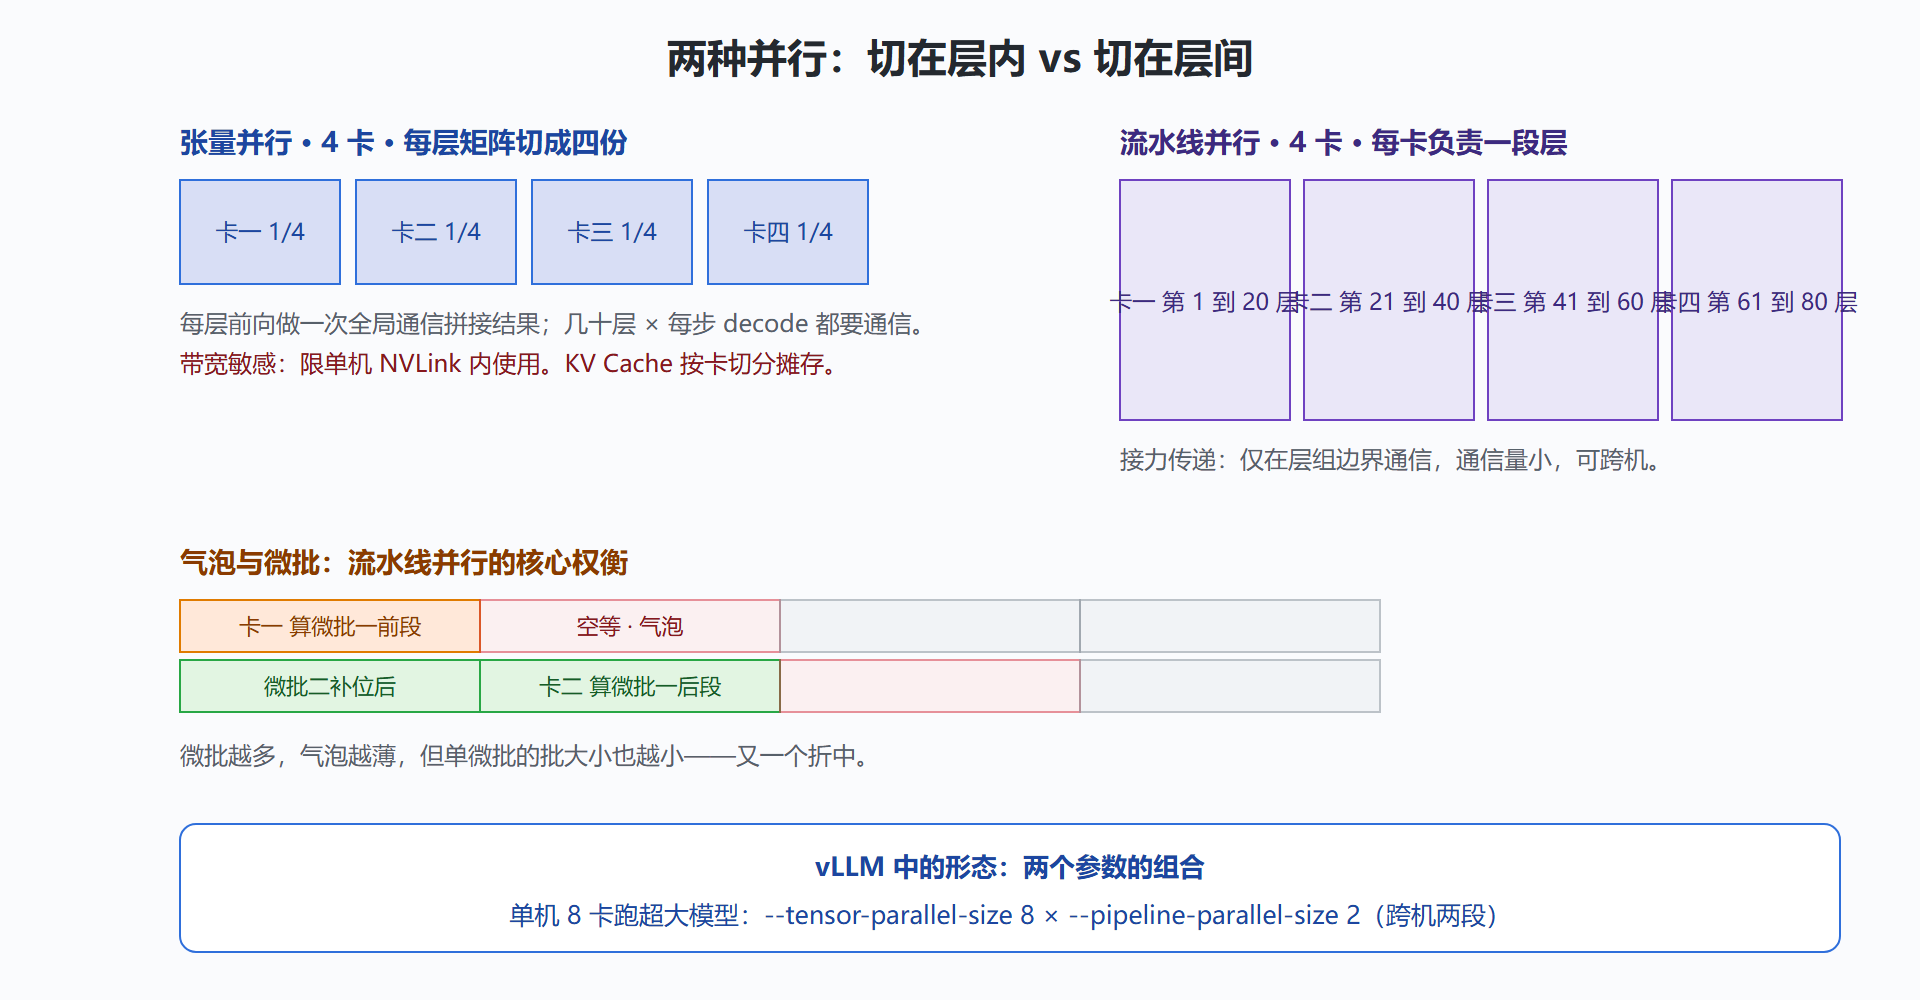
Transformer 的每一层主要由两块矩阵构成:注意力投影与前馈网络(MLP)。张量并行把它们按列(或按行)切开,比如 4 卡并行时,每张卡只持有四分之一的权重片段。前向计算时,各卡用自己那份切片并行算出部分结果,再通过一次全局通信(all-reduce 或 all-gather)把碎片拼成完整输出。
关键的性质是:每一层前向都要通信一次。一个模型几十层,decode 每步都要把所有层的通信走一遍。这让张量并行对通信带宽极其敏感——卡间互联的速度直接决定并行效率:
NVLink 互联(单机内多卡):带宽以每秒数百 GB 计,通信开销占比小,效率高。 PCIe 互联:带宽低一个数量级,多卡协同的大部分时间花在等数据,收益骤降。 跨机网络:更慢。张量并行跨机基本不可行。
所以工程上有一条硬规矩:张量并行度以单机卡数为上限。单机 8 卡就把张量并行度开到 8 以内;需要更多卡时,超出部分交给流水线并行。vLLM 里这对应一个启动参数:
# 单机 4 卡张量并行启动一个 70B 模型 vllm serve 模型名称 --tensor-parallel-size 4
张量并行还有个隐藏福利:KV Cache 也随并行切分到各卡,每张卡只存自己那份切片对应的缓存。显存账随之改写——总容量变成"卡数乘以单卡容量",单请求开销不变但被分摊,这为超长上下文或多批并发腾出了空间。
流水线并行:切在层间,接力与气泡
流水线并行换了一个切法:不切层内的矩阵,而是把模型的层分组——比如 80 层的模型分给 4 张卡,每卡负责 20 层,像接力赛一样:第一张卡算完前 20 层把中间结果递给第二张,依次传递到最后一张卡输出。
接力的问题在于等待:同一时刻,第一张卡算的时候,其余三张卡在干等;这种空闲时段被称为流水线气泡。缓解办法是把输入切成若干微批,让各卡交替处理不同微批——第一张卡在算微批二的第 1 段时,第二张卡正在算微批一的第 2 段,流水被填满,气泡被摊薄。微批越多气泡越小,但每个微批的批大小也越小,单次计算的效率略降,又是一个折中。
流水线并行的通信量只有张量并行的零头——每条数据在层组边界只传一次,传递的还是小得多的中间激活。这使它适合跨机:机间网络慢,也扛得住这种低频通信。代价模型因此清晰:
| 维度 | 张量并行 | 流水线并行 |
|---|---|---|
| 切分对象 | 层内权重矩阵 | 层分组 |
| 通信频率 | 每层每次前向 | 仅层组边界 |
| 带宽要求 | 极高,限单机 NVLink | 低,可跨机 |
| 主要损耗 | 通信等待 | 流水线气泡 |
| 典型搭配 | 单机内 2/4/8 路 | 跨机 2 路以上 |
图:张量并行与流水线并行的切法对比
组合拳:tp 与 pp 怎么配
两种并行在 vLLM 里可以组合:--tensor-parallel-size(tp)与 --pipeline-parallel-size(pp)相乘就是总卡数。经验配置法则:
- 先吃满单机:tp 优先,比如单机 8 卡,tp=8 能装下就别用 pp;
- 装不下再跨机:机间用 pp 分段,机内用 tp 分片——例如 16 卡分两台机器,tp=8 × pp=2;
- KV Cache 余量倒推:显存不够时优先提高 tp(缓存与权重都摊薄),pp 只增加容量不摊薄单卡缓存压力;
- 留一张卡的余量:tp 数通常取 2 的幂(2/4/8),与硬件拓扑对齐,奇数配置几乎不出现在生产里。
跨机部署时还需要一个编排队:多机的卡组成一个推理实例,由 Ray 这类分布式框架负责把进程拉起来、把通信组建好——对使用者而言仍是一行参数的事,但网络质量(带宽与延迟)会直接体现在吞吐上,跨机前先测网络再上生产。
⚠️ 并行度不是越大越好:tp=2 时通信开销几乎无感,tp=8 时通信占比明显上升;在能装下的前提下,**更小的并行度通常吞吐更高**。先用量化把模型压进更少的卡,再考虑加并行,是性价比更高的路径——这正是下一节的主题。
为什么 decode 受并行的影响比 prefill 大
一个值得单独拆解的现象:并行度提高后,prefill 的效率衰减往往不明显,decode 却肉眼可见地变慢。原因还是通信与计算的比例——prefill 一次算几千个 token,计算量巨大,通信等待被淹没在计算里;decode 每步只算一个 token,计算量薄得像纸,同样的通信耗时占比就变得刺眼。这解释了生产里的一条经验:并行的吞吐代价主要体现在 decode 密集的负载上,批量离线处理对并行的容忍度明显更高。给业务选并行度时,先问"我的负载是 decode 密集还是 prefill 密集",答案直接改变配置的甜点位。
跨机部署前的网络体检清单
流水线并行对网络宽容,但"宽容"不等于"无所谓"。跨机上线前过一遍这四项:机间带宽实测(用标准工具打流,看是否达到标称值);延迟与抖动(微批的接力对延迟敏感,抖动大会放大气泡);网络冗余(单链路故障不应导致整个实例瘫痪);以及防火墙与端口策略(分布式框架需要在节点间开一组端口,生产网络里这是最常见的起不来原因)。四项体检的二十分钟,换来的是跨机实例上线后少熬的几个大夜。
显存账的再对账:并行改变公式的哪一项
回顾第 2 章的公式看并行的投影:张量并行把权重与 KV Cache 按卡数摊薄——公式里的每一项都不变,但它们被切分到各卡,单卡占用降为除以卡数;流水线并行只把权重按层组分摊,每卡仍要放整段序列的缓存,所以长上下文 + 大 pp 组合下,单卡缓存压力可能反而先顶到天花板。这是"容量不够先加 tp、跨机再 pp"法则背后的算术——不是经验主义,是公式的直接推论。
本节要点回顾
- 张量并行切在层内,每层每步通信,带宽敏感,限单机 NVLink;KV Cache 随卡切分摊存。
- 流水线并行切在层间,仅在边界通信,可跨机;代价是气泡,用微批缓解。
- 参数组合:tp × pp = 总卡数;先吃满单机 tp,跨机用 pp 补足。
- 并行度与吞吐负相关(通信与气泡),能用量化省出的显存就别用并行凑。
- 跨机前先测网络:pp 对网络宽容,tp 不可跨机,网络质量直接决定跨机实例的吞吐。
并行解决了"装得下",还剩"装得巧":同样的卡,能不能让字节数先瘦下来?下一节进入量化的世界——AWQ、GPTQ、FP8 三条路线各有何取舍。