8.3 压测基准与监控指标:闭环的最后一块
8.3 压测基准与监控指标:闭环的最后一块
本节摘要:调优没有尺子就是玄学。本节定义压测的三个要素(请求分布、并发斜坡、统计口径),给出监控指标集与各自的正常形态描述,并提供"从曲线异常到机制根因"的排查对照表。加上官方压测工具的标准用法,本章的度量-定位-调整闭环到此闭合。
vLLM 自带一套压测脚本(benchmark 系列),能按可配置的口径对服务端发起合成流量并输出统计报告。但工具本身不产生结论——口径不对,数字再漂亮也是自欺。本节先定口径,再看指标,最后给出排查对照表,把第 8 章的闭环拼完。
压测三要素:分布、斜坡、分位
请求分布:压测请求的输入输出长度必须模拟真实流量,而不是清一色的短请求。真实世界是重尾的:大多数请求很短,少数长请求占掉大部分显存与时间。合成流量时给长度加上贴近业务的分布(平均长度与长尾比例都从线上日志反推),否则容量结论必然偏乐观——这正是第 1.2 节"单发数据预测线上容量"翻车事故的根源。
并发斜坡:不要一步到位打满并发,按阶梯爬升(比如并发数逐级翻倍),每级稳定足够长时间再记录。斜坡的价值在于找到服务的"膝盖点"——吞吐随并发线性增长的终点:膝盖之前加并发是白赚的吞吐,膝盖之后加并发只会制造排队与抢占。容量规划按膝盖点的七八成留余量。
统计口径:永远看分位数(P50、P90、P99),不看平均值。推理延迟天然重尾,均值会被大多数快请求稀释,掩盖长尾用户的体验。验收标准必须写成"TTFT P99 低于某值、TBT P99 低于某值、吞吐不低于某值"的三元组。
官方压测脚本的标准姿势(示意): benchmark_serving \ --backend vllm \ --model 模型名称 \ --num-prompts 1000 \ --request-rate 逐步爬升 \ --dataset 自建的真实分布数据集 输出必看四行:总吞吐、每请求吞吐、TTFT 分位、TBT 分位。 每次改动后用同一份命令重跑,前后差异才是结论。
监控指标集:正常形态与异常信号
服务上线后,压测口径变成监控基线。以下指标集构成推理服务的仪表盘,每项都标注它的"健康长相":
| 指标 | 健康形态 | 异常信号 | 指向 |
|---|---|---|---|
| 总吞吐曲线 | 随流量平稳伸缩 | 流量平稳但吞吐下台阶 | 内核/版本回归 |
| TTFT 分位 | 稳定在压测基线附近 | 阶跃式抬升 | 排队堆积或 prefill 拥堵 |
| TBT 分位 | 平稳的窄带 | 毛刺或抬宽 | 抢占、混批干扰 |
| 块池水位 | 高位平稳(缓存填满属正常) | 持续贴顶加抢占 | 容量不足 |
| 运行批大小 | 贴近配置上限 | 长期远低于上限 | 上游流量不足或入批受阻 |
| 抢占计数 | 长期为零,偶发尖峰 | 持续增长 | 回到 8.1 决策链 |
| 请求成功率 | 接近满值 | 超时与拒绝增多 | 容量或上游问题 |
这套指标的价值在于相互印证:单一指标异常可能是误报,两三个指标同时异动才能锁定根因——TBT 毛刺加上抢占计数尖峰,基本可以断定是容量问题而非网络问题。
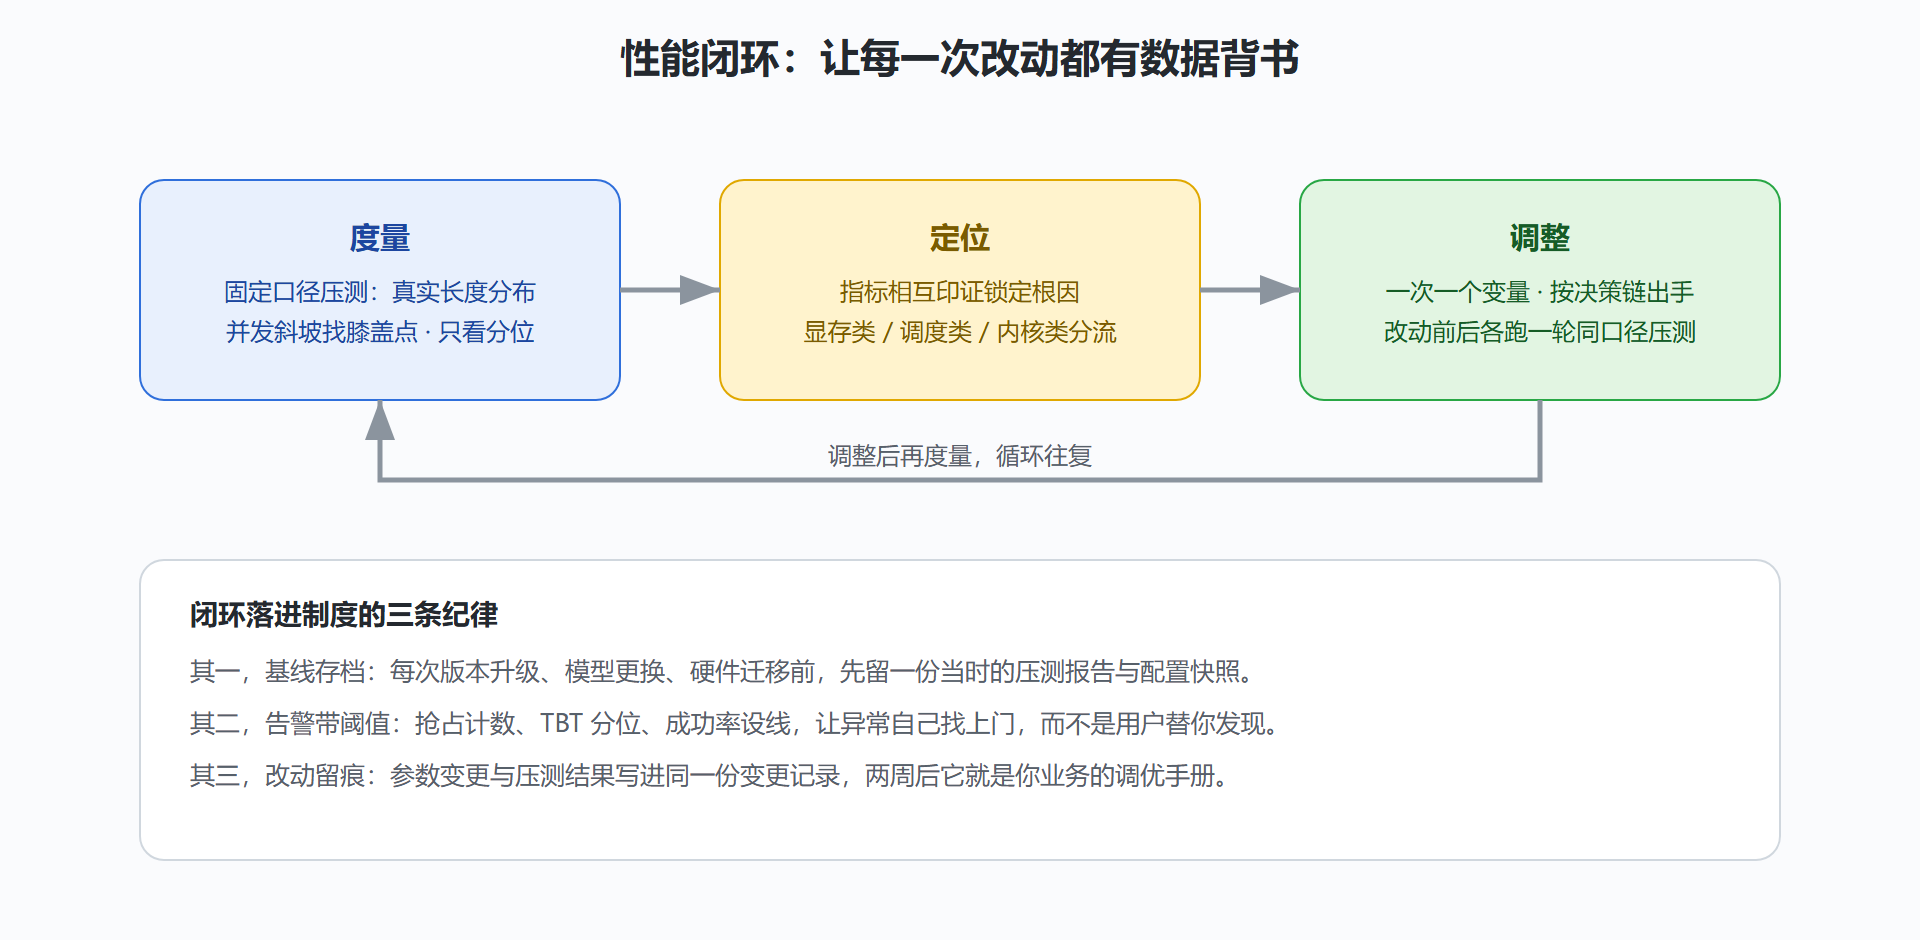
图:调优闭环——度量、定位、调整的循环
从曲线到根因:一张排查对照表
把本册的机制收拢成排查的最后一跳——看到曲线异常,翻表找根因:
- 吞吐台阶式下降,流量未变:先查版本与配置变更记录,再查是否触发持续抢占(8.1 决策链);两者都不是,回放压测定位内核回归。
- TTFT 阶跃抬升:看队列长度。队列空则查 prefill 分摊窗口与缓存命中率(前缀缓存命中率跳水会让 prefill 骤增——第 5 章的提示词改版陷阱);队列长则是容量问题。
- TBT 毛刺:与抢占日志对齐(第 4.2 节);对不齐再查 prefill 混批干扰(第 8.2 节),最后才是网络。
- 成功率下降:区分超时(容量)与拒绝(上下文超限、限流),分别对应容量扩容与参数修正。
排查表会随你的业务生长:每处理一次线上问题,把新的"症状-根因-动作"补进表里。一个季度之后,这张表就是团队最贵重的运维资产。
自建数据集:压测里最容易被偷工减料的一环
很多团队的压测失效,根子不在工具而在数据:拿几十条手写的短请求打几千并发,得到的容量结论与自己业务的真貌毫无关系。自建压测集的正确做法不复杂:从线上日志抽样真实请求(覆盖长度分布与语言形态),脱敏后按比例配成数据集,长度分布与真实流量对齐;没有线上数据时,用业务文档构造长短搭配的样本,至少保证长尾请求占有真实感的比例。数据集一旦定稿就版本化管理——它是所有前后对比的公共地基,换一次数据集,历史基线全部作废。
洪峰演练:压测的进阶形态
常规压测回答"能扛多少",洪峰演练回答"超了之后怎么坏"。具体做法是在膝盖点之上继续加压,观察三件事:抢占出现后 TBT 的恶化形态是否平滑(平滑说明兜底机制健康);等待队列的 TTFT 劣化是渐进还是悬崖(悬崖说明有隐性排队瓶颈);恢复期(压力撤掉后)指标多久回到基线(回不来说明有资源泄漏或缓存颠簸)。洪峰演练的结论写进值班手册——真洪峰来临时,值班同学手里有"这个形态见过、是预期行为"的底气,比什么安慰都管用。
监控的两层:引擎指标与业务指标
本节的指标集属于引擎层(吞吐、TTFT、水位、抢占),它回答"系统健康吗"。完整的生产监控还需要业务层:会话完成率、重试率、用户负反馈率、按模型版本的分流对比。两层用告警串起来:引擎层指标是先行指标(水位贴顶领先于用户可感知的变慢),业务层是结果指标(负反馈率是最真实的裁决)。只看引擎层会陷入"指标全绿但用户在骂"的盲区,只看业务层则永远慢半拍——两层对照,才是完整的可观测性。至此,度量、定位、调整与观察四件事都各就其位,第 8 章的闭环完整了,本册的追因线也走到了终点。
本节要点回顾
- 压测三要素:真实长度分布、并发斜坡找膝盖点、只看分位数;口径不真,数字无效。
- 容量规划按膝盖点的七八成留余量,膝盖之后加并发只制造排队与抢占。
- 仪表盘七项指标各有健康长相,单一指标不定案,相互印证才锁根因。
- 闭环三条纪律:基线存档、告警带阈值、改动留痕。
- 排查对照表是活的文档:每次线上问题都让它生长一格。
到这里,本册的追因线全部走完:从"为什么又慢又贵"出发,翻过显存账本,装上块表与调度器,省掉重复劳动,砍下字节数,最后用一套闭环让性能持续体面。愿你下一次面对推理服务的告警时,手里有账本,眼中有曲线,心中有机制。