5.2 数据传递机制
5.2 数据传递机制
本节摘要:数据过境是 Wasm 互操作的成本大头。数字走栈近乎免费,字符串要过编码与拷贝两道闸,批量数据靠共享内存实现零拷贝,而回调是最贵的一条通道。本节把每条通道的成本构成算清楚,并示范把"高频细粒度互调"改造成"低频批量共享"的标准手法。
别以为调用 Wasm 导出函数和调用 JavaScript 函数是同一种开销——参数与返回值一过边界,性质就变了:数字是免费的直达车,字符串是两次拷贝的慢车,回调则要反向排队。看清每条通道的价格,互操作架构才有设计的依据。
通道盘点:从免费到昂贵
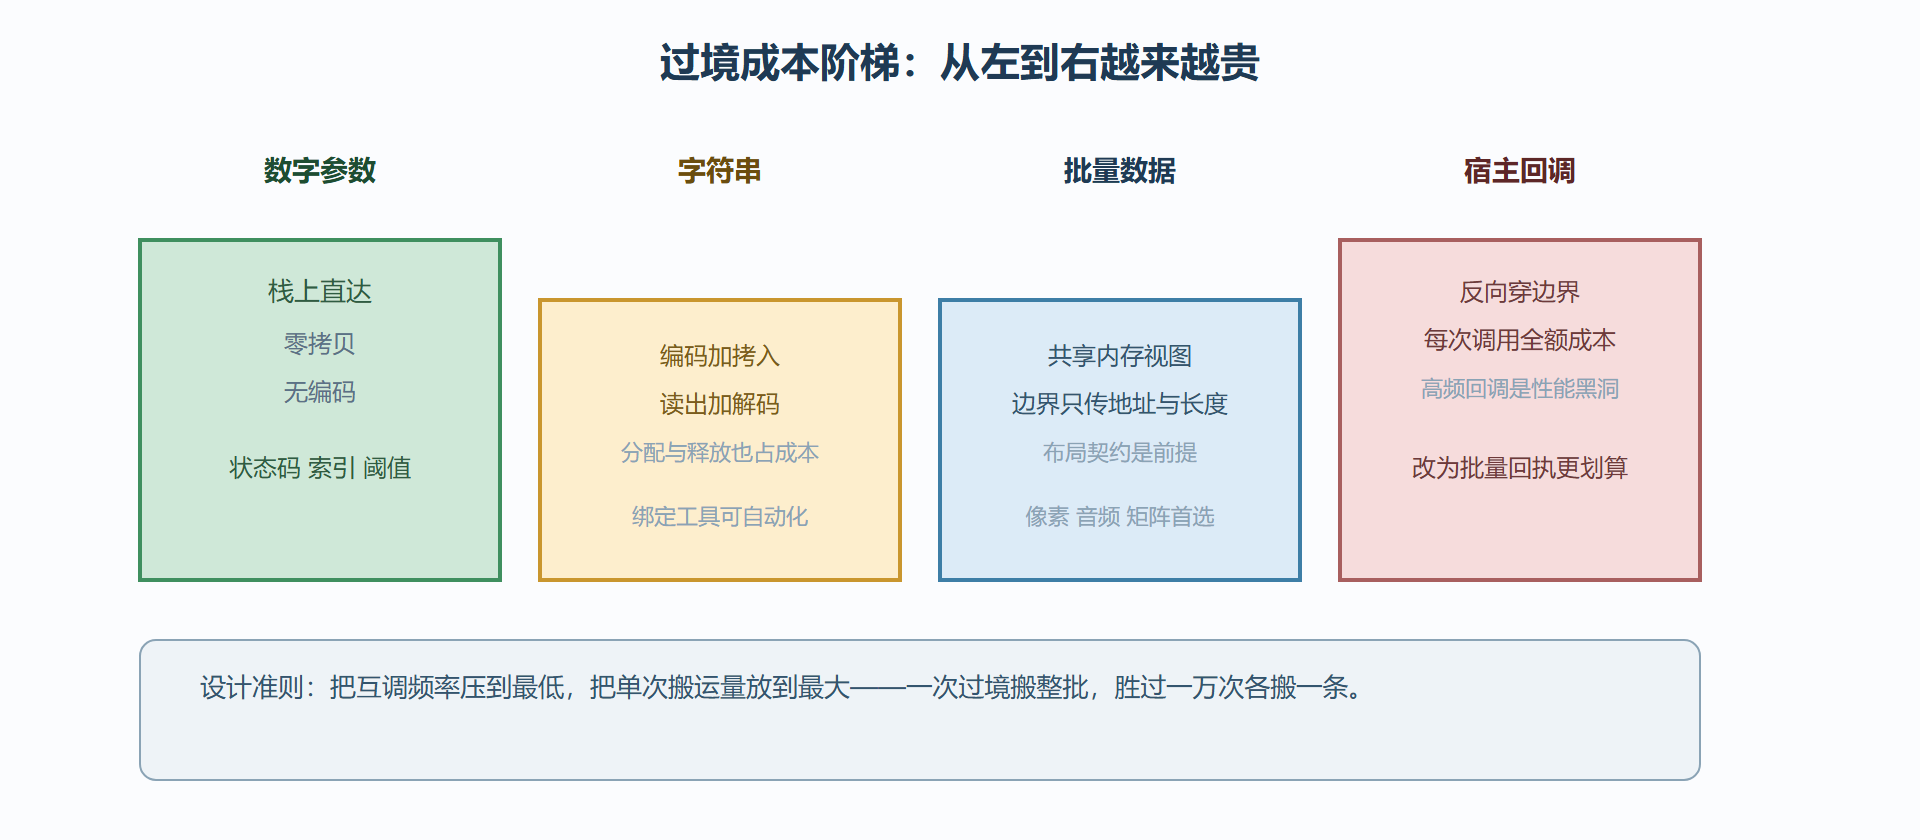
数字通道是唯一的免费午餐。i32、i64、f32、f64 直接在调用栈上过境,无拷贝无编码——i64 例外,在 BigInt 支持不完全的老环境里要经 BigInt 包装,现代浏览器已无此忧。返回布尔、状态码、索引这类单值结果,用它最划算。
字符串通道贵在双向拷贝加编码。字符串过境的标准姿势是:宿主用编码器把字符串转字节写进线性内存,把指针与长度递给模块;返回方向反过来,模块把结果写进约定位置,宿主按指针与长度读出再解码:
const encoder = new TextEncoder(); const decoder = new TextDecoder(); function callWithStr(instance, str) { const bytes = encoder.encode(str); const ptr = instance.exports.alloc(bytes.length); // 模块侧分配 new Uint8Array(instance.exports.memory.buffer) .set(bytes, ptr); // 拷入 const outPtr = instance.exports.process(ptr, bytes.length); const outLen = instance.exports.last_len(); const out = decoder.decode( new Uint8Array(instance.exports.memory.buffer, outPtr, outLen) // 拷出 ); instance.exports.dealloc(outPtr); // 模块侧释放 return out; }
一套互调四次边界操作(分配、写入、读出、释放),外加编码解码——这就是字符串贵的全部原因。频繁互调的 API 若按字符串粒度设计,成本立刻失控;wasm-bindgen 这类绑定工具做的事,本质是把这套繁琐手续自动化并尽量缓存复用分配。
批量数据通道靠共享视图实现零拷贝。大块数值数据(像素、音频帧、矩阵)不需要拷贝:宿主拿类型化数组直接读写线性内存,模块在同一块内存上计算,边界上只传"数据的地址与长度"这两个数字:
// 一次过境:一万条数据只有两个数字跨越边界 const data = new Float32Array(10000); // ...填充数据 instance.exports.sum_f32(data.byteOffset, data.length); // 模块直接读同一块内存
前提是双方对布局达成第三章强调的书面契约:元素宽度、对齐、字节序。数据的"写"由宿主完成、"读"由模块完成,物理上没有搬运,只有语义上的握手。
图 5-A:数据传递通道的成本阶梯
回调:最贵的通道与它的正确用法
模块反向调用宿主函数(回调)的机制由表模型承载:宿主函数被包成表条目,模块经 call_indirect 调用。语义干净,成本不轻——每次回调都是一次完整的边界穿越,外加 JavaScript 函数的调用开销。把回调用在事件级频率(请求开始、任务完成)没问题;用在数据级频率(每处理一条记录回调一次)就是经典反模式:
// 反模式:一万条记录回调一万次 imports.env.on_each = (value) => results.push(value); instance.exports.process_all(inputPtr, 10000); // 改造:模块把结果写进共享内存,回调只通知"一批完成" imports.env.batch_done = (count) => drainResults(count); instance.exports.process_all(inputPtr, 10000);
改造后的结构里,回调退化为完成信号,数据走共享内存——这就是"事件与数据分流"模式:事件走回调,数据走内存。几乎所有高性能 Wasm 集成(编译器、解码器、物理引擎)都长这个形状。
案例全程:日志库的边界改造
把改造思路放进一个完整案例。背景:某团队把日志格式化逻辑用 Rust 写成 Wasm 模块,原始 API 是"每条日志调一次 format(record) 返回字符串",上线后格式化路径的耗时反而高于纯 JavaScript 实现。操作: profiling 显示单次字符串往返约几微秒,而每条日志的处理本身不到一微秒——搬运成本是计算成本的数倍;团队重构接口为批量协议:宿主把一批日志记录序列化进共享内存(一次写入),调用一次 process_batch,模块把全部格式化结果连续写入输出区,最后宿主一次性读出。结果:边界操作从每条四次降为每批四次,格式化路径整体耗时可降到原来的几分之一;模块内还能合并重复的格式化查表。解读:这个案例里算法一行没改,改的只是边界协议——印证本节的核心结论:成本在通道上,收益在协议里。判断标准也简单:单次计算量小于单次过境成本时,就该批量化。变式:批量协议的变体包括"环形缓冲区异步灌入"(宿主持续写、模块定期清)、"双缓冲避免争用"(第六章多线程的标准配置),规模更大的场景还可以把协议描述成接口定义交给绑定工具生成。
本节要点回顾
- 数字免费、字符串贵、批量最划算:按数据形态选通道是互操作设计的第一课;
- 字符串四次操作:分配、拷入、读出、释放加编码解码,绑定工具负责把这层自动化;
- 零拷贝靠共享视图:类型化数组直指线性内存,边界只传地址与长度,布局契约是前提;
- 回调按事件用:反向穿越全额成本,数据级回调必须改成批量回执;
- 协议重于算法:单次计算量小于过境成本时,批量化改造的收益立竿见影。
账本合上,下一节把计算搬进后台工位:Worker、共享内存与 Service Worker 缓存的高级集成模式。