7.3 性能优化技巧
7.3 性能优化技巧
本节摘要:Wasm 的性能优化有三本账:体积账(下载与解析成本)、速度账(执行吞吐)、测量账(没有测量就没有优化)。本节按"先测量、定靶、再动手"的流程组织全部技巧,每条都标明适用条件与代价,拒绝无出处的玄学调优。
wasm-opt、twiggy、火焰图——先把这三件工具的名字立在开头,因为本节的方法论就围绕它们展开:wasm-opt 管字节级优化,twiggy 管体积解剖,火焰图管热点定位。工具之外更重要的是顺序:测量先行,靶点确认,最后才动手——顺序错了,剩下的全是心理安慰。
体积账:下载字节就是下载性能
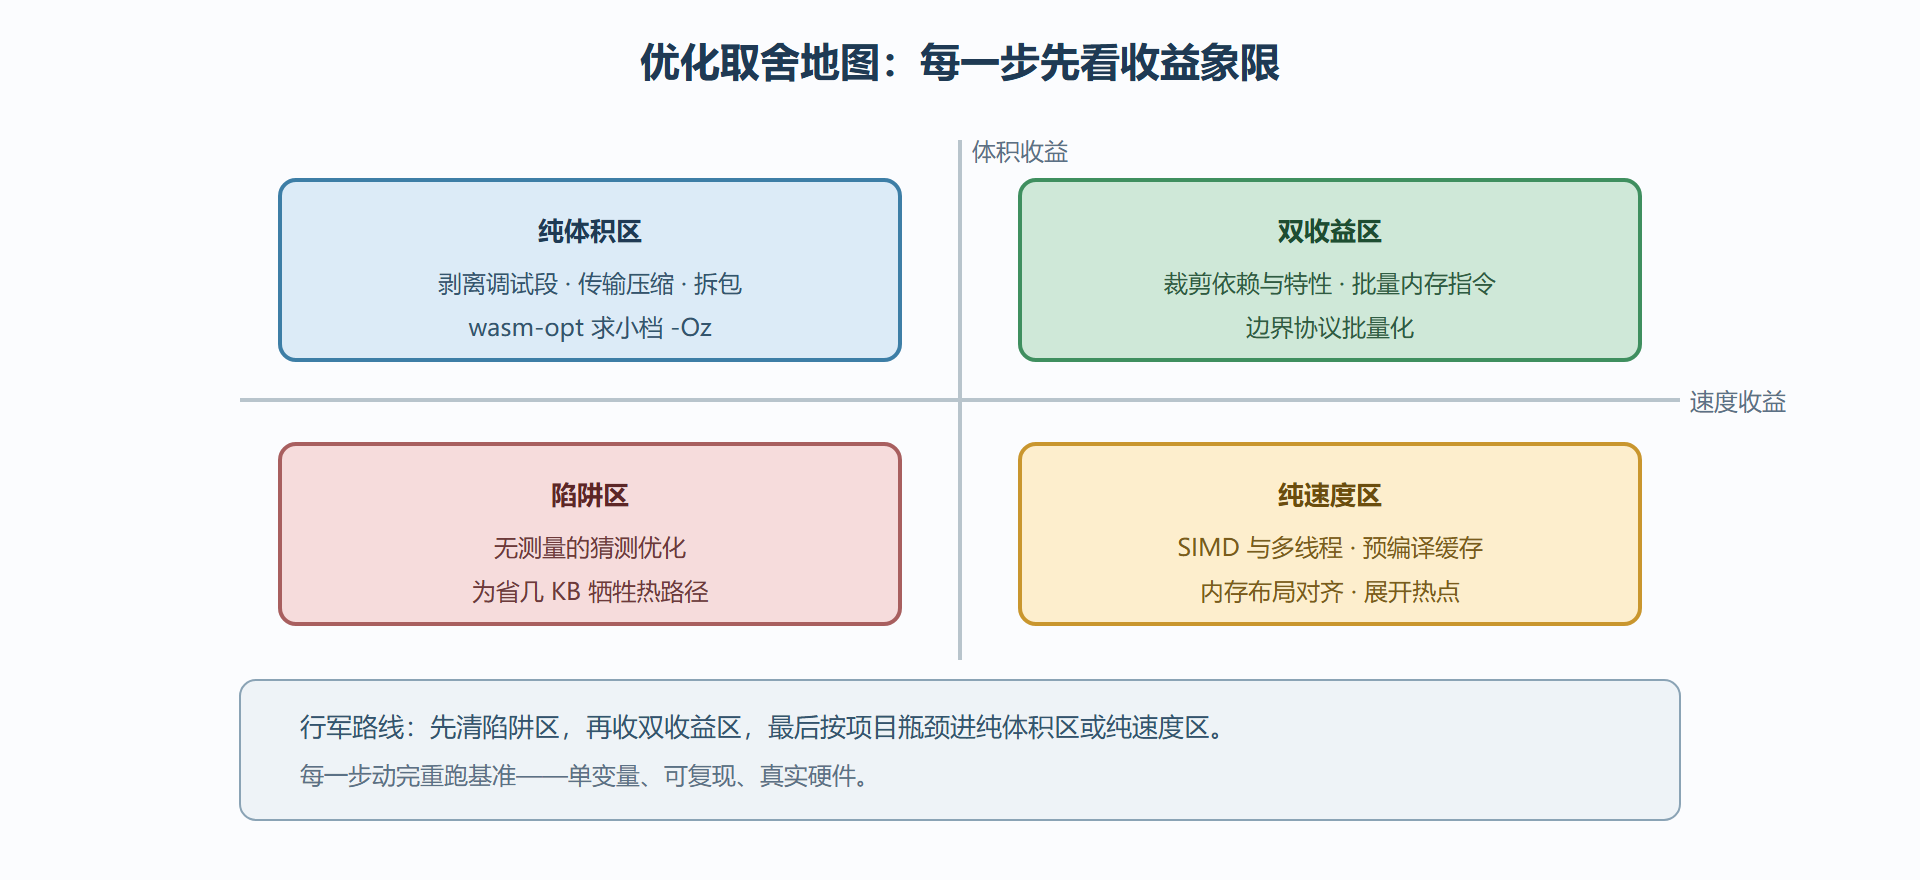
体积直接影响首屏:解析与编译的时间大体随字节线性增长,Web 场景里每 KB 都在关键路径上。体积优化按收益排序走四步。
第一步,解剖:先用分析工具看肥肉在哪,凭感觉裁剪是体积优化第一大忌:
$ twiggy top -n 10 app.wasm # 按体积排函数名次 $ twiggy paths demo_sort # 谁把某个大函数拽进来的
top 列出体积大户,paths 顺藤摸瓜找到引入链。经验分布是:标准库泛型膨胀(格式化、集合、随机数)与异常处理表常年占据大头,业务逻辑反而精瘦。
第二步,裁依赖:语言层关闭用不到的特性。Rust 侧关标准库默认特性、panic 策略改 abort(panic 展开表体积可观且 Wasm 里通常用不上)、日志宏在发布版编译剔除;C++ 侧禁异常与 RTTI 若代码允许。第三步,优化器过机:wasm-opt 的 -Oz 全量跑一遍,第一章讲过的字节级盲区只有它能补。第四步,压缩与拆分:模块字节是高度可压缩的二进制,传输层压缩收益稳定;再按功能拆包(第七章案例的做法),首屏只背必要重量。四步走完,常见工程从数 MB 收敛到数百 KB 量级,具体数字以解剖为准。
图 7-B:体积与速度的取舍地图
速度账:热点通常不在你以为的地方
速度优化的第一原则:剖析开路,直觉殿后。浏览器与独立运行时的剖析器都能按 Wasm 函数聚合采样,火焰图看一眼,热点常在预期之外——过往复盘里高居榜首的从来不是算法复杂度,而是两类结构性问题:边界互调过密与内存访问零散。
边界协议在第五章已立过通则,这里补一条量化判断:单次过境成本与单次计算量之比超过一成,协议就该改。内存布局是第二高产点:热数据结构按访问路径排布(同一循环触碰的字段放一起)、数组代替链表、按缓存行隔离多线程热写字段——第六章的伪共享教训就是布局问题。分层编译的配合常被忽略:短命任务跑在基线编译的代码上,峰值性能根本没启用;服务端长驻服务在预热后再采性能数字,否则测的是解释器与基线层的成绩。最后才是 SIMD 与多线程这两件重武器——它们改代码结构,代价最高,理应最后动用。
测量账:基准的黄金法则
没有测量账,前两本都是糊涂账。基准的四条黄金法则值得写在团队文档里。
其一,环境固定:同一台机器、锁定频率、关闭无关负载;浏览器场景要固定引擎版本并预热 JIT。其二,口径固定:明确测的是什么——端到端延迟、纯计算吞吐、还是含边界互调的完整路径;口径一换,结论就换。其三,单变量改动:一次只改一个旋钮,前后各跑足够多的轮次(毫秒级操作至少上千轮),报中位数与波动区间而非单次最好成绩。第四,真实硬件收尾:开发机的结论只在低端真机复验后才算数——移动端浏览器对 Wasm 的编译与执行策略差异远比多数人预期的大。
基准代码用成熟框架而非手写计时, Rust 侧的 criterion 这类工具自动处理预热与统计:
// benches/pipeline.rs:criterion 基准骨架 use criterion::{criterion_group, criterion_main, Criterion}; fn bench_pipeline(c: &mut Criterion) { c.bench_function("pipeline 1024x1024", |b| { b.iter(|| pipeline_on_shared_buffer()) }); } criterion_group!(benches, bench_pipeline); criterion_main!(benches);
把基准纳入持续集成,性能回归在合并前现形——优化文化的最后一块拼图不是技巧,而是"性能数字也怕回归"的工程共识。
数字之外,性能数据还要配上下文归档:每次基准运行记录引擎版本、机器规格、模块字节与提交号,数据才有可比性。三个月后回看"耗时四十毫秒"时,你需要的不是这个数字,而是它背后的完整环境——没有上下文的性能数据只是噪音。
一次完整的优化演练:把流程串起来
用一个虚构但典型的场景把三本账串成一遍完整演练。起点:图像滤镜服务,模块字节两兆八,单张处理耗时四十毫秒,目标是首屏可接受、处理减半。测量:twiggy 显示两兆中近七成来自异常处理表与调试段;火焰图显示四十毫秒里十二毫秒耗在像素循环、九毫秒耗在边界互调、其余是编译与搬运。动手:按收益顺序动三刀——裁依赖关特性并把 -Oz 加剥离工序(字节降到九百 KB,首屏达标);热点循环消除分支改向量化友好形态(像素循环降到六毫秒);批量接口合并互调(九毫秒边界成本近乎清零)。验收:单张处理十一毫秒,且每刀都有改动前后的基准数据留档。复盘:三刀里没有一刀是"换个更快的引擎"或"手动展开循环"式的玄学——测量指到哪里,刀就落在哪里。这场演练的完整脚本值得团队内部照抄一遍,作为优化流程的教材。
本节要点回顾
- 顺序即纪律:测量先行、靶点确认、单变量动手——顺序错的优化全是心理安慰;
- 体积四步走:解剖、裁依赖、优化器、压缩拆分,凭感觉裁剪是第一大忌;
- 热点两类结构性来源:边界互调过密与内存访问零散,算法往往不是元凶;
- 速度武器按代价排序:协议与布局先行,SIMD 与多线程殿后;
- 基准四法则:环境固定、口径固定、单变量、真实硬件收尾——并纳入持续集成防回归。
三本账合上,实战章节收官。下一章升维到平台视角:生态版图、安全治理与标准演化的走向。