2.1 帧缓冲与像素:一块内存网格的户口本
2.1 帧缓冲与像素:一块内存网格的户口本
本节摘要:帧缓冲(framebuffer)是显存里的一块二维数组,每个元素对应屏幕上一个像素,存着它的颜色。渲染管线的终点,就是用各种算法把这块数组填满。本节讲像素的坐标约定、位深与显存计算、双缓冲与垂直同步的机制,并手写一个最小软帧缓冲。它是第 3 章所有光栅化算法的"落地容器"——没有它,算法算出的颜色无处安放。
学习目标
阅读完本节,你应当能够:
- 说出像素中心的坐标约定(整数在角点还是中心),避免半像素偏移 bug
- 给定分辨率与位深,计算帧缓冲的显存占用量
- 解释双缓冲为什么能消除撕裂,垂直同步在什么代价下工作
- 用数组实现一个最小帧缓冲,并往里写第一个像素
像素到底是什么
把屏幕放大再放大,最后看到的是一格格发光的小方格。像素不是"一个点",而是一块有面积的小区域,这个认识很关键:像素有中心、有边界,后面光栅化判断"三角形盖住哪些像素",判的其实是"哪些像素的中心(或面积)落在三角形内"。
坐标约定有两种流派,混用必出半像素偏移:
约定A:整数坐标 (0,0) 表示左上角像素的左上角,像素中心在 (0.5, 0.5) 约定B:整数坐标 (0,0) 表示左上角像素的中心 老 Direct3D 用 A,OpenGL 用 B,shader 坐标换算时要心里有数
一个经典症状:全屏绘制的图片整体偏了半个像素、边缘一圈发虚,多半就是两种约定在管线交接处没对齐。
帧缓冲的内存账本
帧缓冲本质是一维字节数组,按行优先排布。分辨率越高、位深越大,账本越厚:
单通道 8 位灰度:宽 × 高 × 1 字节 1920×1080 → 约 2.07 MB RGBA8888:宽 × 高 × 4 字节 1920×1080 → 约 8.3 MB HDR 渲染目标 RGBA16F:宽 × 高 × 8 字节 1920×1080 → 约 16.6 MB 4K + 多个渲染目标(G-buffer 常见 3~5 张)→ 轻松数百 MB
这就是第 6 章延迟渲染的代价来源:同时挂多张全屏纹理,显存带宽压力陡增,移动端因此偏好前向渲染。位深还决定色彩精度:8 位通道只有 256 级,暗部做几次乘法累加,色带(banding)就浮现出来;HDR 管线用 16 位浮点存中间结果,最后才压回 8 位输出。
双缓冲与垂直同步:撕裂从哪来
显示器按固定时序逐行扫描帧缓冲。如果渲染还没画完就被扫描读取,屏幕上半部分是旧帧、下半部分是新帧,画面出现一条横缝——这就是撕裂。解法是双缓冲:
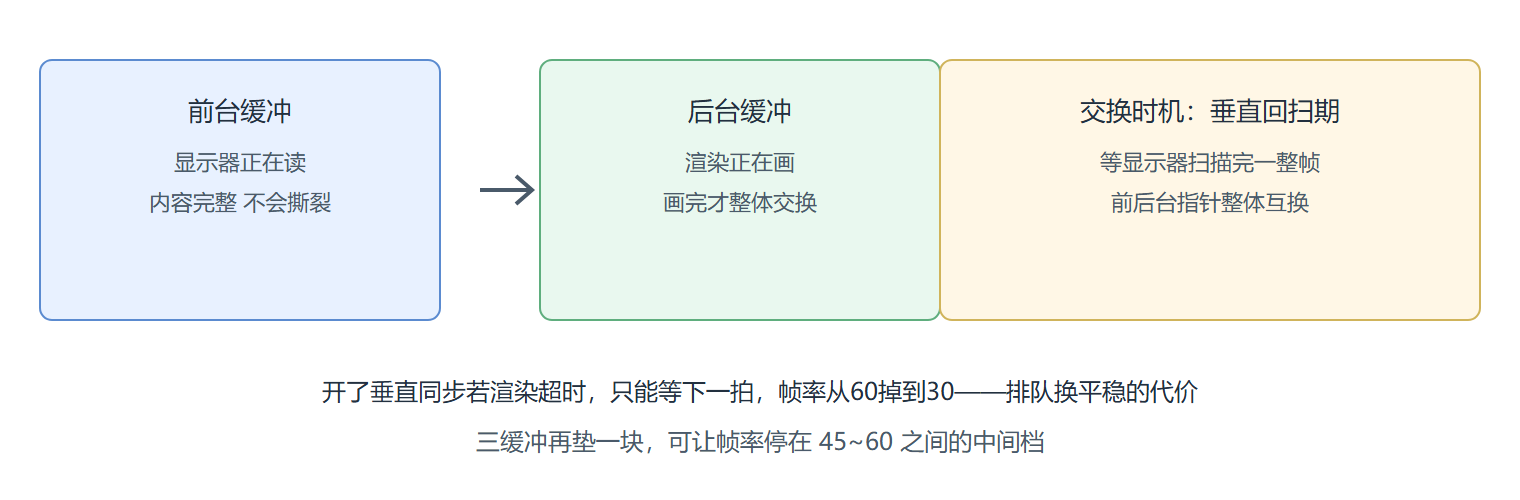
垂直同步(VSync)把交换时机钉在回扫期,消除撕裂但引入排队延迟;游戏竞技场景常关掉它换取最低延迟,画面撕裂交给玩家自己权衡。这一段机制在第 6 章讨论帧率预算时还会回来。
动手:一个最小软帧缓冲
不依赖任何图形 API,用纯数组就能实现帧缓冲的雏形。这既是理解概念的最好方式,也是后面第 3 章所有光栅化实验的画布:
import numpy as np class FrameBuffer: def __init__(self, w, h): # RGBA 各 8 位,初始化为不透明的纯黑 self.w, self.h = w, h self.buf = np.zeros((h, w, 3), dtype=np.uint8) self.alpha = np.full((h, w), 255, dtype=np.uint8) def set_pixel(self, x, y, color): # 整数坐标,y 向下增长;越界直接忽略(裁剪的雏形) if 0 <= x < self.w and 0 <= y < self.h: self.buf[y, x] = color def fill(self, color): self.buf[:] = color fb = FrameBuffer(8, 6) fb.fill((30, 30, 40)) # 深灰蓝背景 for x in range(2, 6): fb.set_pixel(x, 3, (255, 200, 60)) # 画一条 4 像素的亮黄短横线 print(fb.buf[3, 2:6].tolist()) # 输出: [[255, 200, 60], [255, 200, 60], [255, 200, 60], [255, 200, 60]] # 这 24 个字节,就是本教程第一批"出生"的像素
把 buf 交给图像库或窗口 API 显示,屏幕上就有 4 个亮点。整条渲染管线无论多复杂,终点永远是这个循环变体:算颜色,写格子。
案例:从画布到窗口的完整一遍
把软帧缓冲的流程走完整,体会"渲染一帧"到底包含哪些动作。目标:在 24×16 的迷你画布上画一个 8×8 的实心方块,背景深蓝、方块橙黄,然后统计整块画布的字节量——这是一切引擎绘制调用(draw call)的最小缩影。
fb = FrameBuffer(24, 16) fb.fill((24, 32, 84)) # 1. 清屏:整帧重置背景色 for y in range(4, 12): # 2. 绘制:逐像素填方块 for x in range(8, 16): fb.set_pixel(x, y, (255, 170, 40)) # 橙黄前景 changed = sum(1 for y in range(fb.h) for x in range(fb.w) if tuple(fb.buf[y, x]) == (255, 170, 40)) print(f"方块像素数 = {changed}, 画布总字节 = {fb.buf.size}") # 输出: 方块像素数 = 64, 画布总字节 = 1152 # 24×16×3 = 1152 字节——帧缓冲就是这么大的一块裸数组
三个阶段值得点名:清屏(整帧覆写,引擎里对应 clear 命令)、绘制(几何变像素的主体)、呈现(把数组交给显示 API)。真实引擎的复杂度全部堆在第二步——决定哪些像素、什么颜色;而第一、三步几十年如一日地朴素。另一个值得体会的量级感:把画布换成 1080p,同样的清屏动作要写 830 万字节,60 帧每秒就是每秒 5 亿次字节搬运——这解释了为什么 GPU 把"填满带宽"当作第一生产力,也让 6.1 节的显存层级讨论有了必要性。8×8 方块只覆盖 64 个像素,若几何更复杂而屏幕占用更小,大部分变换与着色工作都会白费,这正是第 4 章裁剪与第 6 章 early-z 存在的理由。
本节要点回顾
- 像素有面积:光栅化判的是中心或覆盖率,不是无穷小的点
- 两种坐标约定:角点制与中心制混用导致半像素偏移
- 显存账要会算:宽 × 高 × 每像素字节数,G-buffer 与 HDR 的代价从这里来
- 双缓冲消除撕裂:VSync 排队换平稳,帧率可能整倍跳水
- 软帧缓冲是理解一切 GPU 输出的模型:终点就是填数组
格子的格式定了,下一节回答"格子里该填什么数"——三个数字如何表示万紫千红。