6.1 管线总览与 GPU 架构
6.1 管线总览与 GPU 架构
本节摘要:渲染管线把前五章的算法装配成一条固定流程:顶点数据进、帧缓冲出,中间经过可编程着色器与固定功能硬件的接力。本节总览各阶段的职责与"可编程边界",讲 GPU 为什么长成 SIMT 大并行的样子、warp 调度与分支分歧如何左右性能、显存层级怎么设计,以及图形 API 与着色器语言在流程里的位置。它是第 6 章的地图:后面三节沿这条传送带逐段参观。
本节能力目标
阅读完本节,你应当能够:
- 按顺序列出管线阶段,指出哪些可编程、哪些固定
- 解释 GPU 与 CPU 的设计哲学差异(延迟 vs 吞吐)
- 说明 warp 的执行模型与分支分歧的性能代价
- 描述 GPU 的显存层级(寄存器、共享内存、缓存、显存)与带宽差距
为什么需要一条"管线"
前五章的算法如果串行执行——先变换完全部顶点、再光栅化全部三角形、再逐像素着色——每一步的中间结果(全部变换后顶点、全部片元)都要完整存一遍,显存与带宽吃不消。流水线(pipeline)的思路是切阶段、接龙式处理:像工厂传送带,上一站的半成品直接递给下一站,各站同时开工,吞吐量成倍提升。
更关键的是分工:有些阶段人人需求一致,做成固定功能硬件(光栅化、深度测试),面积小速度快;有些阶段百花齐放(顶点怎么变、像素怎么亮),开放成可编程着色器,开发者写代码注入。这条边界就是现代图形 API 的使用说明书。
顶点数据 → [顶点着色器*] → 图元装配 → [几何着色器*可选] → 裁剪 → 光栅化 → [片元着色器*] → 深度/模板测试 → 混合 → 帧缓冲 [*] 为可编程阶段;其余多为固定功能;带 * 号的三个阶段是开发者代码的主战场
CPU 与 GPU 的设计分野
GPU:为吞吐而生的机器
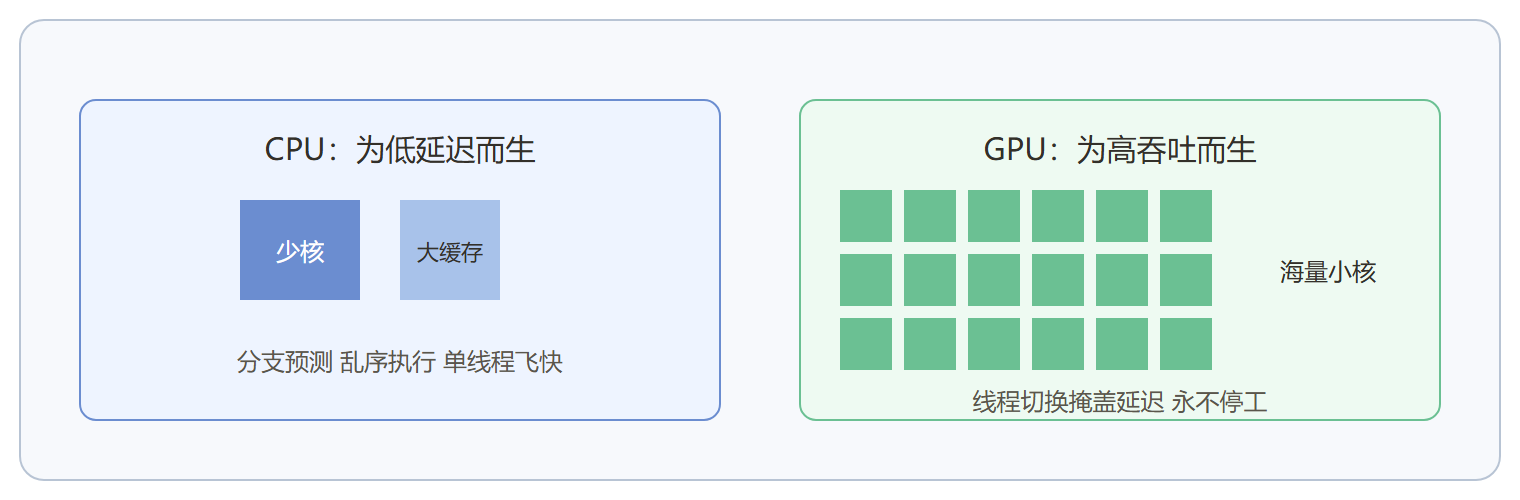
CPU 的设计目标是低延迟:强大的分支预测、乱序执行、大缓存,让单线程尽快跑完。GPU 反其道而行:删掉这些复杂机制,把省出的晶体管全堆成计算单元,靠海量线程的并行掩盖延迟——某批线程等显存?调度器立刻切换另一批上线,机器永不停工。
执行模型是 SIMT(单指令多线程):线程按 32 个(或 64 个)一组打包成 warp,一个 warp 共享一套指令序列,同步前进。光栅化给出的相邻像素天然做同样的事(同一个三角形、同一套着色器),warp 内高度一致,效率惊人。代价在分支分歧:
# warp 分支分歧的示意:32 个线程同时遇到 if frag_color = heavy_glow(p) if p.is_emissive else simple_shade(p) # 若 warp 内 16 个线程走左枝、16 个走右枝,GPU 无法真分头行动: # 两个分支串行各执行一遍,走另一枝的线程空转 # 一个 warp 混合的材质种类越多,空转比例越高
这就是引擎要按材质排序、分批绘制(减少状态切换与着色器切换)的底层原因:让同一个 warp 里尽量装同一种工作。
显存层级也围绕带宽设计:
寄存器(每线程私有,最快) ↓ 约几十周期 共享内存/L1(同一线程块共享,可编程管理) ↓ 约一两百周期 L2 缓存(全芯片共享) ↓ 数百周期 显存(几 GB,容量大但相对慢百倍量级)
着色器代码里的每一次纹理采样都要跑到显存层级取数,5.3 节 mipmap 与压缩格式的价值就在于此:它们直接减少搬运的字节数。
图形 API 与着色器语言站在哪
开发者不直接摸硬件,中间隔着图形 API(DirectX、OpenGL、Vulkan、Metal、WebGPU):定义管线状态、绑定资源、提交绘制命令。着色器用专门的语言写(HLSL、GLSL、MSL、WGSL),编译成 GPU 字节码在可编程阶段执行。一个最小片元着色器的样子:
// WGSL 风格的片元着色器骨架(示意) fn fs_main(in: VertexOutput) -> vec4f { let texel = textureSample(baseMap, sampler, in.uv); // 5.3 的纹理采样 let n = normalize(in.normal); // 5.2 的法线插值 let lambert = max(0.0, dot(n, lightDir)); // 5.1 的漫反射 let linear = texel.rgb * (ambient + lambert * lightColor); return vec4f(pow(linear, 1.0/2.2), 1.0); // 2.2 的伽马回编码 }
四行代码分别引用了第 2、5 章的四个知识点——着色器就是前面所有原理的浓缩落地,这也是为什么本教程按数据流顺序讲到这里才展示它。
一个思考实验:为什么光栅化天生适合 GPU
把 3.1 节三角形光栅化的两层循环摊开看:外层 y、内层 x,相邻像素的计算只差一个增量(重心坐标逐像素递推),彼此零依赖。这意味着几百万个像素可以随意分给几千个核心同时算,不用任何同步——数据并行度近乎无穷。对比一个天然串行的任务(比如物理模拟里前后帧强依赖的积分),GPU 的几千核心只能轮流干活。判断一个算法"吃不吃 GPU",看的不是代码量而是"并行度有多少、访址规不规矩":相邻线程读相邻内存(纹理里的一行)缓存命中率高,随机跳访(链表遍历)则处处缓存失效。这个判断力比记住任何具体参数都值钱,它决定你写的 shader 是跑满显卡还是在空转。
帧预算:管线的第一性约束
2.3 节算过账:60 Hz 屏幕每帧 16.7 毫秒,这 16.7 毫秒要装下 CPU 侧(提交命令、逻辑更新)与 GPU 侧(全部绘制 + 后处理)。管线的每个阶段都可能成为瓶颈:顶点太多、片元太贵、带宽太紧。性能调优的第一步永远是定位瓶颈在哪个阶段,盲目优化(比如减面数去救片元瓶颈)常常白费功夫——这也是 6.2 与 6.3 节分别给出各阶段成本特征的用意。
本节要点回顾
- 管线是分工的流水线:固定功能求快、可编程着色器求活
- GPU 为吞吐放弃延迟:海量线程掩盖等待,SIMT 让相邻像素并行
- 分支分歧是隐形税:warp 内分支越杂,空转越多,材质分批是解药
- 显存层级差两个量级:纹理采样是带宽大户,压缩与 mipmap 直接省钱
- 帧预算是一切优化的靶心:先定位瓶颈阶段,再谈优化
传送带全景有了,6.2 节进第一车间:顶点如何被 MVP 三连乘送进裁剪空间。