1.2 有损压缩的两本账:统计冗余与感知冗余
1.2 有损压缩的两本账:统计冗余与感知冗余
本节摘要:有损压缩的合法性来自两本账——信号内部可预测的统计冗余,与人耳听不见的感知冗余。本节拆解两本账的消除手段(预测、变换、熵编码负责前者;心理声学负责后者),说明率失真权衡如何统一调度它们,并预告 AAC 与 Opus 在"先剥哪本账"上的路线差异。
承接 1.1 的码率账本:1411.2 kbps 的账单要压到几十 kbps,只做无损打包远远不够。本节回答"凭什么敢丢",1.3 节再把"丢给谁裁决"讲透。
为什么无损压缩对音频远远不够
通用无损压缩(ZIP 一类)对 PCM 音频的压缩比通常只有二比一上下,偶尔更差。原因很直接:其建模对象是字节流的可重复模式,而音频的信息分散在波形的相关性与听感的重要性里,字节层面几乎看不出规律。 FLAC、ALAC 这类音频专用无损格式把预测器换成信号模型后,能到二比一至四比一,但天花板依旧明显——因为它们承诺逐样本还原,不敢碰感知这本账。
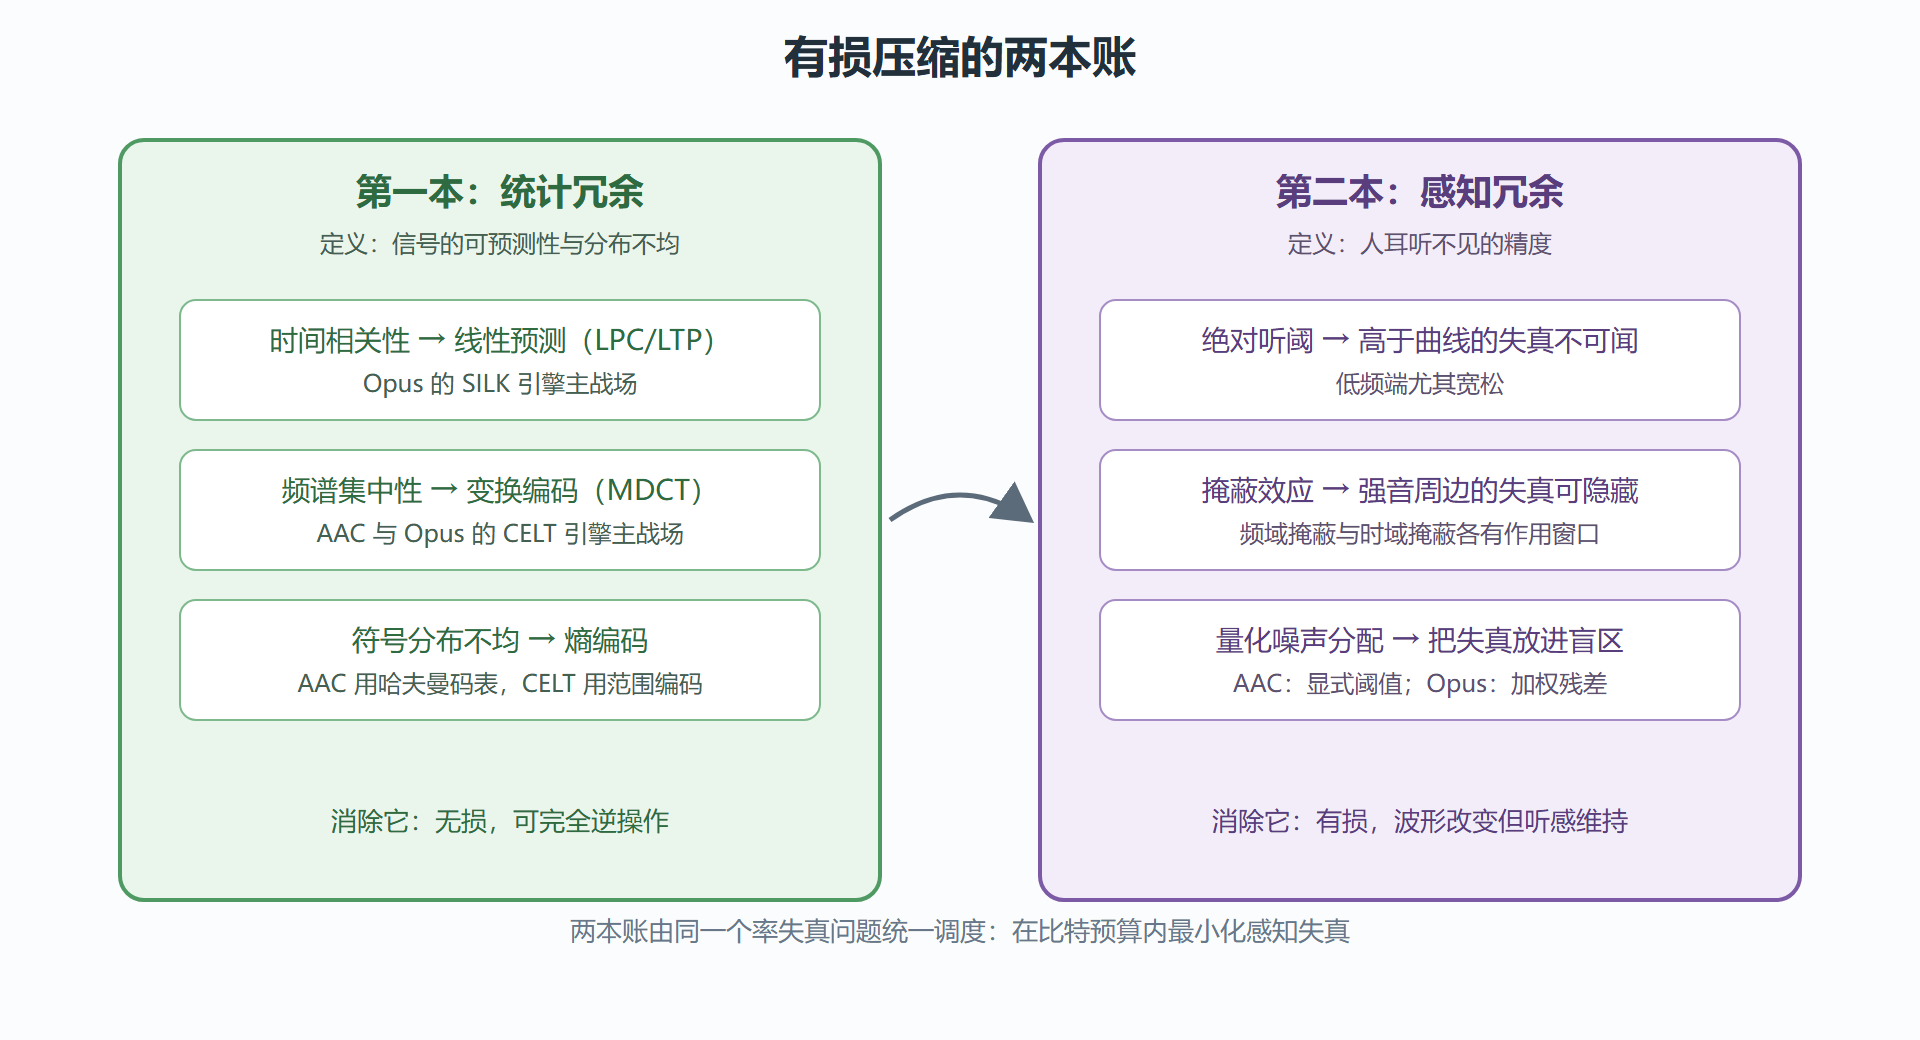
要把码率压掉一个数量级,必须丢数据,而且要丢得有依据。依据就是两本账:
- 统计冗余:信号在时间上相邻相关、在频谱上能量集中、量化后符号分布不均。这些是"信息论意义上多余的比特",消除它不损失任何信息;
- 感知冗余:人耳对某些时间-频率区域里的失真不敏感。这些是"听感意义上多余的精度",消除它会改变波形,但改变落在听觉盲区。
AAC 与 Opus 都同时做这两本账,差别在顺序与重心:AAC 以变换域为主线,先把信号搬到频域再统一按掩蔽阈值分比特;Opus 的 SILK 引擎以时域预测为主线,先剥时间相关性再对残差做感知加权,CELT 引擎则在频域用频带能量约束量化。这个分岔在 1.4 节展开。
图:两本账与各自的消除手段
第一本账的三种消法
预测消时间相关性。 语音与音乐在毫秒尺度上高度相关——下一个样本大概率能用前若干个样本的加权和猜个八九不离十。线性预测编码(LPC)正是把"猜"变成系数:发端与收端共享同一组预测器,只传预测残差。残差能量远小于原信号,同样量化步长下需要的比特显著更少。对周期性强的浊音,再加长时预测(LTP)直接引用上一个基音周期的波形,残差进一步缩水。SILK 引擎就是这条路线的极致:中低码率下它甚至不传完整残差,只用代数码本描述稀疏脉冲的位置与幅度。
变换去相关聚能量。 MDCT 把一帧信号搬进频域后,能量向少数低频系数集中,大量系数接近零——量化后成为长零游程,熵编码极好压。变换本身不丢信息(配合重叠窗可完美重构),丢信息发生在量化那一步。AAC 的 1024 点长窗、CELT 的短窗 MDCT 都属此列。
熵编码削符号开销。 量化后的系数服从尖锐的稀疏分布:零和±小值占绝对多数。哈夫曼编码按出现频率分配码长(AAC 为不同分布形态准备了多张码表);算术/范围编码更进一步,按自适应概率模型逐符号编码,能贴住信息熵下界。CELT 选择范围编码而非哈夫曼,一个现实原因是哈夫曼码字整数位长、逼近熵的效率在极低码率下明显劣化,而范围编码可以按分数位概率分配。
第二本账:敢丢的依据
感知冗余的消除依赖一个前提:失真只要落在听觉盲区,就不构成体验损失。绝对听阈在低频端抬得很高——20 Hz 处要 70 dB SPL 以上才可闻;掩蔽效应让强音在频率轴与时间轴两侧划出阴影区;临界频带的非线性划分决定"多近的频率会互相打架"。这些生理事实合并成一条随信号变化的掩蔽阈值曲线,量化噪声只要压在曲线之下就"免费"。曲线怎么算、怎么读,是 1.3 节的全部内容。
值得注意的是,第二本账的"免费"是有边界的:掩蔽模型建立在对稳态信号与实验室条件的归纳上,遇到突发瞬态(鼓点、爆破音)或级联编码时,模型可能失准,噪声露出阈值被听见——预回声、嘶声加重等典型故障都属此类。调试它们要回到这两本账的框架里找原因,第 5.2 节会给完整的排查路径。
把两本账拧在一起:率失真视角
工程实现里,两本账不是先后执行的两道工序,而是同一个优化问题的两项成本。编码器每帧都在近似求解:给定比特预算,选择量化粒度与工具组合,使感知加权后的失真最小。用拉格朗日形式写成"失真加 λ 乘码率",λ 由预算松紧决定——预算越紧,λ 越大,越倾向粗量化。AAC 的双循环比特控制在解这个问题,Opus 的帧级码率分配也在解这个问题,只是搜索空间与启发式不同。
一段可以跑起来的最小演示,展示量化步长如何在码率与失真之间换档:
import numpy as np def simulate_rate_distortion(coeff, steps): """对给定频域系数扫描量化步长,返回每档的码率估计与失真""" rows = [] for q in steps: idx = np.round(coeff / q) # 量化 recon = idx * q # 反量化 # 零游程+幅度符号的粗略熵估计(比特/系数) p = np.bincount(np.abs(idx).astype(int), minlength=int(np.abs(idx).max()) + 1) p = p[p > 0] / idx.size entropy = -(p * np.log2(p)).sum() dist = np.mean((coeff - recon) ** 2) # 均方失真 rows.append((q, entropy * idx.size, dist)) return rows rng = np.random.default_rng(7) spec = rng.laplace(0, 1.0, 512) # 模拟稀疏频谱系数 for q, bits, dist in simulate_rate_distortion(spec, [1, 2, 4, 8, 16, 32]): print(f"步长 {q:3d} | 每帧约 {bits:7.0f} bit | 均方失真 {dist:9.3f}") # 趋势:步长翻倍,比特约省一档,失真约升三倍(拉普拉斯分布下近似平方增长)
跑完这段代码能直观看到:步长每放大一档,码率下降但失真加速上升,"划算的步长"永远取决于你给失真定的价——这个价,就是心理声学模型开的。
一个验证两本账的小实验
两本账的存在可以用一段十行的 Python 亲手验证。取一段真实音频,分别做两次"压缩":只剥统计冗余(线性预测残差的熵 vs 原始样本的熵),再看加上感知量化后(粗量化残差)的熵变化。原始样本的熵通常在每样本十几比特,残差熵骤降到几比特——第一本账的收益立现;再对残差做感知加权的粗量化,熵进一步下降而听感几乎不变——第二本账的收益也有了。两次下降的比例,大致就是两类冗余在你这段素材里的"储量分布",语音素材两本账都厚、极端合成的素材(纯白噪)两本账都薄。
import numpy as np, wave def entropy(x): hist = np.bincount(x.astype(int), minlength=x.max()+1) p = hist[hist > 0] / len(x) return -(p * np.log2(p)).sum() with wave.open('sample.wav') as w: pcm = np.frombuffer(w.readframes(w.nframes), dtype=np.int16)[::w.getnchannels()] x = pcm[:65536].astype(float) # 第一本账:16 阶线性预测后的残差 order = 16 A = np.linalg.lstsq(np.vstack([x[i:i-order] for i in range(order, len(x))][::-1]), x[order:], rcond=None)[0] resid = x[order:] - sum(a * x[order-k-1:len(x)-k-1] for k, a in enumerate(A)) # 第二本账:对残差做粗量化(感知加权的最简形态) coarse = np.round(resid / 8.0) * 8.0 print(f"原始样本熵 {entropy(pcm[:65536]):.2f} bit/样本") print(f"预测残差熵 {entropy(resid.astype(int)):.2f} bit/样本") print(f"粗量化残差熵 {entropy(coarse.astype(int)):.2f} bit/样本") # 典型输出:原始约 12-14,残差约 4-6,粗量化约 2-3
跑完对着输出读一遍:从十几比特压到两三比特,十倍的压缩里哪几倍来自"可预测"、哪几倍来自"听不出"——两本账各记了多少,一目了然。
💡 关键直觉:把两本账记成"机器嫌重复"与"人耳嫌安静"。AAC 与 Opus 的所有参数旋钮,最终都在调节这两个嫌恶之间的兑换率。
下一节进入裁决者本人:心理声学模型如何把耳蜗的生理特性翻译成一条可计算的掩蔽阈值曲线。