3.2 双引擎架构:SILK与CELT
3.2 双引擎架构:SILK 与 CELT
本节摘要:SILK 用线性预测建模语音的"激励-滤波器"结构,CELT 用短窗 MDCT 与 PVQ 保住音乐的时频细节,混合模式下二者按频段分工(SILK 管低频、CELT 管高频)。本节拆解两台引擎的信号流、模式决策器的判据,以及与 AAC 单引擎架构的成本对照。
3.1 讲了双引擎的来历,本节拆它们的内部结构——这是全册技术密度最高的一节,也是 1.4 节"分岔"在 Opus 内部的展开:一台引擎走加权预测路线,一台走频域能量约束路线。
SILK:把语音发生机制写成代码
语音的物理产生过程是"声带振动 + 声道成形":声带给出准周期激励,声道像一个随口腔形状变化的滤波器,把激励调成共振峰丰富的声音。SILK 的编码流程就是这条生理链的数学化:
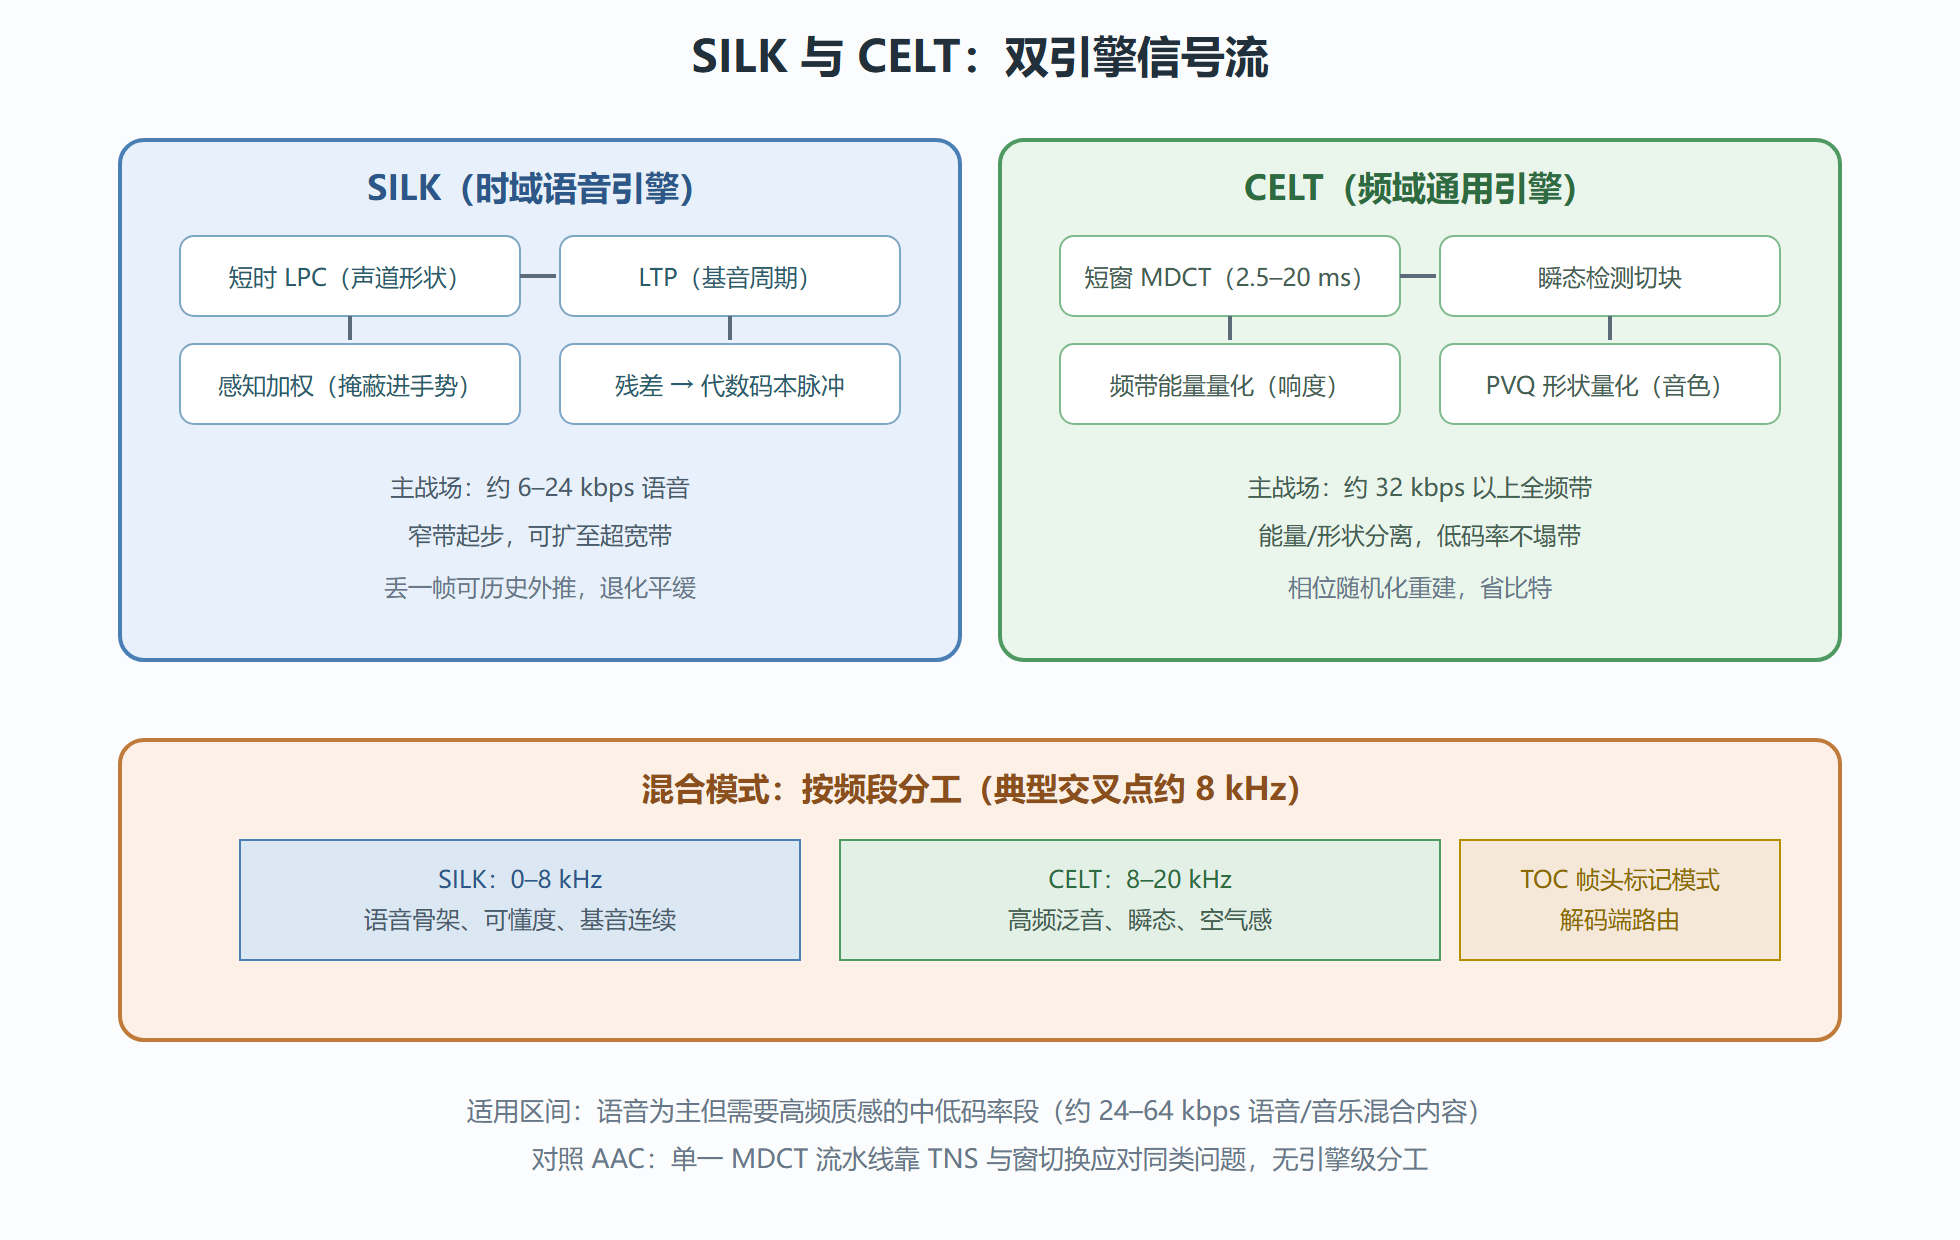
- 短时线性预测(LPC):对每 20 ms 帧求解预测系数,刻画声道的瞬时形状;系数转换到更抗量化的表示(LSF/LSTP 域)后分裂矢量量化;
- 长时预测(LTP):在当前帧里寻找与一个基音周期前最相似的片段,用"增益 + 滞后"描述周期性——元音的长串谐波被这一步大幅压缩;
- 感知加权:由 LPC 系数导出加权滤波器,在共振峰处压低误差权重(1.4 节说的"把掩蔽编进手势"就是这一步);
- 激励编码:对加权后的残差,用代数码本描述——一组带符号的稀疏脉冲,每个脉冲的位置与幅度在网格上量化;低码率时脉冲少而稀,码率升高后脉冲加密甚至改用格矢量量化贴近残差波形。
SILK 的码率覆盖从 6 kbps 左右的窄带语音到 40 kbps 上下的宽带音乐(后者已非其强项)。它的输出天然对丢包友好:丢一帧 LPC 或基音参数,解码端可用历史参数外推,退化平缓。
CELT:为音乐保住时间轴
CELT 的名字直译是"受能量约束的搭接变换",它解决的问题是:MDCT 窗缩到几毫秒后,频率分辨率崩了,怎么还能保住音乐质量?答案是改变量化对象——不精编码每个系数的绝对值,而是分两层:
- 能量层:每个临界频带量化一个能量值,精度优先级最高(听感响度存在感);
- 形状层:带内系数归一化后的方向用金字塔矢量量化(PVQ)编码——把一串系数看作单位球面上的一个方向,量化"指向哪里"。PVQ 的码字天然稀疏、能量守恒,配合范围编码压缩效率极高。
增益与形状分离的意义在于:码率不足时先丢形状精度,能量保住,声音"还响着、还是那个频段",只是细节糊了;而不是整个频带消失。相位信息被有意放弃,解码端用随机相位重建——这对听感几乎无损,却省下大量比特。AAC 的频谱量化没有这层"能量保险",低码率下整带置零产生的频谱空洞(发闷感)在 CELT 里被结构性避免。
图:双引擎信号流与频段分工
模式决策器:每帧一次的裁决
选哪个引擎不是用户的选项,而是编码器逐帧自动裁决的内部状态。判据在 libopus 里综合了多路分析:语音活性与周期性(偏 SILK)、频谱平坦度与瞬态强度(偏 CELT)、目标码率(低码率倾向 SILK 的参数化骨架,高码率倾向 CELT 的波形精度)。裁决输出写入每帧开头的 TOC 字节——配置、带宽、帧长、模式挤在一个字节里,解码端凭它路由数据,无需任何带外协商。
切帧听感无缝的保证是重叠处理与状态平滑:SILK 与 CELT 各自维护跨帧状态,切换点上前一帧的合成器继续收尾。这正是"模式是运行时状态而非配置"的具体含义——对照 AAC 的 Profile(编译期/会话期锁定),粒度差了三个数量级。
用工具可以直接观察模式切换:
# opus_demo 是 libopus 自带的调试工具(随源码构建) opus_demo -e voip 48000 1 -cbr 0 24000 in.pcm out.bit # 编码语音+音乐混合素材后,用分析模式查看逐帧模式选择 opus_demo -d 48000 1 out.bit dec.pcm # 观察 stderr 的帧统计:SILK/CELT/Hybrid 帧计数随内容变化
把一段"说话 + 背景音乐"的素材喂进去,能看到模式计数随段落摆动——这是双引擎架构最直观的可验证行为。
成本对照与边界
| 维度 | 双引擎(Opus) | 单引擎(AAC-LC) |
|---|---|---|
| 覆盖策略 | 两台专机 + 自动换挡 | 一台通用机 + 工具补丁 |
| 极端码率韧性 | 6 kbps 语音仍可懂 | 低于约 32 kbps 明显劣化 |
| 引擎切换开销 | TOC 一字节 + 状态维护 | Profile 级别切换需重配置 |
| 实现复杂度 | 两套引擎的状态与测试面 | 一套流水线,工具间耦合 |
| 音质天花板 | 高码率下优秀 | 高码率下精细度仍占优 |
最后两行是公允的边界:双引擎的代价是工程复杂度(要维护与测试两套机器的切换矩阵),且在 128 kbps 以上的音乐档,CELT 的噪声藏匿精细度仍略逊于打磨更久的 AAC 心理声学机器——这也是第 4 章音质对比里 AAC 保住的那一局。
历史战绩与两个常见误解
双引擎设计在公开评测里的战绩可以概括成"两端强、中间稳":语音端(8 kbps 上下的窄带与宽带档)长期领先同码率的所有通用编码器,这是 SILK 血统的直接兑现;音乐端在 96 kbps 以上进入优秀区间,但在 160 kbps 以上的精细档仍略逊打磨更久的 AAC 心理声学机器——两端的表现都符合架构预期。中间段(24 至 64 kbps 的混合内容)是双引擎的"展示区":语音与音乐交织的素材(播客、游戏音效加语音、会议共享伴奏)由混合模式接管,各取所长的收益最明显。
两个常见误解需要澄清。误解一:"Opus 检测到语音就用 SILK、检测到音乐就用 CELT,所以我要手动指定。"事实上模式选择完全自动,且用户没有直接开关——应用类型提示(VOIP/AUDIO)只是影响决策器的倾向权重,不是硬切换。想验证模式行为,用 opus_demo 的统计输出观察帧分布(前文已给命令),而不是找不存在的开关。误解二:"混合模式是两个引擎的简单平均。"实际上混合模式有严格的频段分工与能量衔接处理,跨界处的频谱连续性由专门的过渡机制保障——听感上"无缝"正是这些看不见的衔接在兜底。
顺带一个实现侧的提醒:libopus 的版本升级通常带来编码质量改进(解码格式冻结、编码器持续优化),但也会改变帧级决策行为——升级后用 5.3 节的基线流程回归一遍,是团队级使用的基本纪律。
💡 关键直觉:SILK 与 CELT 不是"语音版和音乐版"两个产品,而是同一码流里的两套坐标系——时域的"预测坐标系"与频域的"能量坐标系"。模式决策器做的事,是每帧挑一个描述当前声音更省比特的坐标系。
引擎定了,下一节看油门与挡位:码率、带宽、帧长、复杂度四个维度怎么按场景配。