5.3 工具链实战:FFmpeg、libopus与听感验证
5.3 工具链实战:FFmpeg、libopus 与听感验证
本节摘要:一条完整的调参流水线由四段组成——编码器工具(FFmpeg/opusenc/fdk-aac)、检查工具(码流与元数据核查)、分析工具(频谱与客观指标)、验证工具(ABX/MUSHRA 听感)。本节按"改参数 → 编码 → 核查 → 分析 → 听感"的闭环给出命令集与脚本骨架,并点出各环节的高频坑。
5.2 节解决了"坏了怎么查",本节解决"怎么让好坏可复现":把调参从手艺活变成流水线。命令集按闭环组织,可以直接抄进项目脚本。
编码段:两套命令族
Opus 侧用 opus-tools(官方工具,暴露参数最全)或 FFmpeg 的 libopus 封装:
# opusenc:官方编码器,参数语义最清晰 opusenc --bitrate 64 --music --vbr input.wav music64.opus opusenc --bitrate 32 --speech --cvbr --framesize 20 talk32.opus < input.wav # 常用开关:--music/--speech 内容提示;--framesize 帧长;--comp 复杂度; # --expect-loss 预估丢包率(联动 FEC 冗余量) # FFmpeg 路线(适合与容器/滤镜流水线组合) ffmpeg -i input.wav -c:a libopus -b:a 64k -vbr on -compression_level 10 out.opus
AAC 侧的注意点在 2.1 已提过:FFmpeg 自带编码器适合中高码率,低码率场景优先 fdk-aac——
# 高质量 AAC 链(需自行构建启用 libfdk_aac 的 FFmpeg) ffmpeg -i input.wav -c:a libfdk_aac -profile:a aac_low -b:a 128k lc128.m4a ffmpeg -i input.wav -c:a libfdk_aac -profile:a aac_he_v2 -afterburner 1 -b:a 32k he32.m4a # afterburner 提升编码质量换取编码耗时;低码率 HE 场景建议常开
核查段:别信文件名,信码流
编码产物先过一遍"身份核查"再进分析——工单里一大半"编码器问题"其实是参数没生效:
# Opus:查实际编码参数与逐帧统计 opusinfo music64.opus # 输出:采样率、声道、码率模式、平均码率、帧长分布 # AAC/MP4:查流与元数据 ffprobe -v error -show_streams -show_format lc128.m4a # 重点看:profile、采样率、声道、码率;HE 流注意采样率标注与实际带宽的关系 # ADTS 裸流快速核查 ffprobe -v error -show_entries stream=codec_name,profile,sample_rate out.aac
核查段的高频坑:VBR 流的名义码率与实际平均码率可差两成(正常);HE-AAC 的采样率标注是输出采样率,核心带宽要减半理解(2.3 节的交叉频率问题在这里现形);容器声道标注与实际解码输出不一致时,先查封装再怀疑编码器。
分析段:频谱图 + 客观指标
频谱图是音频工程师的 X 光片(5.2 节已多次使用)。客观指标补上"量化"一维:
# 频谱三连:原始 / Opus / AAC 同窗对比 sox input.wav -n spectrogram -o s0.png sox music64.opus -n spectrogram -o s1.png sox lc128.m4a -n spectrogram -o s2.png # 波形与响度:检查响度漂移与削波 ffmpeg -i music64.opus -af astats=metadata=1,ebur128 -f null - 2>&1 | findstr /C:"I:" /C:"Peak"
读频谱的三个固定动作:看高频截止(带宽问题)、看时间轴上的竖纹(瞬态处理)、看背景纹理均匀度(噪声整形质量)。客观指标用 ViSQOL 类工具跑相似度分(4.2 节的适用范围提醒仍然有效:音乐素材别用 PESQ)。
听感段:把 ABX 变成脚本
流水线的最后一环必须落回人耳,ABX 的最小化做法:
# 一次 ABX 会话的素材准备脚本骨架(配合任意 ABX 工具使用) import subprocess, random PAIRS = [ ("原始", "input.wav"), ("候选A 64k", "music64.opus"), ("候选B 96k", "music96.opus"), ] TRIALS = 10 for i in range(TRIALS): x = random.choice(PAIRS[1:]) # 随机取待测 # 输出 A=原始 B=另一待测 X=x 的播放清单,交给盲听执行 print(f"trial {i+1}: X 来自 {x[0]}(答案保密,记录判对与否)") # 判对率 >= 75%(10 次里 8 次以上)视为差异可闻的经验阈值
骨架的意义在流程而非代码:固定素材、固定次数、盲化身份、记录判对率——四件事齐了,结论才有统计含义。
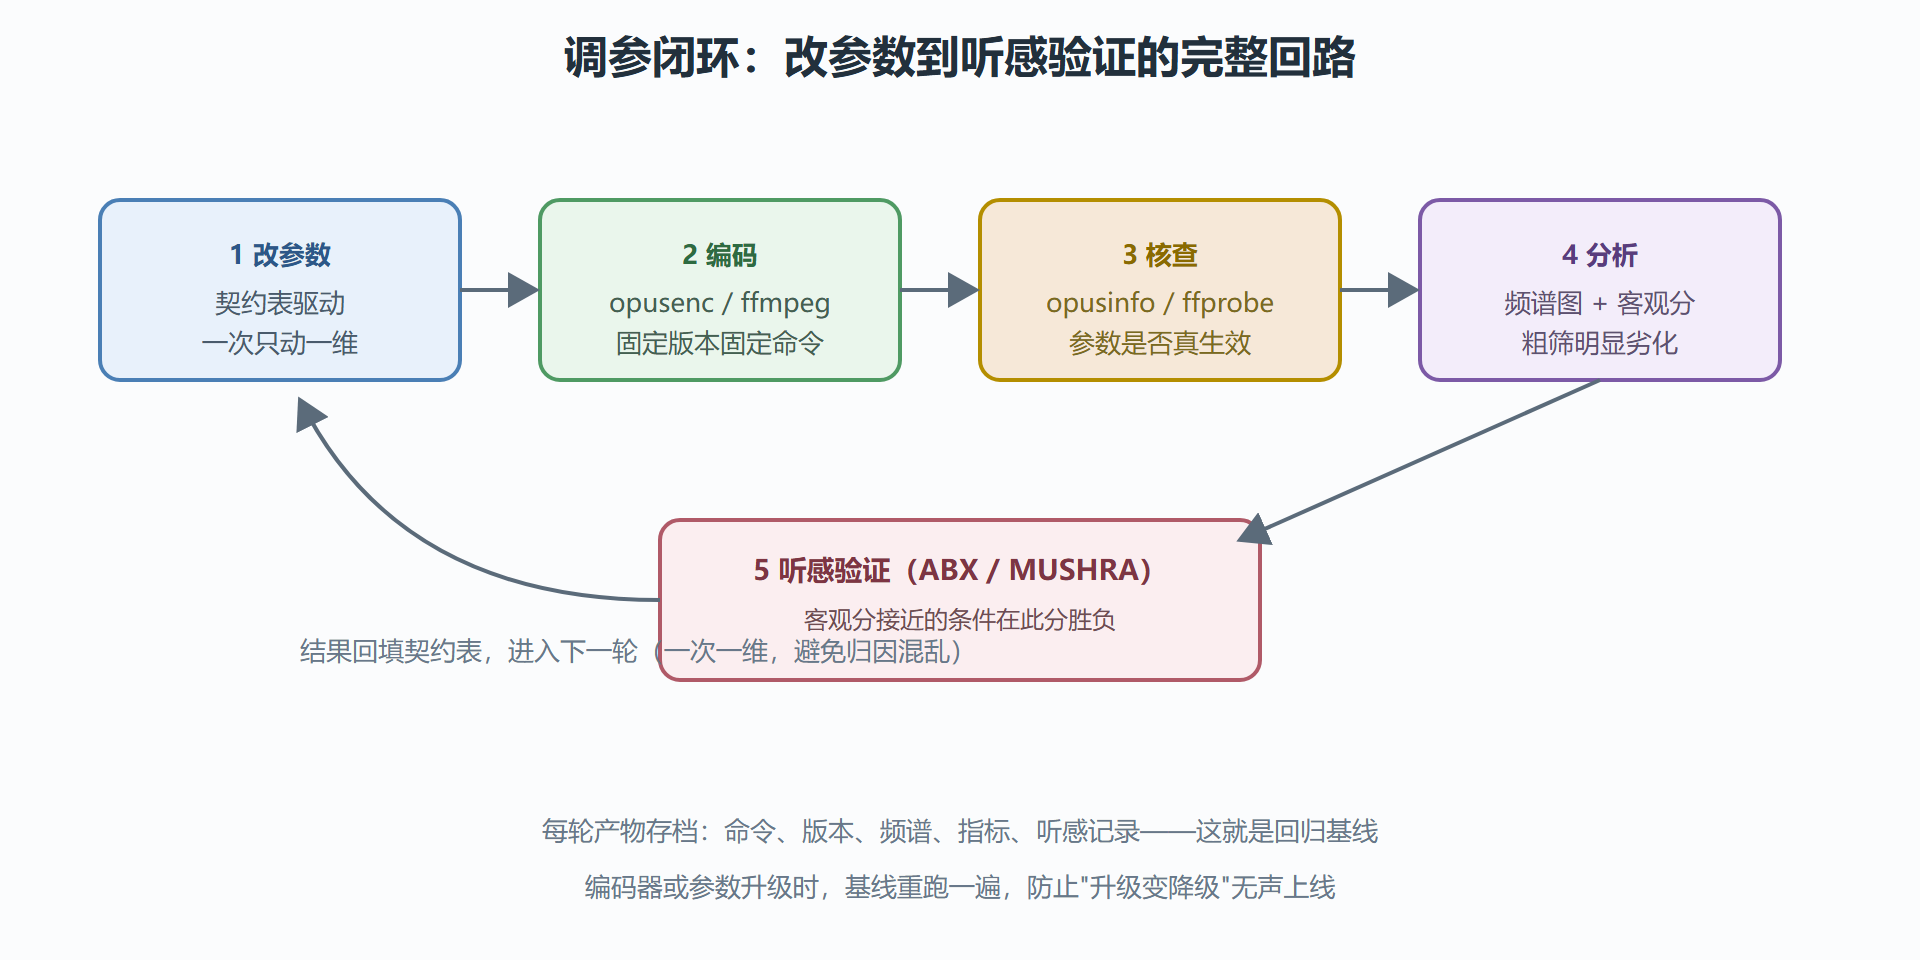
图:调参闭环流水线
工程化收尾:版本与基线
流水线真正的价值在"可复现"二字,两个习惯决定成败。其一,锁版本:FFmpeg、libopus、fdk-aac 的版本差异足以改变听感结论(Opus 编码器每个小版本都在改进质量),所有结论必须绑定版本号记录。其二,存基线:每轮调参的命令、频谱、指标、听感记录归档;升级编码器或改档位前重跑基线——没有基线的"感觉变好了",在回归时一文不值。
版本与基线的管理细则
把"锁版本、存基线"细化成三条可执行规则。规则一:环境快照——每次正式评测前,记录 FFmpeg 版本号、libopus 版本、fdk-aac 版本与编译选项(联编脚本入库),环境变了结论作废。规则二:基线包结构——每个档位一个目录,内含源素材、编码命令脚本、产物、频谱图、指标输出与听感记录六样东西;目录名带日期与版本哈希。规则三:触发式重跑——编码器升级、参数契约变更、疑似质量回退三类事件触发基线重跑,新旧对比报告归档。
这套细则的投入约一天,回报是所有历史结论随时可复现。没有它,"上个月还好的音质这个月变差了"这类问题只能靠回忆考古;有了它,重跑一遍基线十分钟定位到是版本行为变化还是素材变化。
另一个容易忽视的实践:给团队共享一套"标准命令集"文档(本节的命令按业务场景编目),新人入职照单执行即可产出一致的编码结果。工具链成熟的标志不是命令多 fancy,而是不同的人、不同的时间,跑出一样的结果。
⚠️ 常见坑:流水线里最常断的一环是"核查"。跳过 opusinfo/ffprobe 直接听,参数没生效的产物浪费整轮听感测试;第二常见的是"一次改多维"——码率与复杂度同改,赢了不知道归功谁,输了不知道怪谁。闭环的铁律:一次一维、先核后析、以听感收尾。
💡 关键直觉:工具链的本质是给"耳朵"配一台示波器。命令和脚本是仪表,基线是刻度,闭环是测量规程——三者齐备,调参才从玄学变成工程。
工具链就位,下一节做一次全链路演习:一场万人直播的音频预算,从延迟瀑布到带宽成本完整算一遍。