11.1 并行计算原理
11.1 并行计算原理
末章的技术纵深从一道现实的算术题开始:千万网格的瞬态算例单机要跑一周,交期只剩三天。并行计算把计算分给多核多机,但加速不是免费的——本节拆解并行的开销结构(分区、通信、负载均衡、串行占比),给出核数选择的工程方法,并用一个扩展性实测案例演示"加核加到哪一步该收手"。这是全书从算例尺度走向产线尺度的接口。
并行发生了什么:域分解的账本
Fluent 的并行模式把网格切成若干分区(partition),每个核负责一个分区:自己单元的方程自己解,分区边界上的面通量与邻居交换信息(通信),矩阵求解的多重网格层间也要全局协调。开销由此分成三笔账。通信账:分区面越多、交换越频繁,花在通信上的时间越多——通信量与分区表面积成正比,计算量与分区体积成正比,所以分区越"瘦长",通信占比越高。负载账:各分区单元数不均时,最慢的核决定整体节奏,快核干等。串行账:汇总统计、I/O、某些全局操作无法并行,按 Amdahl 定律给加速比封顶——串行占比百分之一的程序,理论上限一百倍加速,现实里远到不了。
三种典型分区几何的通信特征值得对照记忆:立方体域切成等大块,表面积体积比适中;扁平域(薄板、间隙)分块后表面积占比高,通信成本上升;长条域沿长向切分最经济。分区质量指标直接映射到求解器里观察到的并行效率。
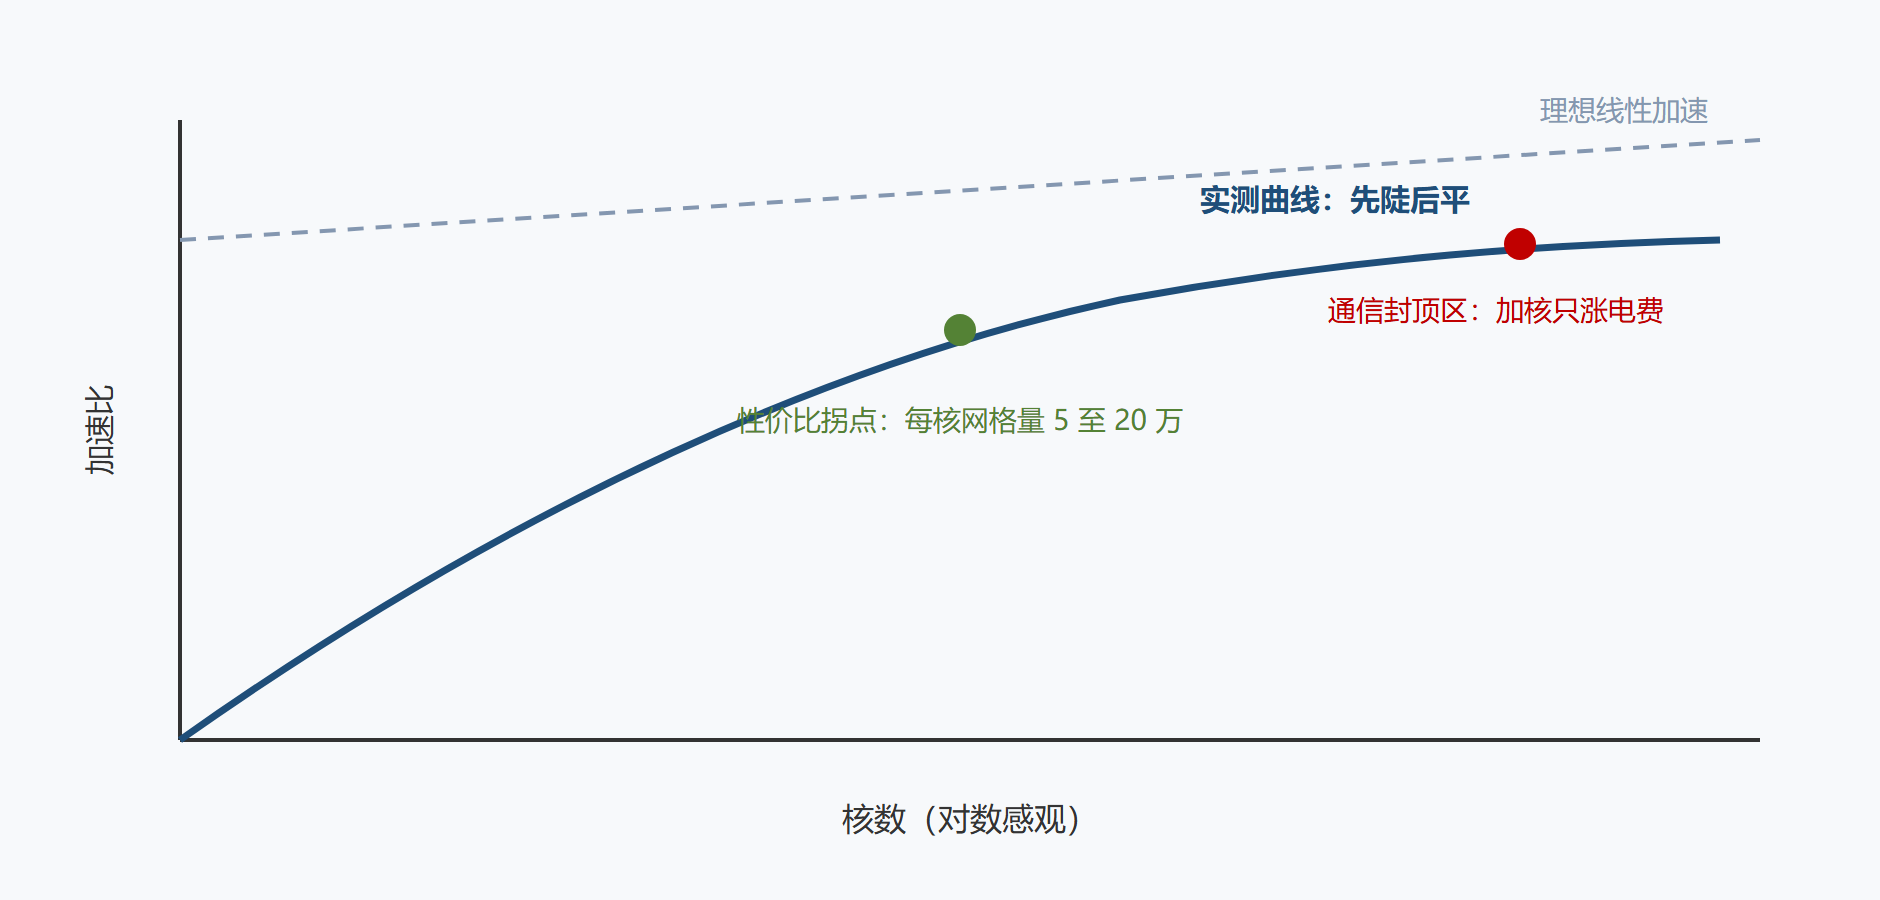
图 11-1:加速比的收益与两道天花板
核数怎么选:拐点法与经验区间
工程上不需要理论最优,只需要"不浪费"。两条经验法则可以覆盖大多数决策。其一,每核网格量的性价比区间:单精度网格量每核五万到二十万单元之间通常是效率甜区,少于两万时通信占比飙升,多于五十万时单核耗时又拖长尾。其二,扩展性实测:正式批量投产前,取代表性算例在候选核数(比如八、十六、三十二、六十四)各跑固定迭代步,画耗时曲线,拐点处取核数。案例一节会给完整数字。此外按物理记忆:瞬态与燃烧、多相类源项密集算例的通信占比更高,甜区核数比同网格量的纯流动算例更靠左;混合并行(单节点多线程加跨节点进程)在现代硬件上是默认姿势。
案例千万网格外流的扩展性实测
背景。某整车外气动项目,网格三千二百万,瞬态滑移网格(第八章技术)加 LES 混合模型,交期要求单周期统计不超过两天。团队租用的节点规格为每节点六十四核,需要决定用几个节点。
操作。固定一千步迭代做基准测试:十六核、六十四核、一百二十八核、二百五十六核四档各跑一遍,记录墙钟时间与并行效率(相对十六核的加速比除以核数比)。同时记录分区统计:各档的分区面数量与平均每核单元数。
结果。耗时分别为每千步七点二小时、二点一小时、一点二小时、零点九小时。以十六核为基准的并行效率:六十四核百分之八十五,一百二十八核百分之七十五,二百五十六核百分之五十八。每核网格量在二百五十六核时降到十二点五万仍处甜区,但通信耗时占比从百分之六升到百分之十九——拐点判定在一百二十八核附近,选两节点一百二十八核方案:单千步一点二小时,一个统计周期约二百小时压进两天线以内,再往上加核收益不抵通信恶化。
解读。案例的方法论价值超过数字本身:扩展性实测把"该用多少核"从经验拍板变成一小时的数据决策;效率与通信占比两个指标互相印证,解释了曲线为什么平——没有诊断的加速曲线只是一条线,配上开销分解才知道每一核的钱花在哪。
变式。加速卡(GPU)路线:Fluent 支持把矩阵求解卸载到 GPU,千万网格级算例的单节点性能可达多 CPU 节点水平,适合网格量大、迭代为主的算例;混合精度与线性求解器设置是 GPU 路线的新调参面。I/O 瓶颈场景(频繁写盘的瞬态)先优化写出频率与格式,再谈加核。
并行配置问答与排错表
分区方法怎么选。默认自动分区在多数网格上够用;界面交换密集的算例(滑移网格界面、共轭交界面)优先保证界面所在面的分区完整度——分区方法的目标是少切重要界面,而不是几何上好看。
并行不稳定或偶尔挂起先查什么。按序查:分区负载统计是否失衡、节点间网络是否丢包(互连测试)、内存是否触顶(换页是挂起的常见真相)、文件系统并发写是否冲突。四项覆盖九成现场问题。
加速卡与 CPU 路线怎么分工。迭代为主、网格量大的算例优先试加速卡路线;边界与源项逻辑复杂(大量 UDF、复杂耦合)的算例 CPU 路线更稳。两条路线不是替代关系,是按算例画像分流的取舍。
并行异常速查:
| 现象 | 多半原因 | 处置 |
|---|---|---|
| 加速比远低于实测拐点 | 分区失衡或界面切割差 | 看分区统计重分区 |
| 节点间扩展掉得厉害 | 通信占比高或互连瓶颈 | 查通信占比与网络 |
| 随机挂起无报错 | 内存换页或 I/O 堵塞 | 监控内存与磁盘水位 |
| 结果随核数变化 | 线性求解器并行容差 | 固定容差复核口径 |
核数选择之外还有一个经常被误诊的话题:为什么同一模型换台机器耗时差异巨大。影响链条从硬件到软件有四层:单核频率与内存带宽(带宽常是网格类应用的真瓶颈,频率高不等于快)、互连网络(跨节点通信的每次握手都被放大)、求解器并行配置(分区与缓冲)、以及版本差异(并行实现逐年优化)。诊断方法是分层对照:同一版本同核数跨机型跑千步基准,差异定位到硬件层;同机型跨版本跑,定位到软件层。把基准记录留档,新机器采购与新版本升级的决策就从体感变成数据。
补最后一个面向未来的话题:算力预算的"单位经济学"。并行配置的终点不是技术参数,而是一张单位成本表——每个设计方案评估要多少核时、折算多少费用与工期。有了这张表,方案讨论的维度立刻升级:可以量化"多用一倍算力换取设计空间加密一档"是否值得,也可以在汇报时把仿真部门的产能翻译成管理层听得懂的语言(每季度可评估的方案数)。技术参数回答"能不能跑得动",单位经济学回答"值不值得跑"——高性能计算章节的落点,恰恰在计算之外。
本节验收点
- 批量投产前完成扩展性实测,核数取性价比拐点而非上限。
- 并行效率与通信占比同时监控,加速曲线配有开销分解。
- 分区质量检查入档:各分区单元量偏差在百分之五以内。
- 每核网格量处于甜区区间,或偏差有解释。