第3章 · 图优化与算子融合机制
第3章 · 图优化与算子融合机制
本章回答的核心问题
前两章回答了"为什么加速"和"TensorRT 由什么组成",第3章进入性能的最核心来源:优化到底把时间省在了哪里。一个未优化的 ResNet-50 在 V100 上推理需 12ms,经 TensorRT 图优化后仅需 3.8ms——差异不在 CUDA 核函数的微观调优,而在那张被反复折叠、剪裁、重织的计算图之中。
长久以来,框架的推理流程被默认为"忠实执行":前端定义图,后端依序调度算子。这种范式在原型验证阶段足够友好,却在部署战场暴露致命缺陷——把语义冗余与硬件失配一同封装进执行路径。TensorRT 的革命性在于彻底否定了"图即执行"的朴素假设,引入编译器级心智:把输入计算图视为待编译的中间表示,而非待执行的指令序列。图不再是静态拓扑,而是可塑性极强的语义网络;算子不再是原子操作,而是可分解、可重组、可内联的语义单元;内存不再只是数据容器,而是可规划、可复用、可生命周期绑定的稀缺资源。
学习目标
- 说清本章在 问题驱动 叙事中的位置
- 列出两项 SOURCE 可验证事实
- 完成章内至少一节的对照表或算例
本章的三根支柱
- 3.1 静态计算图优化理论:回答"优化的合法性边界在哪"。静态图把不确定性的熵主动收敛,用三条公理(语义保持、计算等价、硬件映射友好)划定了优化边界。融合的本质是计算粒度的重新定义——垂直融合沿计算链深度压缩,水平融合沿数据分支广度整合;结构性剪枝则是基于形式化验证的外科手术。
- 3.2 内存复用与管理优化:回答"数据放在哪里最省"。生存期区间分析把内存复用形式化为区间图着色问题,Workspace 显存池机制是确定性调度的中枢神经,权重重组与内存对齐在比特层面重铸数据通路。一个 10GB 模型在 TensorRT 中可能仅需 3.2GB 显存。
- 3.3 内核自动调优(Kernel Auto-tuning):回答"同一个算子用什么实现最快"。三层决策金字塔从架构感知策略生成、算法空间枚举与剪枝、硬件绑定性能建模与实测逐级收敛,最终从 Pareto 前沿选出冠军 kernel。A100 上 ResNet-50 吞吐提升 3.2 倍,背后是数百万次微基准测试的精密测绘。
三者的关系是螺旋上升的闭环:静态图优化提供变换规则与搜索空间,内存优化划定资源边界与可行性约束,内核调优提供真实硬件反馈——共同构成一个自洽的优化飞轮。
可验证事实速查
| 事实 | 数值 | 出处 |
|---|---|---|
| 图优化收益 | ResNet-50 在 V100 上从 12ms 降至 3.8ms | 图优化基准 |
| 融合收益 | ResNet-50 延迟降 37%,Conv-BN-ReLU 贡献 22% | TRT Optimizer Benchmark |
| 显存优化 | 10GB 模型压缩至 3.2GB 显存 | Memory Planner 实测 |
| 调优收益 | A100 上 ResNet-50 吞吐提升 3.2 倍 | Kernel Auto-tuning |
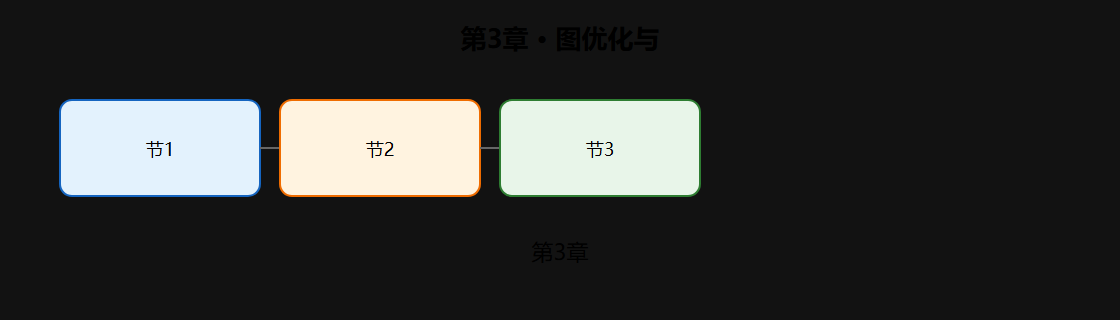
一张图理解优化飞轮
这张图浓缩了本章的架构观:三节不是并列模块,而是形成"理论指导实践、内存约束计算、调优验证理论"的螺旋闭环。读完全章后,你应该能解释任何一个优化动作在飞轮中的位置——它在改变哪条边?它依赖哪个信号?它是否可能触发飞轮另一侧的重新决策?
动手验证:观察优化前后差异
# 用 nsys 统计优化前后的 kernel 数与内存搬运量 # 步骤1:先跑未优化基线(直接用 PyTorch eager 推理) python -c " import torch, torchvision, time m = torchvision.models.resnet50(weights=None).eval().cuda() x = torch.randn(8, 3, 224, 224).cuda() for _ in range(10): m(x) torch.cuda.synchronize() t0 = time.time() for _ in range(100): m(x) torch.cuda.synchronize() print(f'eager 平均延迟: {(time.time()-t0)/100*1000:.2f} ms') " # 步骤2:构建 TensorRT 引擎并对比 trtexec --onnx=resnet50.onnx --fp16 --avgRuns=100 --shapes=input:8x3x224x224
对比两个延迟数值,再叠加 kernel 数量的统计,就能直观看到第2章讲的生命周期与本章讲的优化机制是如何共同起作用的。这个对照实验是理解第3章所有抽象概念的验收基准。
图优化的三大张力
通往极致效率的道路布满荆棘,三组根本性张力持续博弈。语义保真性与计算压缩性的矛盾:融合的本质是计算压缩,压缩必然伴随信息损失风险。把 BatchNorm 与 Conv 融合时,需把 BN 参数吸收进卷积权重与偏置,此变换在 FP32 下精确,但在 INT8 量化中缩放因子的量化误差会被放大,导致融合后精度损失达 0.8%——如何在数学等价性与数值稳定性间取得平衡,已触及混合精度计算理论的前沿。
编译时确定性与运行时动态性的对立:工业场景中模型常需处理动态 shape、条件分支甚至在线学习更新,而传统图优化高度依赖静态分析——它需要在编译时"看穿"整个计算流。当遇到条件分支时,优化器要么保守放弃融合,要么引入运行时分支预测开销。最新的 Dynamic Shape Aware Fusion 通过构建 shape 敏感的子图模板库,在编译时预生成多套融合方案,但代价是模型体积膨胀与缓存污染。
硬件异构性与优化普适性的撕裂:一张为 A100 优化的融合图,在 Orin 上可能因 L2 cache 大小差异而性能倒退;为 INT8 设计的 kernel,在 FP16 Tensor Core 上未必高效。当前策略仍严重依赖目标硬件画像,需人工指定 GPU 型号与内存带宽参数。建立统一、可迁移的硬件抽象层,让优化策略具备跨平台生长性,已成为悬顶之剑。
演进脉络:从手工剪枝到自主进化
图优化的发展轨迹是一部浓缩的 AI 编译史。第一阶段(2016-2018)是规则驱动的手工优化时代,依赖专家经验构建硬编码规则库,高效但脆弱——一旦模型引入新算子组合规则即失效。第二阶段(2019-2021)是 IR 抽象与自动融合的启蒙期,图被抽象为带属性的 DAG,优化器基于属性运用图重写技术,诞生了垂直融合、水平融合与内核缝合等经典策略。第三阶段(2022 至今)进入多目标协同与自主演化的智能纪元,图优化引擎构建多维代价模型,同步评估计算效率、内存效率、能效比与编译开销,并开始与内核自动调优深度耦合——图优化决策不再预设 kernel 形态,而是生成候选融合方案集合交由 Auto-tuner 实测,反馈结果反哺图优化策略迭代,已初具"编译器自我进化"的雏形。
阅读本章时请记住这条脉络:图优化的成熟度,本质是 AI 编译器对硬件物理世界认知深度的函数。从手工规则到 IR 抽象,再到多目标协同,每一次跃迁都是对 GPU 微架构、内存层次、功耗模型理解的深化。
学习路径建议
- 先读 3.1:建立"优化有边界"的认知,理解融合与剪枝的合法性来自静态图的确定性。没有这个前提,后面所有技巧都可能被误用。
- 再读 3.2:理解性能的下限由内存决定。配合"动手验证"中的显存占用对比,体会内存优化的收益常被低估。
- 最后读 3.3:理解最优 kernel 不是写出来的而是搜出来的,同时记住"一次性投资"的工程代价。
- 读完全章:回到第1章的三重摩擦——你会发现图优化主要回应内存墙与调度熵,量化(下一章)则正面回应精度冗余。带着这条线索进入第4章。
子章节
- 3.1 静态计算图优化理论:静态性定义、三条公理、垂直/水平融合、结构性剪枝、三层协同引擎。
- 3.2 内存复用与管理优化:生存期分析、区间图着色、Workspace 显存池、权重重组与对齐、四类亲和性标签。
- 3.3 内核自动调优(Kernel Auto-tuning):三层决策金字塔、GEMM 参数空间、Pareto 前沿选择、一次性投资的工程代价。