6.2 面向AI加速器的实现
6.2 面向 AI 加速器的实现
本节摘要:大模型与 HPC 把冯·诺依曼式“搬运工架构”推到墙边:能量大量花在搬数据而不是乘加。加速器 VLSI 把计算图映射成脉动阵列、近存层次和确定数据流,而不是在通用核上再挂一个 NPU 名称。EDA 侧用学习模型预测拥塞与时序,缩短放置迭代,但签核仍以物理分析为准。本节按能交付的数据流通路写。
学习目标
阅读完本节,你应当能够:
- 用计算访存比解释为何要近存或脉动
- 描述脉动阵列如何让数据在单元间复用
- 把量化、稀疏当成硬件接口而不是只当训练技巧
- 说明布局预测模型的位置:筛选方案,不替代 SPEF
一、墙在搬运,不在乘法
原文写得很硬:典型训练负载里,能量可以大部分花在搬运;一次矩阵乘加里,从片外取数的代价可以远高于片内完成乘加。这不是调参问题,是范式错配。通用核为指令流优化,张量计算要的是数据在空间上的复用。
三条支点:结构化阵列、存储与计算边界变薄、软硬一起定义数据流原语。脉动阵列让权重或激活在相邻 MAC 间流动,减少反复访问同一块 SRAM。TPU 一类设计把 MAC 当第一公民,不是 ALU 的选项。你在 RTL 里仍要写清:阵列尺寸、边界填充、流水深度、累加位宽。这些是规格,不是论文配图。
近存:把 SRAM 宏贴在阵列边上,缩短金属。存内计算把模拟乘加塞进位线,能效诱人,签核变成模拟精度加数字控制,不能当标准宏即插。工程上先把近存做到极致,再评估是否真要进模拟阵列。
量化把张量变成硬件喜欢的定宽。量化感知训练在软件里模拟截断,是为了匹配单元。稀疏要有硬件的跳零或压缩格式,否则稀疏只是内存里的零,MAC 仍在乘零。这些必须在接口表出现:哪一层 INT8,哪一层稀疏索引。没有接口,加速器只是“宣称支持 AI”。
二、实现流水线并不神秘
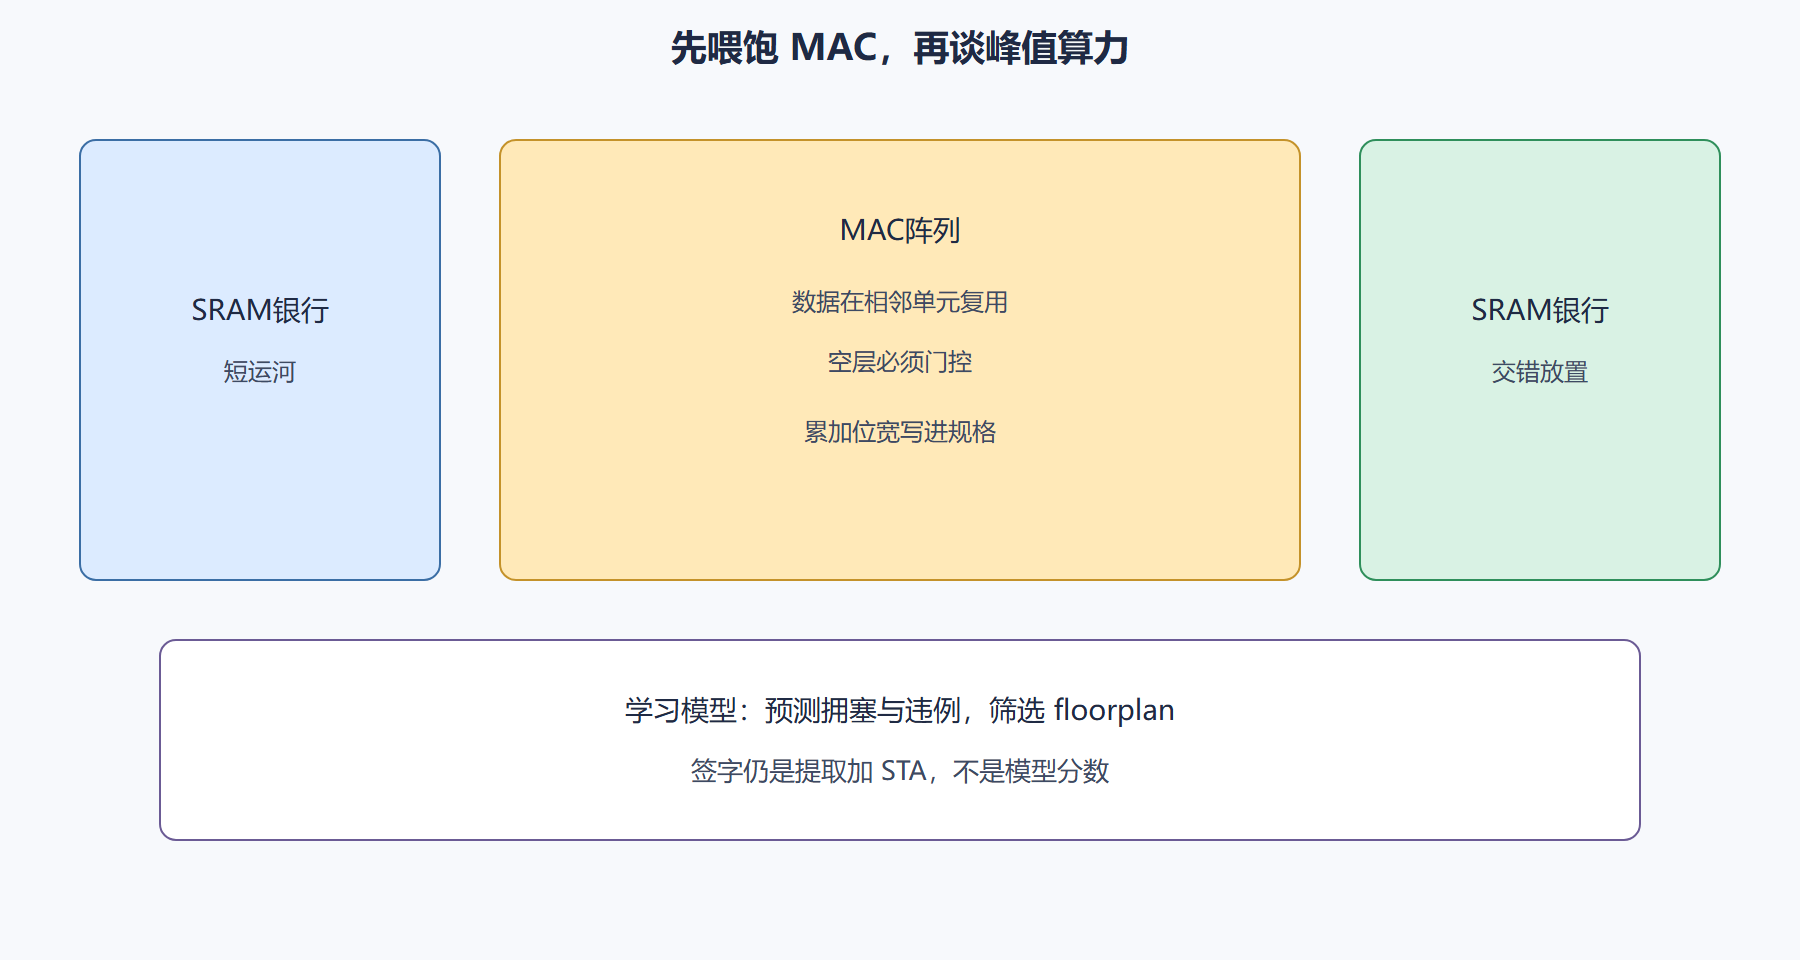
加速器仍走 RTL→综合→P&R→签核。差别是:数据通路极宽,互连和 SRAM 宏主导 floorplan;时钟可能多域(计算核高、控制低);功耗地图呈条带热点。布图失败模式是:把所有 SRAM 堆在一边,阵列在另一边,中间出现第3章警告过的毫米级运河。正确的是阵列与银行交错或环绕,运河短而多。
DFT 上,规则阵列好扫,但自测要覆盖 MAC 饱和与累加器位。BIST 不只给 SRAM,也要给数据通路的确定性图案。低功耗上,阵列空层必须门控,否则空翻的 MAC 会把动态功耗写成“没在算也在烧”。
| 设计选择 | 对物理的影响 | 对软件的影响 |
|---|---|---|
| 更大阵列 | 线更长、时钟更难 | 要更大分块对齐 |
| 更多 SRAM 银行 | 宏挡路、BIST 更多 | 冲突减少 |
| 更窄位宽 | 面积降、精度接口 | 量化策略 |
| 稀疏单元 | 控制复杂、测试难 | 编码格式 |
| 多芯片封装 | 热与 PHY 签核 | 集合通信 |
⚠️ 常见坑:先定峰值算力再倒推存储。算力纸面好看,SRAM 带宽不够时,阵列在等数,能效立刻掉下来。
💡 关键直觉:先报“每秒能喂多少字节进 MAC”,再报峰值乘加。
原文在 EDA 机器学习一节给过工业方向:学习模型进放置,关键路径违例与功耗热点密度可以明显下降;图网络与时序预测缩短 STA 迭代;强化学习引导拥塞。具体百分比随工具版本和设计而变,不要当永恒指标。要固化的用法是:模型提出候选 floorplan 或缓冲方案,物理分析仍用提取与 STA 签字。预测是望远镜,不是法庭。
图:数据流与近存
三、交付物是垂直栈
加速器项目的交货不只是 GDS。驱动、编译器平铺、性能计数器、功耗模式,都要和 RTL 同期。算法组改图形状,硬件的分块假设可能立刻过时。协同应从第1章接口表开始:支持的张量布局、对齐、最大驻留。QEMU 加 RTL 协同仿真一类系统级手段,用来抓“编译器以为能融合、硬件没有这条旁路”。
团队上,物理设计要早进算法讨论,因为金属和宏位置会否决某些漂亮的数据流。这不是让后端改算法,是让不可布线的阵列尺寸在纸上就死掉。
问题:通用 GPU 还要不要自己做加速器?
若你的图形状稳定、能效或成本是产品,专用硅仍有空间。若图每周变、量小,FPGA 或买现成加速卡更理性。第5章的冻结光谱在这里再走一遍。
问题:模型预测时序能替代 MCMM 吗?
不能。预测用于少跑几轮贵的全角分析,或给放置一个更好的初值。最终角集合仍要物理签核。把模型当法庭,会在工艺波动上栽跟头。
四、把编译器与芯片当同一份交货
平铺参数(块高、块宽、驻留银行)必须能从硬件常数生成。硬件改阵列尺寸,软件头同时变。否则外场会出现“驱动以为 16,硅上是 32”的错位。性能计数器:空等周期、银行冲突、门控关闭时间,这些是调数据流的眼睛,要在 RTL 就留,不要流片后靠猜。
训练和推理若共用同一颗硅,运行点表(电压频率、可关断域)要进 UPF 和驱动。推理要省电,训练要吞吐,门控粒度可能不同。规格写两套模式,验证两套向量。只验证训练,推理上场才会发现唤醒太慢。
预测模型进放置时,保存候选分数与最终 SPEF 签字的对照。模型说拥塞低、提取后仍高,要回馈特征是否过时,而不是改 SDC 把路径标假。模型训练数据若来自另一工艺,预测会系统性偏。第6章矩阵也应记录“模型版本”,避免静默升级启发式。
热设计与封装:阵列条带热点要和散热器路径一起看。近存把 SRAM 贴阵列,热也贴在一起。IR 与温度耦合,STA 降额要用同一张热图。加速器项目的签核集合比通用 SoC 更不能省热。
五、空等计数器是架构的示波器
没有空等、冲突、门控关闭这些计数器,软件只能看吞吐量猜。计数器在 RTL 就留,面积几乎可忽略,却决定你能不能证明“墙在搬运”。证明了,才有资格要更多 SRAM 或改平铺。没有证明,加阵列只是让更多 MAC 一起等。
平铺参数从硬件常数生成,编译器与硅同生。改阵列尺寸而不改头文件,外场会用错块大小。模型预测 floorplan 时,对照表要留下:预测拥塞对提取后拥塞。系统性偏差说明特征或工艺变了,该重训或停用,而不是继续信分数。
热图与 IR 共用。条带热点既是时序问题也是封装问题。近存把热也近了,散热器路径要在 floorplan 评审出现,不要等封装厂回头问为什么热点在叠层中间。
六、先证明在等数
空等计数器上不去,就没有资格加阵列。头文件由硬件常数生成。模型分数对照提取结果,偏差大则停用。热与 IR 共用图。训练推理两套运行点都要向量。垂直栈与 GDS 同期,缺驱动不算交货。
先报每秒能喂进 MAC 的字节,再报峰值乘加。空等计数器是示波器。平铺参数生成头文件。阵列与银行交错,禁止隔河对望。空层门控。量化稀疏写进接口。近存先于存内。DFT 覆盖饱和与累加。预测模型对照 SPEF,偏差停用。热图给封装。训练推理两套运行点两套向量。垂直栈与 GDS 同期。物理设计早进算法讨论,否决不可布线的阵列尺寸。通用 GPU 还是专用硅,用第5章冻结光谱再走一遍,不要用口号代替年量与改版。
案例:峰值好看,MAC 在等
阵列加大一倍,峰值乘加翻倍,功耗翻倍,吞吐量几乎不动。空等计数器显示银行冲突和运河等待。宏从对岸改成与阵列交错,喂数上升,空等下降,这时才有资格谈下一档算力。编译器头文件仍按旧尺寸生成,外场错块。常数生成头文件后消失。模型推荐的 floorplan 分数很高,提取后拥塞仍高,特征来自另一工艺,模型停用。训练向量签过核,推理唤醒太慢。两套运行点两套向量。没有示波器就加阵列,只是让更多 MAC 一起排队。
再补一条出门检查:喂数字节先于峰值;空等计数器在 RTL;头文件由常数生成;宏与阵列交错;模型对照 SPEF。五样没有,加速器仍是名称。空层门控。量化稀疏在接口表。近存先于存内。训练推理两套向量。热图给封装。垂直栈同期。不可布线的阵列尺寸在纸上否决。没有示波器不许加 MAC。
问题:什么数没有就不许加阵列?
喂数字节没有不许。空等计数没有不许。银行冲突计数没有不许。头文件生成链没有不许。SPEF 对照没有不许。五不许针对峰值骗局。交错放置没有完成也不许。空层门控没有不许。量化位宽没进接口表不许。训练推理若共用还缺一套向量不许。热图没给封装不许。没有示波器就加 MAC,只是让排队的人更多。纸上否决不可布线尺寸,比流片后发现运河更便宜。
加速器肌肉是先喂数:字节、空等、冲突、生成头文件、提取对照。五数没有不许加阵列。交错未完成不许。空层未门控不许。位宽未进接口不许。缺一套运行点向量不许。热图未给封装不许。峰值好看而 MAC 排队,是把墙刷成奖状。纸上否决不可布线尺寸。示波器是计数器,不是口号。垂直栈与 GDS 同期,缺驱动不算交货。
把五数当作加阵列门票。没有喂数和空等就没有下一档 MAC。交错、门控、接口位宽、两套向量、热图,缺一票就仍在刷奖状。计数器是示波器。驱动与 GDS 同期才叫垂直栈交货。
温故知新
- 墙在搬运:先报喂数带宽,再报峰值 MAC。
- 脉动是复用:数据在单元间走,少反复读同一银行。
- 近存先于存内:标准宏贴阵列,签核路径仍数字。
- 量化稀疏是接口:写进位宽与索引格式。
- floorplan 交错:宏与阵列不要隔着运河对望。
- ML 辅助 EDA:筛选与预测,SPEF 与 STA 签字。
双缓冲能掩盖一次访存延迟,脉动阵列靠的是数据在单元间接力,两者解决的墙不一样。前者买的是银行冲突减少,后者买的是少反复读同一行。规格里要写清用哪一种,以及编译器平铺如何对齐阵列几何。混着写“都做一点”,floorplan 会同时出现大银行墙和长接力线,两税叠加。
附录汇总签核夜会用到的违例分类和术语,便于对照,不再展开新原理。