2.2 高级计量架构(AMI)
2.2 高级计量架构(AMI)
上一节的 PMU 让调度看见了输电网的毫秒级脉搏,但配电网和千家万户仍是一片模糊地带——负荷对传统电网而言只是"一个月结算一次的数字"。本节把感知的镜头从系统级推近到用户级:高级计量架构(AMI)如何在用户侧布下第二张感知网,以及这块数据怎样反过来喂养预测、结算与需求响应。
电表进化:从抄表本到数据节点
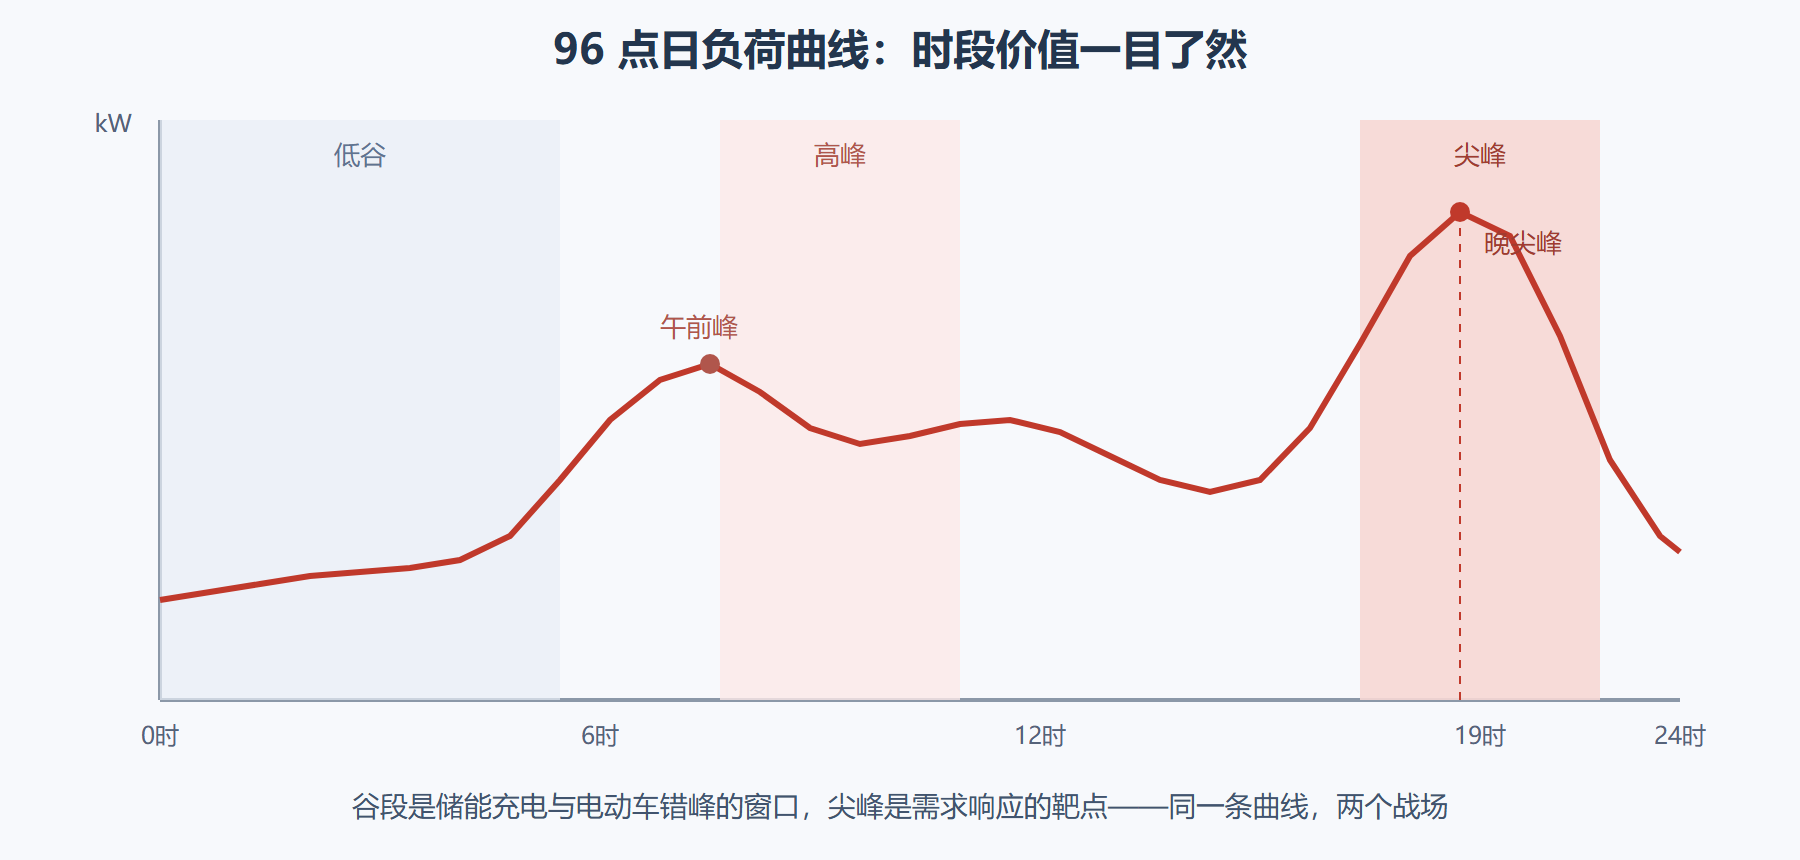
为什么说 AMI 是感知网络而不只是"会远程抄表的电表"?对比一下功能清单就清楚。传统机械表或电子表只回答一个问题:这个月用了多少度。智能电表则每十五分钟甚至每五分钟冻结一次电量,形成 96 点日负荷曲线;能记录电压越限、停电、反向潮流、表盖开启等事件;能接收下行的费率切换和远程通断指令。计量单元只是起点,双向数据流才是本质。
一套完整的 AMI 由四部分咬合而成:智能电表负责计量与事件捕捉;本地网络把电表、水气表、户内网关连成片(低速电力载波或微功率无线为主);广域通信把台区集中器的数据搬运到主站(光纤、无线公网或专网);**计量数据管理系统(MDMS)**负责海量数据的校验、存储、结算适配与对外服务。四者缺一不可——只换电表不建主站,等于装了摄像头却没有存储和回放。
工程上最容易被低估的是 MDMS。一座中等城市的 AMI 每天入库的原始数据动辄以十亿字节计,丢包补采、时钟漂移修正、换表衔接、结算规则映射,都是"脏活",但结算的法律效力恰恰建立在这些脏活之上。
96 点曲线:用户侧的第一份"心电图"
把负荷从月度数字细化到 15 分钟粒度,改变的不只是分辨率,而是问题类型。月度数据只能做账,96 点曲线才能回答:负荷什么时候起、什么时候落、谷在哪里、响应潜力有多少。举三处最直接的变现:
台区线损治理。台区总表电量与户表电量之和的差就是线损,AMI 让它从季度估算变成日清日结,窃电与计量故障从"靠举报"变成"曲线异常自动筛"。
停电管理。配电自动化覆盖不到的末梢,靠电表的停电事件上报(俗称 last gasp)补齐最后一块拼图——数百只电表同时掉线,故障范围立刻浮出水面,抢修派工从电话投诉驱动变成数据驱动。
配网可观测性。低电压治理、三相不平衡分析、变压器重过载预警,全都依赖 96 点曲线。可以说,AMI 是配电网从"黑箱运行"走向可观可测的第一桶数据。
图 2-2 一条 96 点日负荷曲线的形态语言
演练:把 96 点曲线拆进电价时段
分时电价是 AMI 数据的第一类消费者。下面这段代码按"尖、高、平、谷"四个时段统计一台区一天的分时电量与电费结构,这是售电公司与负荷聚合商每天都做的基本功:
# 台区分时电量统计:96 点(15 分钟一档)负荷曲线 load = [42,40,39,38,38,39,41,48,62,78,86,88, # 0-5时, 6-8时 74,66,60,58,57,59,63,72,88,110,132,142, # 8-11时, 11-14时 128,116,108,104,106,112,120,132,150,176,205,228, # 14-17时, 17-19时 236,222,190,158,130,108,88,70,58,50,46,44] # 19-24时 RATE = {"尖": 1.25, "高": 0.95, "平": 0.60, "谷": 0.32} # 元/千瓦时 def period_of(h): if 19 <= h < 21: return "尖" if 8 <= h < 11 or 18 <= h < 19 or 21 <= h < 22: return "高" if 6 <= h < 8 or 11 <= h < 18 or 22 <= h < 23: return "平" return "谷" energy = {"尖":0.0,"高":0.0,"平":0.0,"谷":0.0} for i, p in enumerate(load): energy[period_of(i // 4)] += p * 0.25 # 15 分钟 = 0.25 小时 total = sum(energy.values()) cost = {k: v * RATE[k] for k, v in energy.items()} for k in ["尖","高","平","谷"]: print(f"{k}段 电量 {energy[k]:7.1f} kWh,占比 {energy[k]/total*100:5.1f}%,电费 {cost[k]:8.1f} 元") print(f"合计 {total:.1f} kWh,平均电价 {sum(cost.values())/total:.3f} 元/千瓦时")
运行结果会显示:尖峰两小时的电量占比不到一成,电费占比却接近两成。这个"电量小、价值大"的错位,正是需求响应的经济学起点——第 7 章的一切讨论都建立在这样的曲线之上。
建成一套 AMI 要过的三道坎
第一道坎是采集成功率。行业早期把百分之百采集当作可以一蹴而就的目标,现场很快教会大家谦逊:弱覆盖区域的载波表、封闭管井里的集中器、表计时钟漂移,都会吃掉成功率。成熟的打法是"日采集率考核加异常工单闭环",把通信运维常态化。
第二道坎是数据治理。换表衔接的电量补录、多费率时段切换的边界处理、反向计量的符号约定,每个细节都直接影响结算公信力。数据治理的投入常常超过设备本身。
第三道坎是隐私与安全。15 分钟粒度的用电曲线足以还原家庭作息,数据访问必须有分级授权与脱敏机制;电表作为覆盖面最大的终端,其通信模块的安全设计(第 3 章详述)关系到整个配网的信息边界。
从抄表到互动:数据接口的两重身份
AMI 数据有两重身份,工程上常常顾此失彼。第一重是结算资产:法律效力优先,精度、时戳、防篡改都有硬性要求,任何补抄、估抄都要留痕。第二重是分析原料:负荷预测、台区画像、需求响应基线都吃这份数据,关心的是完整率与时效性。两重身份对应不同的质量指标与责任部门,混在一个管道里往往互相拖累——结算环节为了保证账目稳定倾向"能补就补",分析环节要的是"缺就是缺"的真实标注。成熟的架构会把原始数据与加工数据分层存储:原始层只追加不修改,加工层按用途生成口径,谁要什么取什么。
向前看一步,电表正在从"抄表对象"变成"互动接口"。费率切换、功率控制、继保联动测试,都通过同一套 AMI 通道下发;一些地区已经把台区总表的分钟级数据用于低压潮流计算与三相不平衡治理。当第 7 章的需求响应需要精确计量"响应了多少"时,答案仍然落在这块表上——感知端的建设永远在为下游环节解锁新的可能性。
一块电表的时钟旅行
讲一个反复出现的现场案例来体会数据治理的难度。某小区抄表成功率骤降,排查发现是集中器升级后表计时钟漂移:表以为自己在零点冻结电量,实际冻结在下午六点,结算曲线整体错位六小时。技术上是小问题,牵出的却是三个环节:升级流程必须带时钟同步校验、异常时钟要有自动侦测规则、错位数据要有标注而不是静默混入。一块表的时钟旅行了六小时,账目与曲线就全体失真——AMI 的功夫,七分在这种细节里。
高频问答
问题二:有了 96 点曲线,能知道用户家里开了什么电器吗?
能做到相当程度,这门技术叫非侵入式负荷辨识:从总功率曲线的纹波特征里分解出空调启停、热水器加热等事件。它一面是宝藏——需求响应可以精准锁定可调设备;一面是隐私边界——辨识得越细,数据的脱敏与授权制度就越关键。技术能力与合规设计必须同步演进,这是 AMI 数据应用的一条红线。
本节要点
- AMI 等于"双向计量加双向通信加数据管理"三件事,只换表不算建成。
- 96 点曲线是用户侧感知的基本单元:线损、停电、电压质量、负荷预测、需求响应全部从它起笔。
- 尖峰时段电量占比小而电费占比大,这一错位让负荷第一次成为可经营的资源。