3.1 自适应滤波基础
3.1 自适应滤波基础
本节摘要:自适应滤波解决的问题是:在行情统计特性未知或时变时,让滤波器权值随误差信号自动修正。本节建立误差曲面的几何图像,推导最小均方(LMS)算法的更新律,给出收敛条件与步长折中的量化结论,并用一段可运行代码观察全过程。
第 2 章把路径画像画好了,这一章要造那个"永不闭市的交易员"。造它的第一步不是直接上 ANC,而是先在一个没有声学干扰的干净环境里,把学习机制本身造出来、看清楚——这一节做的就是这件事,它造出的内核叫 LMS。
误差曲面:交易员的盈亏地形
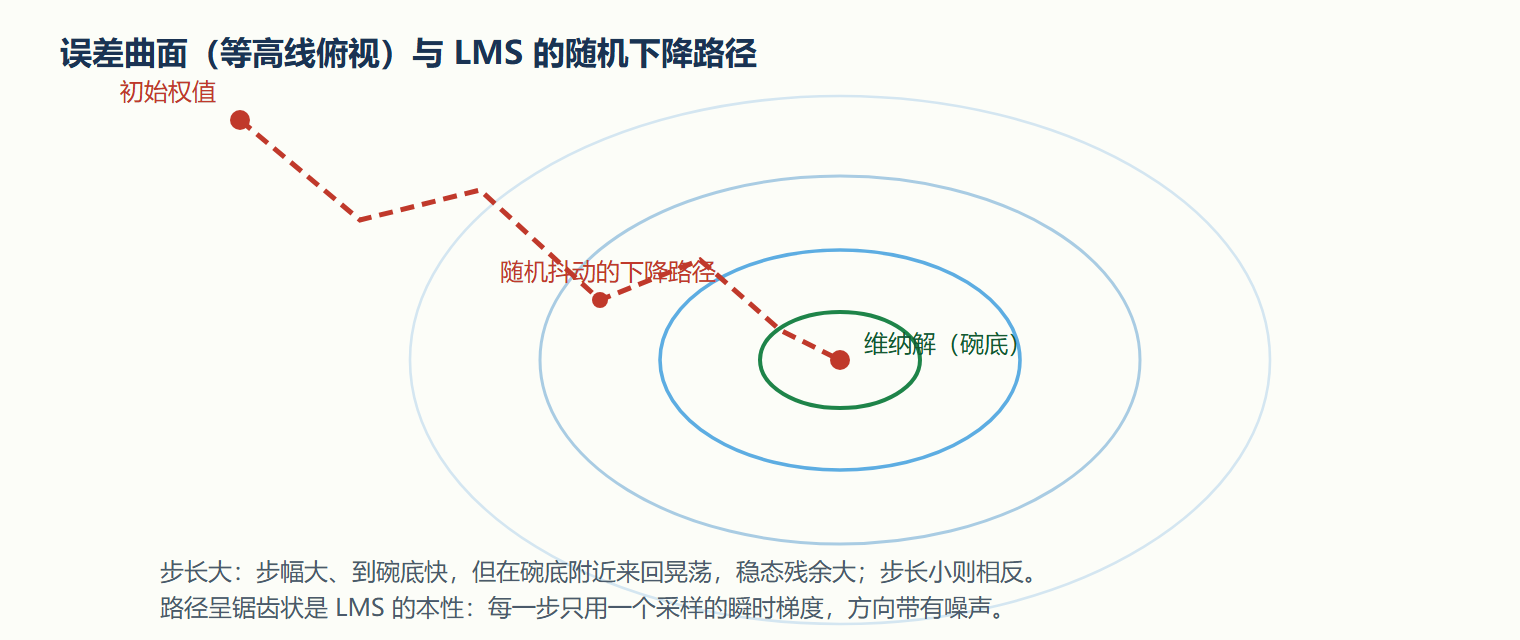
设想一条 FIR 滤波器,权值向量 w 有 L 个系数,任务是从参考信号 x 生成输出 y 去逼近一个期望信号 d,误差 e = d 减 y。对一段给定的参考与期望,均方误差 MSE 是权值的二次函数——在 L 维权值空间里,它是一个开口向上的碗状曲面,俗称误差曲面。曲面的最低点叫维纳解,即统计意义上最优的权值;最低点的深度叫不可消除误差,由噪声本身的相关结构决定,与滤波器无关。
把这个几何图像翻译成交易语言:权值是持仓,MSE 是盈亏,维纳解是最优仓位,误差曲面的坡度是行情对调仓的敏感度。自适应算法的全部工作,就是在不知道曲面精确形状(统计特性未知)的条件下,靠逐采样的盈亏反馈,把持仓一步步挪到碗底。
LMS 的做法朴素到近乎鲁莽:把当前误差乘以当前输入向量再乘一个步长,直接加到权值上。更新律为:新权值 = 旧权值 + 步长乘误差乘输入向量。它用单次采样的瞬时估计代替了统计期望,计算量每采样只有 L 次乘加——便宜到可以每秒跑四万八千次,这正是它能进入实时 ANC 的根本原因。
图:误差曲面上的下降路径
步长折中:收敛速度与稳态残余的对赌
LMS 的所有工程秘密都藏在步长这一个数里。收敛方面,步长必须足够小才能稳定:定量判据是步长小于二除以(输入功率乘滤波器长度),工程上取该上限的十分之一到五分之一起步。速度方面,步长越大收敛越快,这在行情突变(噪声源切换、佩戴姿态改变)后重新锁定的速度上直接可感。残余方面,LMS 在碗底附近不会静止——它用带噪声的瞬时梯度寻路,权值在最优解附近持续小幅游走,游走幅度正比于步长,这叫梯度噪声,表现为稳态残余里多出的一层"算法自噪声"。
三个需求指向三个方向,而步长只有一个。工程的标准解法是分级:收敛阶段用大步长抢速度,锁定后切换小步长保安静;更精致的做法是让步长随误差幅值自动缩放,这就是下一节 3.3 里 NLMS 的动机之一。另一个常被忽视的旋钮是滤波器长度:阶数越高碗越"扁"(各权值方向敏感度差异大),收敛越慢,所以"为精度加阶数"要付出收敛速度的隐性代价——第 2 章说建模预算要花在赚钱的频段,这里补上后半句:阶数预算同理。
动手实验:观察 LMS 的收敛
下面用一段代码在干净环境里复现系统辨识任务:一个未知 FIR 系统当"市场",LMS 滤波器当"交易员",观察权值收敛曲线随步长的变化。改步长再跑,能亲眼看到上面的三条折中。
import numpy as np rng = np.random.default_rng(7) N = 20000 x = rng.standard_normal(N) # 参考信号:白噪声 h_true = np.array([0.8, -0.4, 0.25, 0.1]) # 未知系统的真实脉冲响应 d = np.convolve(x, h_true)[:N] # 期望信号:市场输出 d += 0.01 * rng.standard_normal(N) # 观测噪声 def lms(x, d, L, mu): w = np.zeros(L); e_hist = np.zeros(N) for n in range(N): xn = x[n:n-L if n>=L else None][::-1] if n >= L-1 else x[:n+1][::-1] y = w[:len(xn)] @ xn # 滤波器输出 e = d[n] - y # 误差:盯市盈亏 w[:len(xn)] += 2*mu * e * xn # 更新:再平衡 e_hist[n] = e**2 return w, e_hist for mu in (0.005, 0.05, 0.2): _, eh = lms(x, d, 4, mu) # 输出后段平均平方误差,对比稳态残余 print(mu, round(10*np.log10(np.mean(eh[-2000:])), 1), "dB")
典型结果:步长零点二收敛最快(几千个采样内到底)但稳态残余最高;步长零点零零五稳态最安静但收敛慢一个数量级;零点零五居中。把输入换成强相关的信号(比如低通滤波后的噪声)再跑,会发现允许的步长上限明显变小——输入功率与相关性一起决定了稳定域,这正是车载与耳机场景实测步长差异巨大的根源。
案例展开:主动声学支架上的第一次调试
背景。某团队在实验台上搭建一套最简 ANC 验证装置:信号发生器产生三百赫兹正弦,经功率放大器推动一只扬声器;一只误差麦克风在半米外;控制器用开发板跑 FxLMS(下一节的主角),权值数十六。团队先用本节的纯 LMS 直连(不做滤波参考)试水,作为对照基准。
操作。初始步长按稳定判据上限的五分之一设置。上电后观察误差信号的包络:起初几十毫秒误差不降反升,出现短暂啸叫,团队把步长砍半后重新上电,误差包络开始单调下降,约两秒后进入稳态;再把步长降为十分之一,稳态残余又降了约三分贝,但重新收敛时间拉长到十几秒。
结果。纯 LMS 对照组在精心整定下实现了约十五分贝的单频对冲;代价是步长被压得很低,任何扰动(人手碰一下麦克风支架)后需要数秒重新收敛,期间啸叫风险显著。
解读。这次试水把 LMS 在声学环路里的两个短板暴露得很典型。其一,稳定域窄:扬声器和腔体带来的增益把输入功率放大了,按教科书公式算的上限在实际系统里偏乐观,留足余量是硬要求。其二,没有路径补偿的 LMS 梯度方向是失真的——它的"再平衡"部分是逆着真实坡度走的,表现为收敛慢与扰动后易跑飞。这两个短板正是下一节 FxLMS 要开的药方:把路径模型插进更新通路,让梯度方向重获物理一致性。
变式。若实验台上的噪声不是正弦而是窄带随机(带通噪声),同样装置的收敛会明显变慢——随机行情下瞬时梯度的方向噪声更大,需要更小的步长或更长的滤波器。这个变式预告了 3.3 频域方法的价值:按频段分别控制步长,比全局一个步长精细得多。
⚠️ 常见坑:用仿真调好的步长直接上机。仿真里输入功率、路径增益都是理想值,实机的声学增益往往高出数个分贝,照搬步长轻则残余变大,重则首次上电就啸叫。规程是:实机步长从仿真值的四分之一起步,逐次翻倍试探,找到"收敛快且稳态达标"的平衡点后固定下来,并写入产线标定流程。
本节要点回顾
- 误差曲面:均方误差对权值是碗状二次曲面,碗底是维纳解,碗深是不可消除误差。
- LMS 更新律:权值加步长乘误差乘输入,每采样仅 L 次乘加,便宜是它进实时系统的通行证。
- 步长三折中:稳定上限约二除以输入功率乘长度;大步长快收敛高残余,小步长相反。
- 梯度噪声:稳态残余里多出的一层算法自噪声,与步长成正比。
- 声学环路放大短板:稳定域窄、梯度方向失真,药方在下一节。
内核已经会自己走路,下一节把它接入真实的声学环路,解决"梯度方向失真"这个致命伤。