1.2 同一个格的两副面孔:好基与坏基
1.2 同一个格的两副面孔:好基与坏基
好基短而接近正交,坏基长而几乎平行——二者可以生成同一个格,但基于它们的算法表现天差地别。本节用同一格的两组基做对照实验,把手算 Gram-Schmidt 正交化变成你的常用工具,并给出量化"基质量"的两个指标。
别以为换个基只是换个记号,数学上等价的东西在计算上可以一个在天一个在地。1.1 节证明了基有无穷多组,当时这像个无害的趣味事实;本节要把它变成格密码学的第一根支柱:攻击难易取决于你拿到的是哪副面孔。密钥持有者握好基,攻击者只剩坏基——中间的鸿沟就是安全性本身。
先动手:同一批格点,两组天差地别的基
取 1.1 节末尾预告的格,基为:
再给出同一格的另一组基(你可以先用 1.1 的判据验证:u_1 = b_1 + 3b_2 = (10,10),u_2 = 2b_1 + 7b_2 = (22,23),系数矩阵 \begin{pmatrix}1&2\\3&7\end{pmatrix} 行列式为 7-6=1,是幺模矩阵,合法换基):
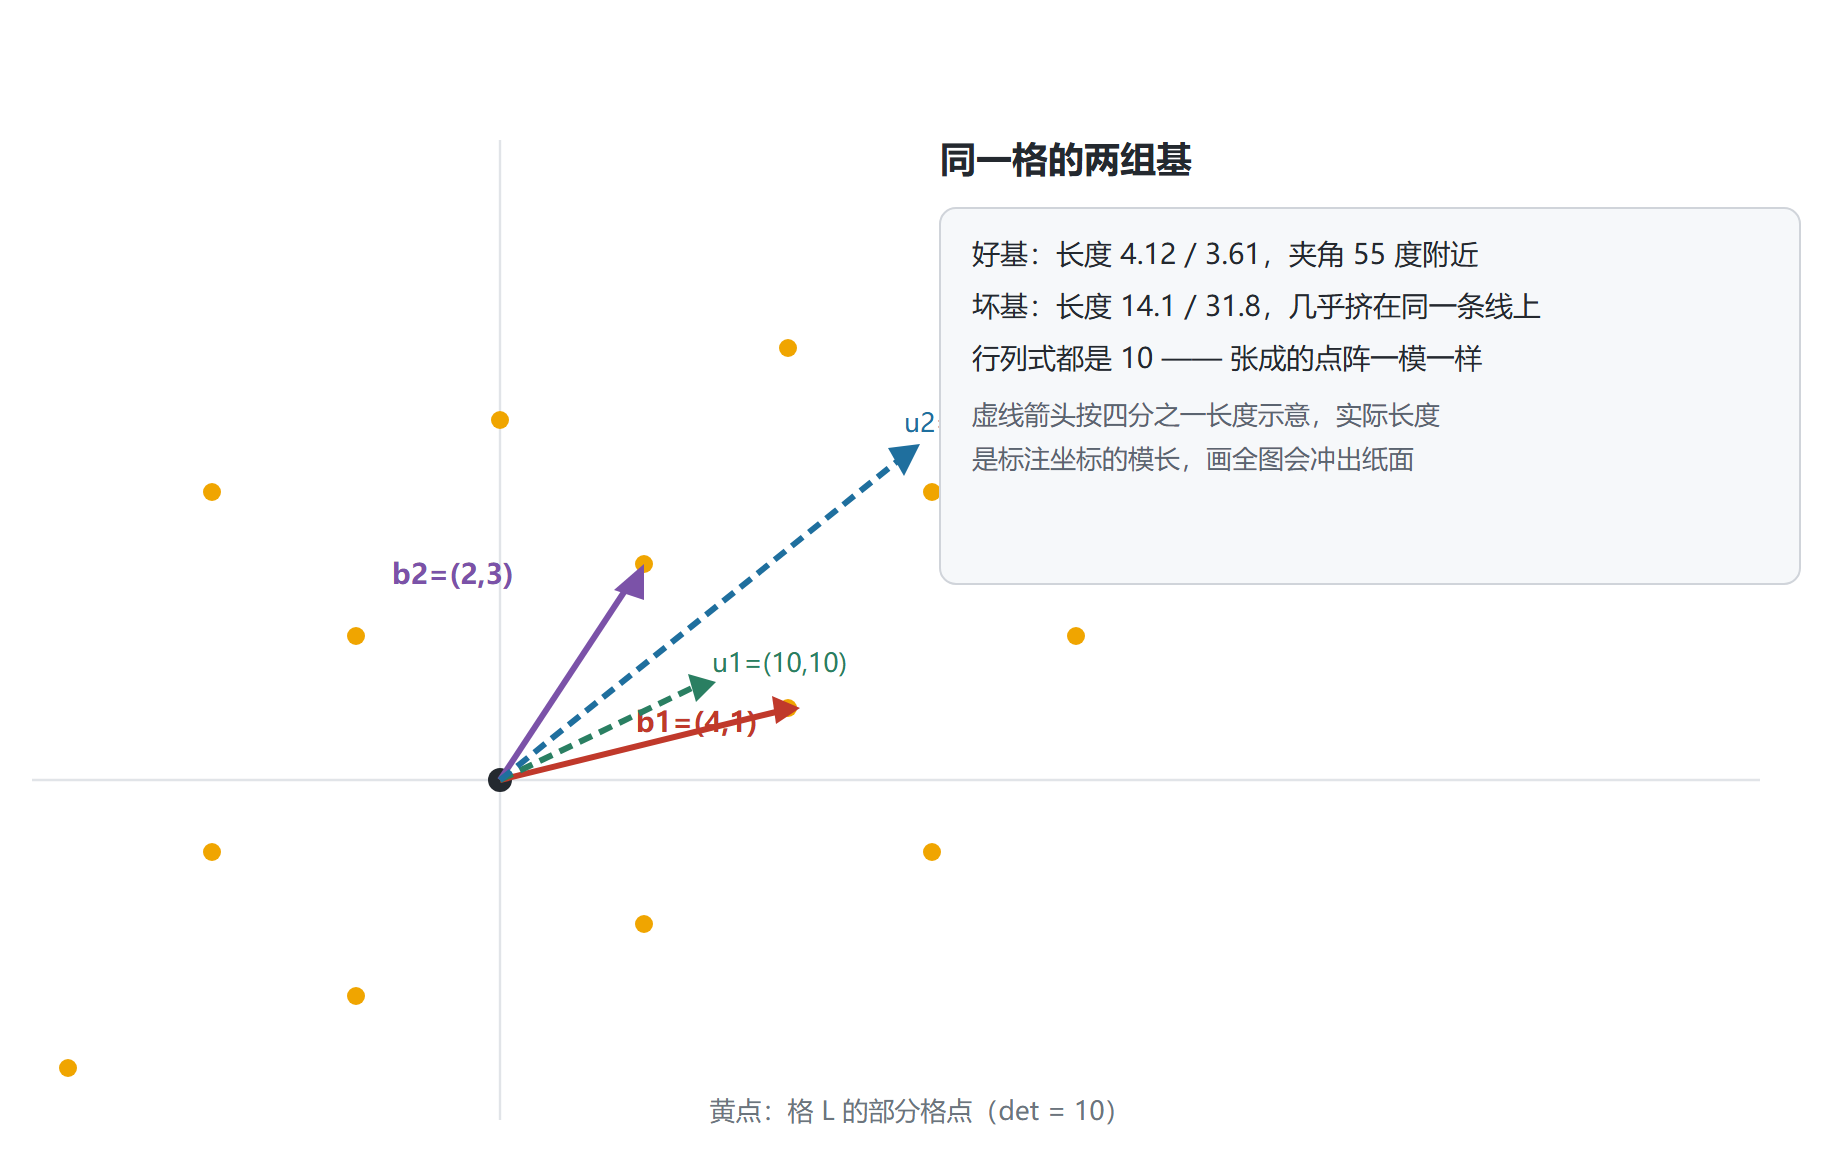
把两代基的向量长度算出来对比。好基:\|b_1\| = \sqrt{17} \approx 4.12,\|b_2\| = \sqrt{13} \approx 3.61。坏基:\|u_1\| = \sqrt{200} \approx 14.1,\|u_2\| = \sqrt{1013} \approx 31.8。同一片点阵,一组基短得离目标近在咫尺,另一组长得离谱——下图把两代基画在同一批格点上(坏基因长度太大,按四分之一比例示意),长短悬殊肉眼立判。
图:同一个格的好基与坏基对照
基质量的量化:Gram-Schmidt 手算
"长且歪"要变成能算的数。Gram-Schmidt 正交化(GSO)做的事:保持张成空间不变,把基向量逐一投影掉彼此的分量,得到一组两两正交的"影子向量" b_1^*, b_2^* 与一串系数 \mu。二维公式:
对好基手算,全部数字都在纸面上走一遍。第一步,内积:\langle b_2, b_1 \rangle = 2 \times 4 + 3 \times 1 = 11,\langle b_1, b_1 \rangle = 16 + 1 = 17,所以 \mu_{2,1} = \frac{11}{17} \approx 0.647。第二步,投影残量:b_2^* = (2,3) - \frac{11}{17}(4,1) = \left(2 - \frac{44}{17},\; 3 - \frac{11}{17}\right) = \left(-\frac{10}{17}, \frac{40}{17}\right)。第三步,量长度:\|b_2^*\|^2 = \frac{100 + 1600}{289} = \frac{1700}{289} \approx 5.88,即 \|b_2^*\| \approx 2.43。
对坏基做同样三步:\mu_{2,1} = \frac{220+230}{200} = 2.25,b_2^* = (22,23) - 2.25(10,10) = (-0.5, 0.5),\|b_2^*\| \approx 0.71。对比正交化向量的长度:好基给出 2.43,坏基只剩 0.71——坏基的两个向量几乎平行,投影掉一个之后另一个几乎什么都没剩下。\mu = 2.25 远大于 \frac{1}{2} 这个现象,说明 u_2 沿 u_1 方向严重超长,也是第 6 章 LLL 里"该约简了"的信号。
由此得到两个常用指标。正交化余量:\min_i \|b_i^*\|,越大越好(好基 2.43 对坏基 0.71)。正交缺陷:\prod_i \|b_i\| / \det,越接近 1 越好:好基 \frac{4.12 \times 3.61}{10} \approx 1.49,坏基 \frac{14.1 \times 31.8}{10} \approx 44.8。这两个数将贯穿全书:第 6 章衡量 LLL/BKZ 的输出质量,第 3 章估算安全强度,用的都是同一套度量。
代码与验证
十行代码把上面的手算自动化,你也可以用它检查任何作业般的换基练习:
import numpy as np def gso(B): B = B.astype(float) n = len(B) Bs = np.zeros_like(B) # 正交化向量 mu = np.zeros((n, n)) # 系数矩阵 for i in range(n): Bs[i] = B[i] for j in range(i): mu[i, j] = B[i] @ Bs[j] / (Bs[j] @ Bs[j]) Bs[i] -= mu[i, j] * Bs[j] return Bs, mu Bg = np.array([[4, 1], [2, 3]]) Bs, mu = gso(Bg) print("mu =", mu[1, 0]) # 0.6470... print("|b2*|^2 =", Bs[1] @ Bs[1]) # 5.8816... print("正交缺陷 =", np.prod([np.linalg.norm(v) for v in Bg]) / abs(np.linalg.det(Bg))) # 1.4865...
输出与手算逐位一致。把输入换成 [[10,10],[22,23]] 再跑一次,你会看到 mu 跳到 2.25、正交缺陷冲上 44.8——两张草稿纸的结论,代码两秒钟复现。
一个预告:坏基上的最近点搜索会翻车
留一道开胃题给第 2 章。在 \mathcal{L} 上解最近向量问题(CVP):给定目标 t = (7,4),找离它最近的格点。先把 t 用好基表出:解方程得系数 \alpha \approx 1.3、\beta \approx 0.9,四舍五入到 (1,1),回代得 1 \cdot b_1 + 1 \cdot b_2 = (6,4),与目标的距离平方恰好是 1——正中靶心。换坏基再来:解出 \alpha = 7.3、\beta = -3,四舍五入到 (7,-3),回代得 7u_1 - 3u_2 = (4,1),距离平方高达 18。同一个点、同一片格点阵,只因为换了基,"最近"的答案从距离 1 恶化到距离 4.24。
这套"解系数再四舍五入"的手法叫 Babai 圆整,是好基上近线性的 CVP 启发式——也是攻击格密码的第一板斧。第 6 章会把它和 LLL 组成完整攻击链;第 2 章则先回答一个更根本的问题:好基为什么这么难找。
要点速记:基不唯一而格唯一,换基走幺模矩阵;好基短且正交、坏基长且近乎平行;GSO 的 \mu 系数与正交化向量长度是基质量的体检报告;算法表现跟着基的质量走,安全性的本质就是"攻击者拿不到好基"。
下一章我们在格上正式立起几道难题:最短向量、最近向量,以及整个后量子密码的心脏——带误差学习。