5.3 BFV、CKKS、TFHE 选型对照
5.3 BFV、CKKS、TFHE 选型对照
全同态加密落地时分成三大家族:BFV 与 BGV 管精确整数、CKKS 管近似实数、TFHE(CGGI) 管逐比特布尔。三族共享第 2 章的格难题与第 5 章的噪声经济学,但在数据模型、自举风格与吞吐形态上分道扬镳。本节给出选型矩阵、参数标准与开销的量级账,读完你能对着业务需求直接落笔。
承接 5.2 节的蓝图:自举与批处理两条路线各自走到极致,就长成了今天的货架。本节是第 5 章的收束,把前面所有原理折算成工程师最关心的一张对照表,并通往第 8 章效率前沿的讨论。
三家族速写
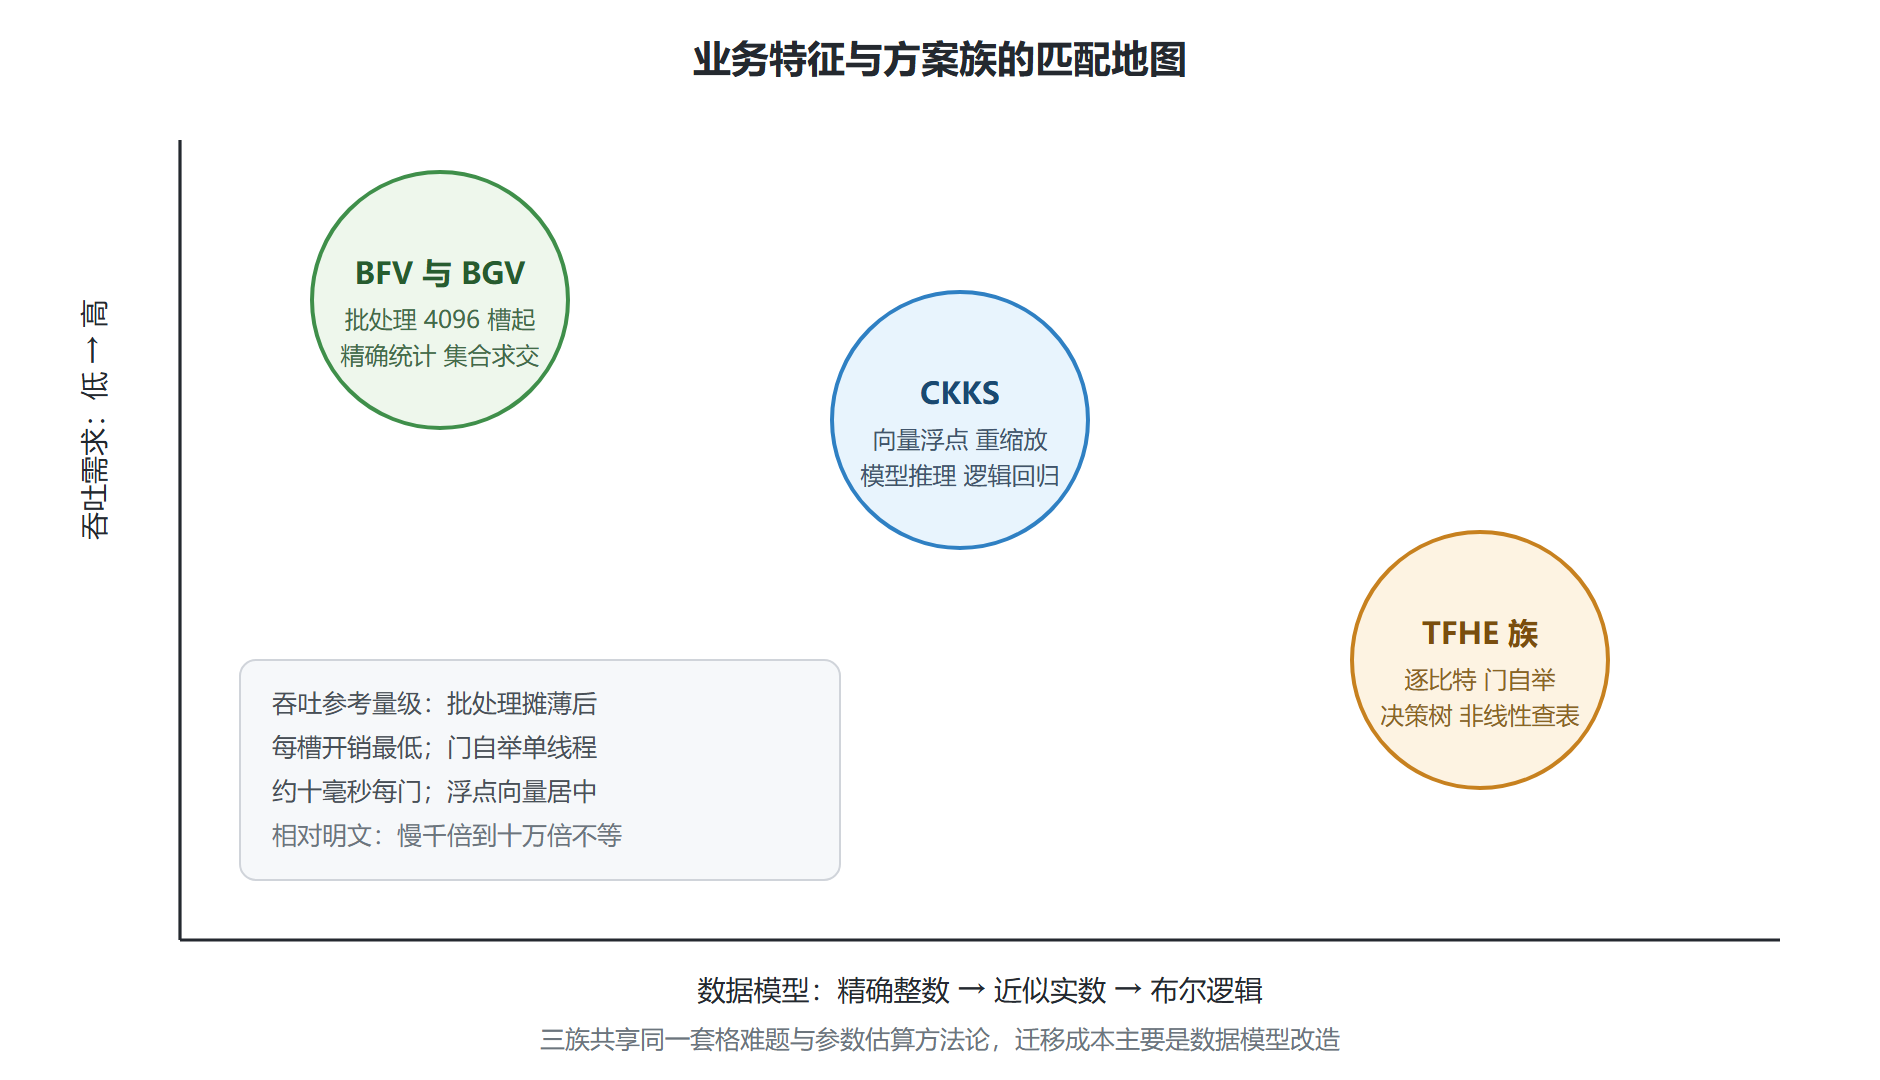
BFV 与 BGV(精确整数族):密文编码整向量,同态加乘结果精确无误。杀手锏是 SIMD 批处理——一个密文装下 N(环维数,常用 4096 到 32768)个槽,一次运算并行处理一整排数据,摊薄后单条数据成本可以压到很低。深度策略通常是"层级式":按电路深度配好参数、中途不自举,既快又稳。典型场景:私密集合求交、精确统计聚合、数据库密态查询。
CKKS(近似实数族):把实数按缩放因子 \Delta 编码成整数(如 \Delta = 1000 时 1.234 编码为 1234),乘法后缩放因子变成 \Delta^2,**重缩放(rescaling)**操作除掉一个 \Delta 让水位复原——这是该族最优雅的设计,代价是结果带近似误差。机器学习推理是其主场:神经网络 tolerate 小误差,换来的是实数运算的顺畅。二十行以内的心智模型:
delta = 1000 x, y = 1.234, 2.718 ex, ey = round(x * delta), round(y * delta) # 编码:实数变整数 prod = ex * ey # 同态乘:缩放因子升为 delta^2 print(prod / delta**2) # 解码 ≈ 3.354,与真值 3.35401 一致 rescaled = round(prod / delta) # 重缩放:除回一个 delta print(rescaled / delta) # ≈ 3.354,水位复原,可继续运算
要记一个安全注脚:近似解密天然"模糊",2020 年有研究指出主动攻击者可借近似性做密钥恢复,各主流库随后加入了噪声淹没式防护——近似族的便利要配这个补丁一起用。
TFHE 与 CGGI(布尔门族):运算单位是比特,每个门运算后跑一次自举把噪声清零(CPU 上单门约 10 毫秒量级),且自举过程可编程——顺路查表实现任意单变量函数,比较、激活函数这类非线性运算一步到位。适合决策树、布尔电路、阈值判断这类"逻辑为主"的业务。吞吐低是明码标价,换来的是任意深度的逻辑与最灵活的非线性支持。
选型矩阵与参数标准
图:三家族能力定位图
参数首层怎么开:业界通行"同态加密安全标准"的口径,按目标安全档与环维数给模数上限。常用的 128 位档:环维 4096 时 \log_2 q 上限 109;环维 8192 时上限 218;环维 16384 时上限 438。动手对一下:这些数恰好是"每维约 0.0267 比特模数"的线性规律——同一条线拉伸到三个档位,背后仍是第 3 章那本攻击账本。选环维的经验法则:深度需求 × 每层噪声增长 决定模数总预算,预算除以 0.0267 得最小环维,然后对照标准表就近取档。
一张表定选型
| 维度 | BFV 与 BGV | CKKS | TFHE 族 |
|---|---|---|---|
| 数据模型 | 精确整数 | 近似实数 | 布尔比特 |
| 深度策略 | 层级预配参数 | 层级加重缩放 | 每门自举 |
| 非线性运算 | 高次逼近,昂贵 | 多项式逼近 | 自举查表,一步到位 |
| 吞吐形态 | 批处理摊薄,吞吐最高 | 向量并行,居中 | 单门约十毫秒 |
| 典型库生态 | SEAL、OpenFHE、HElib | OpenFHE、Lattigo | Concrete 系 |
| 代表场景 | 密态数据库、隐私集合求交 | 密态推理、风控评分 | 决策树、比较逻辑 |
选型三连问收尾:业务要精确还是要近似?要大批量还是要深逻辑?能否接受把数据改造成向量或比特流?三问答完,家族就定了;剩下的参数调优(环维、模数分解、批处理排布)都是在既定家族内部做工程优化——第 8 章会看到这些优化的最新前沿。
一个选型实例走全程
拿一个具体业务演练:云侧给医院做糖尿病风险评分,模型是逻辑回归(约几百个浮点权重),输入是几十维体检指标,要求全程密态。按三连问走:要近似(逻辑回归含 sigmoid,精确整数没法直接算)→ 家族锁定 CKKS;深逻辑吗——激活函数用多项式逼近(五到七次多项式),乘法深度约十几层 → 层级参数即可,不必频繁自举;批处理吗——一次评估一个样本太亏,把几十个样本打包进一个密文的几千个槽并行算 → 吞吐提升两个数量级。参数首层:乘深约 15 层、每层噪声留一倍余量,按"每维 0.0267 比特"的规律反推环维取 16384 档。整条推理链每一步都能在前文找到出处——这就是选型表的实际用法:不是背结论,是走流程。
问题:三家族能混用吗
能,且越来越常见。混合方案(如 CKKS 算浮点主体、TFHE 处理比较与分支)需要"方案间转换"层,学术界已有成熟构造,开源库陆续集成。混用的代价是转换开销与双份参数管理,只有当业务同时含重浮点与重逻辑时才值得上——纯数值管道或纯布尔管道都别为了时髦引入混合。
补一条总账口径:不管选哪族,首轮参数保守化都值得。业务上线的第一个月把安全边际与噪声余量各放大一档(环维升一档或模数预算留两成),拿到真实负载分布后再收窄——同态计算的失败模式(解密错误、超时)在低流量测试里几乎不出现,全靠生产流量的长尾触发。这个"先紧后松"的习惯,比任何调参技巧都更能避免深夜排障。
要点速记:BFV 与 BGV 管精确整数靠批处理,CKKS 管近似实数靠重缩放,TFHE 管布尔逻辑靠门自举;128 位档的模数预算按每维 0.0267 比特线性取档;近似族的模糊性必须配噪声淹没补丁;选型先问数据模型,再问吞吐与逻辑形态。
第 5 章收工。下一章换座位:坐到攻击者的椅子上,把前五章精心构造的东西当靶子逐个敲一遍。