6.1 LLL 手算:二维完整迭代
6.1 LLL 手算:二维完整迭代
LLL(Lenstra–Lenstra–Lovász)规约算法在多项式时间内把任意"歪斜"的基改造成"半好"的基:每个向量都经过尺寸约简、相邻向量夹角不小于 60 度(参数 \delta = 3/4 时)。本节在二维格上把每一轮迭代完整写在纸上——约简、检验、交换、再来,直到算法心满意足地停机。
承接第 1 章:好基短而正交、坏基长而近乎平行,但"从坏到好"的算法至今没露面。本节让主角登场,并通往 6.2 节的威力阶梯——LLL 是梯子的第一级,BKZ 是踩着它往上搭的。
算法只有两个动作
LLL 的二维版本只做两件事,循环往复。动作一,尺寸约简(SizeReduce):若 \mu_{2,1} = \frac{\langle b_2, b_1\rangle}{\|b_1\|^2} 的绝对值超过 \frac{1}{2},把 b_2 减去 \text{round}(\mu_{2,1}) 倍的 b_1,让系数回到 \left[-\frac{1}{2}, \frac{1}{2}\right]。动作二,洛瓦兹检验与交换:比较 b_2 的正交化长度平方 \|b_2^*\|^2 与 \delta \|b_1\|^2(取 \delta = 3/4):若前者更小,说明 b_2 比 b_1 "更正交更短",交换两者顺序;否则基已达标,停机。整个算法是这两动作的 while 循环,且可证明在多项式时间内终止。
完整迭代表:从一个歪基到短向量
实例取第 1、2 章的老朋友:b_1 = (4,1)、b_2 = (2,3)(行列式 10,最短向量 (2,-2) 长度 \sqrt{8})。逐步走,每一步都给你留了复核的算式。
第一轮,尺寸约简:\mu_{2,1} = \frac{2 \times 4 + 3 \times 1}{17} = \frac{11}{17} \approx 0.647,超出 \frac{1}{2},取整为 1,执行 b_2 \leftarrow b_2 - b_1 = (-2, 2)。复核新系数:\mu_{2,1} = \frac{-2 \times 4 + 2 \times 1}{17} = -\frac{6}{17} \approx -0.353,回到区间内。
第一轮,洛瓦兹检验:b_2^* 的长度平方 = \|b_2\|^2 - \mu_{2,1}^2 \|b_1\|^2 = 8 - \frac{36}{289} \times 17 \approx 5.88,而 \delta \|b_1\|^2 = 0.75 \times 17 = 12.75。5.88 < 12.75,交换:b_1 = (-2,2),b_2 = (4,1)。
第二轮,尺寸约简:\mu_{2,1} = \frac{4 \times (-2) + 1 \times 2}{8} = -0.75,取整为 -1,执行 b_2 \leftarrow b_2 + b_1 = (2,3)。复核:\mu_{2,1} = \frac{2 \times (-2) + 3 \times 2}{8} = 0.25,达标。
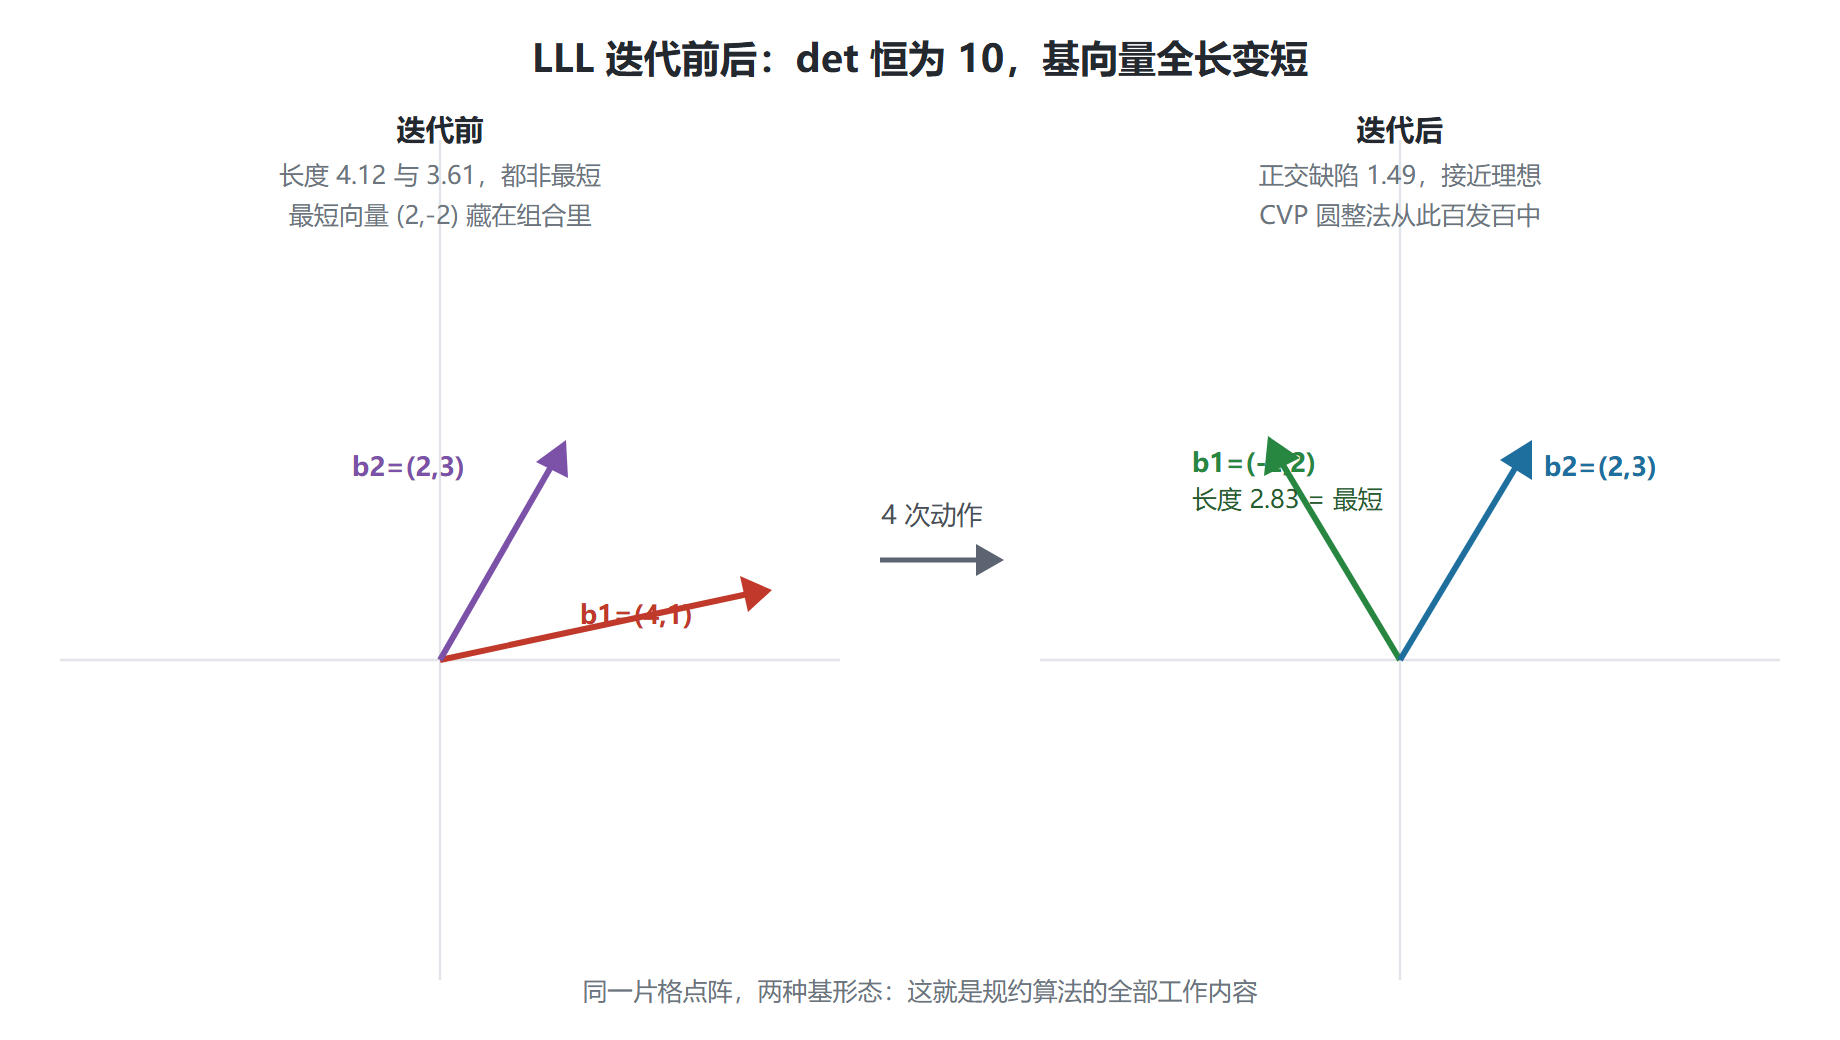
第二轮,洛瓦兹检验:\|b_2^*\|^2 = 13 - 0.25^2 \times 8 = 12.5,而 \delta\|b_1\|^2 = 0.75 \times 8 = 6。12.5 \ge 6,停机。输出基 \{(-2,2), (2,3)\}——第一个向量恰是全格最短向量 \sqrt{8},LLL 在这个实例上打出了满分。整个迭代表汇总:
| 轮次 | 动作 | b_1 | b_2 | \mu_{2,1} | 判定 |
|---|---|---|---|---|---|
| 1 | 约简 | (4,1) | (-2,2) | -0.353 | 系数达标 |
| 1 | 交换 | (-2,2) | (4,1) | — | 5.88 < 12.75 |
| 2 | 约简 | (-2,2) | (2,3) | 0.250 | 系数达标 |
| 2 | 停机 | (-2,2) | (2,3) | — | 12.5 \ge 6 |
前后对照见下图:两条长向量被"熨"成两条短向量,行列式分毫未动(幺模变换的物理意义就在这)。
图:LLL 前后——同一格的基被熨平
质量保证与代码复现
LLL 的理论保证写成一句话:输出基满足 \|b_1\| \le 2^{(n-1)/2}\, \lambda_1——近似因子随维数指数劣化,这是它威力有限的根源(n=100 时因子约 2^{49.5},形同虚设);但二维时因子只有 \sqrt{2},我们的满分输出与理论完全相容。运行时间是多项式的(位复杂度约 O(n^5 \log^2 B) 量级,B 为输入坐标上界),"快而不精"四个字就是 LLL 的身份证。把迭代表交给代码:
import numpy as np def lll2d(B, delta=0.75, log=None): b1, b2 = B[0].astype(float), B[1].astype(float) step = 0 while True: step += 1 mu = (b2 @ b1) / (b1 @ b1) b2 = b2 - round(mu) * b1 # 尺寸约简 mu = (b2 @ b1) / (b1 @ b1) b2s2 = b2 @ b2 - mu * mu * (b1 @ b1) # 正交化长度平方 if log is not None: log.append((step, b1.copy(), b2.copy(), mu, b2s2)) if b2s2 >= delta * (b1 @ b1): return np.array([b1, b2]) b1, b2 = b2, b1 # 交换 B = np.array([[4, 1], [2, 3]]) rows = [] out = lll2d(B, log=rows) for r in rows: print(f"轮 {r[0]}: b1={r[1]} b2={r[2]} mu={r[3]:+.3f} 检验值={r[4]:.2f}") print("输出基:\n", out) # [[-2. 2.] [ 2. 3.]]
把输入换成坏基 [[10,10],[22,23]] 跑变式:输出仍是 \{(-2,2),(2,3)\}——起点无关、终点唯一,这正是"规约"一词的含义。历史上 LLL 一战成名是因为它攻破了背包公钥与 GGH 方案:凡是密钥里藏着"短向量"、实现又把好基泄露在结构里的设计,都倒在了这几十行循环之下;NTRU 早期的小参数变体也吃过它的亏。
要点速记:LLL 只有两个动作,约简管系数、交换管方向;\delta\|b_1\|^2 与 \|b_2^*\|^2 的比较决定走向;近似因子指数劣化决定了它只能当梯子第一级;输入不同终点相同,快而不精是它的宿命。
下一级梯子叫 BKZ:把 LLL 当底层引擎,分块调用更贵的"最短向量预言机",一寸块大小一寸金。