7.1 数值模拟软件
7.1 数值模拟软件
模型写在本子上不会产生任何与实验对账的机会——要跑起来。本节给出现役仿真器的版图、一张按"精度-规模-易用性"选型的决策图,以及两个数值层面最容易翻车的地方(步长与事件顺序)。学完你应能在十分钟内为新任务定下工具,而不是在十款软件之间无休止比较。
概念锚点:仿真器其实是积分器
一切神经元仿真器的内核都是同一件事:对第 2 章的常微分方程组做数值积分。区别只在封装方式与平衡点:
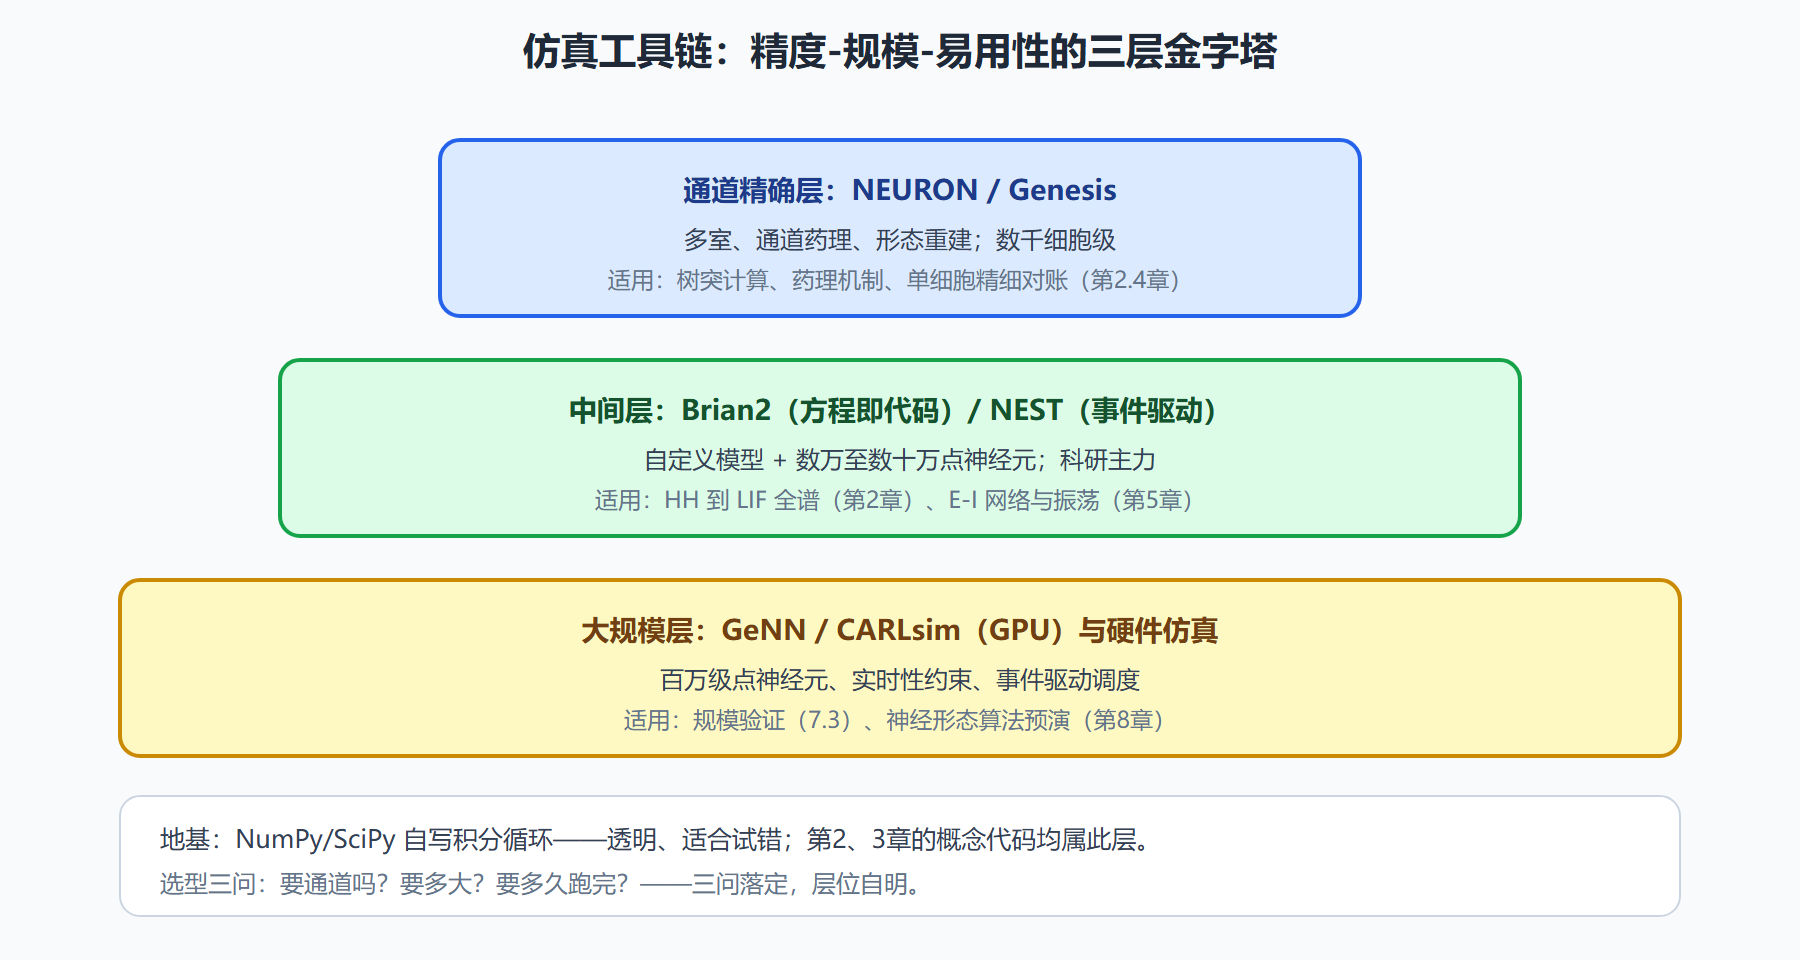
神经元级、通道精确型。以 NEURON 与 Genesis 为代表:为多室模型而生,通道动力学、形态、突触分布都有成熟表达,验证积累最深(几十年论文用同一套机制描述)。代价是学习曲线与规模上限——数万带通道的多室神经元已是桌面机的合理极限。Brian 与 Brian2 走中间路线:Python 原生、方程即代码(模型描述直接写微分方程文本),灵活性与速度兼顾,非常适合第 2、5 章这类"自定义模型"。
群体级、可扩展型。NEST 与 NESTML、以及基于 GPU 的 GeNN、CARLsim:为大规模 LIF/AdEx 网络优化,单机可推数十万到千万量级的点神经元,事件驱动调度(只在有脉冲时计算)是速度的关键。第 5 章的网络现象在这个档位做。
通用科学计算自写型。NumPy/SciPy/JAX 直接写积分循环:第 2、3 章的概念代码就是这么来的。优点是完全透明、没有黑盒;代价是得不到任何优化与验证红利。一个务实的经验法则:模型没定型时用自写循环快速试错,定型后迁移到成熟仿真器换取验证与效率。
图:仿真工具链分层——按问题选层,不按名气选型
选型与两个数值雷区
选型三问:要通道吗(要药理或树突细节 → 通道精确层);要多大(十万细胞以上 → 事件驱动/GPU 层);要多久跑完(要交互调试 → 牺牲规模)。三问之外还有一个常被忽略的维度——验证存量:同一个模型在 NEURON 里跑出来的结果自带几十年的文献可比性,自写循环则要自己建立与文献对账的通道。
雷区一:步长与刚性。HH 方程是刚性的——门控速率在脉冲附近变化极快,欧拉法步长取 0.5 ms 会得到波形畸变甚至假振荡;通道精确模型步长一般取 0.025 至 0.1 ms,或改用指数积分等刚性友好格式。判别方法很朴素:步长减半,结果形状不变才算收敛。雷区二:事件顺序。同一时间步内"先更新膜电位还是先处理脉冲"会改变网络行为(尤其同步性),成熟仿真器对此有严格约定,自写循环最容易在此埋雷——第 5.1 节代码里"用上一时刻群体率"的写法,本质就是在回避这个雷。
概念代码:用 Brian2 把第 5 章网络跑起来
# Brian2 风格的伪代码骨架(方程即代码) # start_scope() # eqs = ''' # dv/dt = (gL*(EL-v) + ge*(EE-v) + gi*(EI-v))/Cm : volt # dge/dt = -ge/taue : siemens # dgi/dt = -gi/taui : siemens # ''' # E = NeuronGroup(3200, eqs, threshold='v>VT', reset='v=Vr') # I = NeuronGroup(800, eqs, threshold='v>VT', reset='v=Vr') # S_EI = Synapses(E, I, on_pre='ge += wE'); S_EI.connect(p=0.05) # S_IE = Synapses(I, E, on_pre='gi += wI'); S_IE.connect(p=0.2) # run(2*second)
骨架里最值得读的是四行结构:两条群体方程、两条连接声明——第 5 章的 E-I 平衡网络在成熟框架里就这么大。wE 与 wI 的比例就是平衡旋钮,跑起来后统计 CV(发放间隔变异系数)即可对账 5.1 节的"低发放高变异"三件套。
⚠️ 常见坑:把仿真器的默认参数当"标准大脑"。各软件的默认单位制(物理单位 vs 无量纲)、默认温度、默认离子浓度都不同,迁移模型时单位换算错误是复现失败的头号原因——先核对单位表再跑。
💡 关键直觉:仿真器不是"更高级的计算器",而是可验证性的载体——选它就是为了接入几十年的对账存量,并把你的模型变成别人可复现的对象。
问题:仿真结果与文献对不上,排查顺序是什么?
固定四步,别乱序。一查单位制(物理单位还是无量纲、电压毫伏还是伏特)——单位错误贡献了大多数"现象消失";二查初值与静息态(模型有没有先跑到稳态再开始实验);三查步长收敛性(步长减半结果不变才可信);四查事件顺序与随机种子(与参考实现对齐调度约定,固定种子做可复现对比)。四步走完仍不一致,才值得怀疑模型本身或文献参数的隐藏假设。
本节要点回顾
- 要点一:仿真器内核是 ODE 积分,分通道精确、中间可扩展、大规模三层。
- 要点二:选型三问——要通道、要多大、要多久;验证存量是隐藏第四维。
- 要点三:HH 型方程是刚性的,步长收敛性检验是必修纪律。
- 要点四:事件顺序约定决定同步性,自写循环最易在此埋雷。
- 要点五:没定型用自写循环试错,定型后迁入成熟框架换验证与效率。
模型侧就绪。下一节走到数据侧:真实的尖峰与成像信号如何被洗成模型能吃的形状。
排错案例:一次"现象消失"的三步定位
把数值雷区走成一个排错案例。新手在一个自写的 HH 网络里发现"加抑制输入后网络毫无反应",按下列三步定位。第一步查单位:发现电流用的是纳安而方程按微安每平方厘米推导,差了百倍量级——统一单位制后"现象回来了"。第二步查步长:恢复的现象在步长 0.5 ms 时出现非物理的振荡尖峰,步长减半至 0.05 ms 后波形稳定且不再随步长变化——刚性方程的收敛判据满足。第三步查事件顺序:把"先更新电位、再更新突触"改成与参考实现一致后,同步现象的相位才与文献对上。三步分别对应单位、积分、调度三个雷区,顺序不能乱——单位错了,后面一切排查都是在错误地基上打转。这个案例的建议值直接抄走:通道精确模型步长 0.025 至 0.1 ms、所有比较实验锁定同一调度顺序、跨软件迁移先核单位表。
问题:要不要一开始就用成熟仿真器?
不必,但要明知代价。自写循环的价值在学习期:每一行都在你眼前,第 2、5 章的概念代码能跑通意味着你掌握了模型本体而非工具用法。切换的信号也明确:当模型定型、需要跑扫描(多参数组)或需要与文献定量对账时,迁移到成熟框架——买的是验证存量、单位安全与调度正确性。常见反模式有两个极端:永远自写(把精力耗在重复造轮子与数值排错上)和从不自写(把仿真器当黑盒,出了非物理结果无从判断)。