7.3 大脑大规模模拟计划
7.3 大脑大规模模拟计划
本章前两节解决了"怎么跑、怎么洗",本节处理规模问题:当目标是整块皮层乃至全脑,单机与单实验室都不够用,于是出现了动员整个领域资源的大科学计划。这条"规模主义"路线的十年沉浮,是计算神经科学最值得复盘的方法论案例——它买到了什么、没买到什么、学费教给了谁。
三份蓝图:三种规模主义
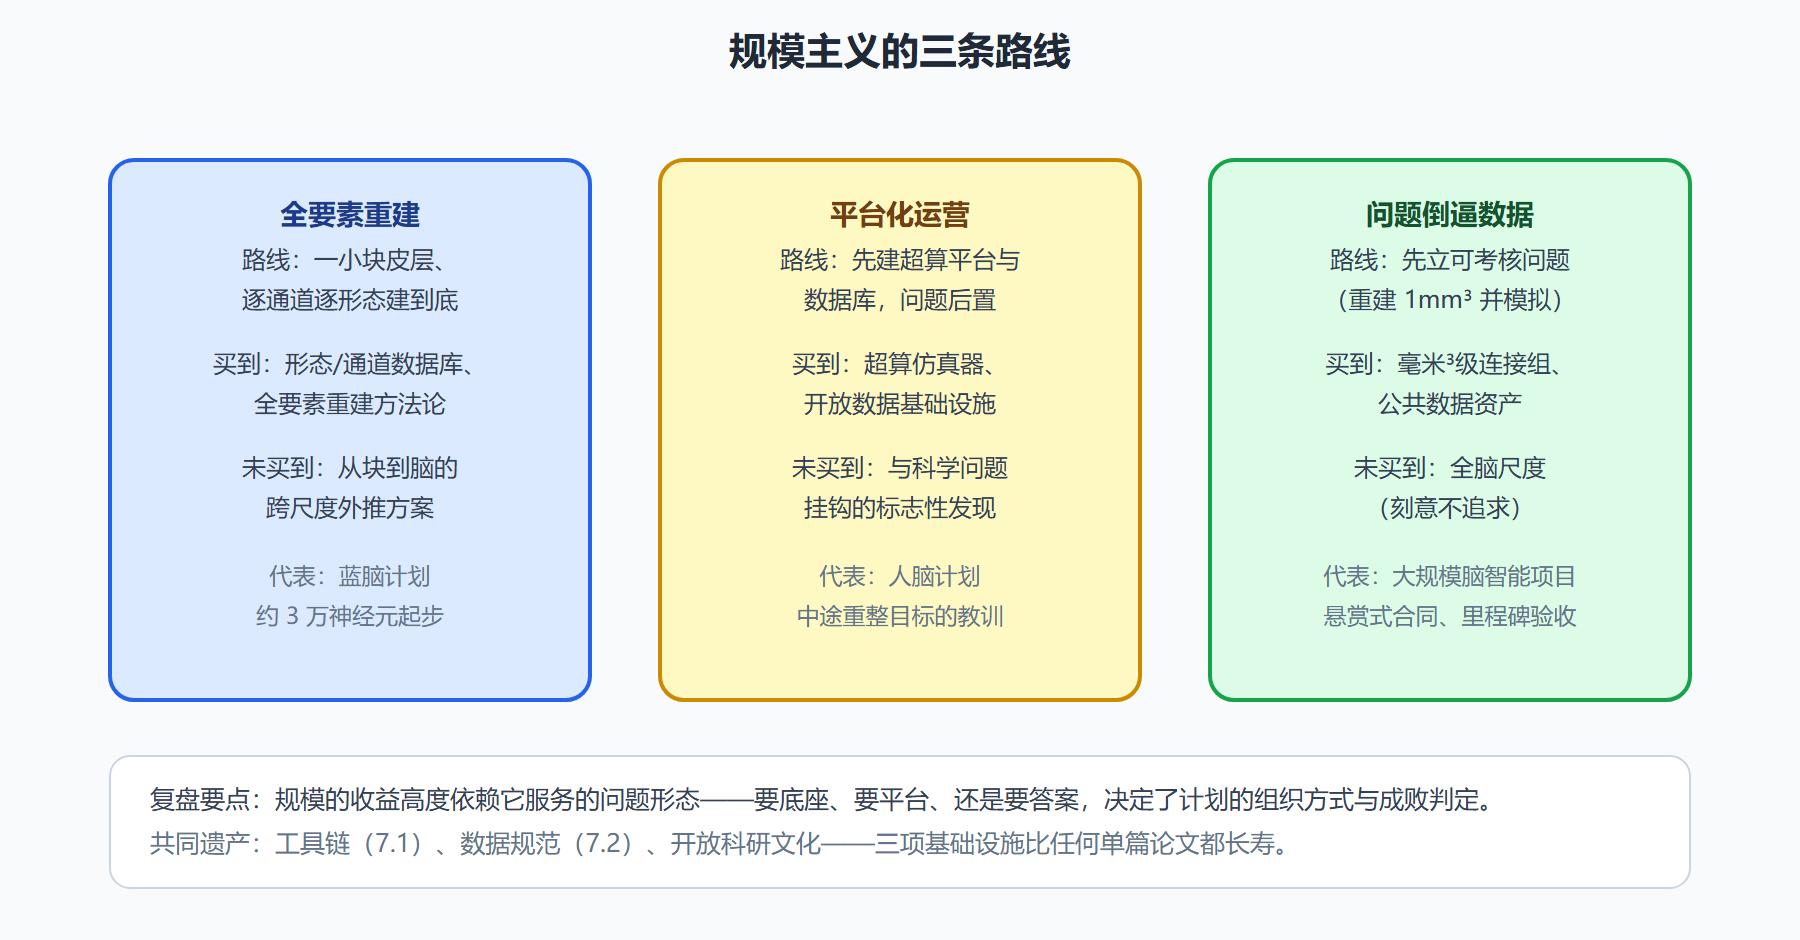
蓝脑计划(Blue Brain,2005 年起):从幼年大鼠的一小块体感皮层(约 3.1 万神经元、3700 万突触)开始,逐个通道、逐个形态重建,用超级计算机把这块组织完整模拟。2021 年前后发布的皮层“双神经胶”模型把数万个形态完整的多室神经元装进了统一框架。它的贡献是工程与数据底座:形态数据库、通道模型库、以及"全要素重建"这个方法论本身。
人脑计划(Human Brain Project,2013-2023):欧洲的旗舰级计划,目标一度包含全人脑模拟,中途经历著名的公开信抗议与目标重整,最终收缩为多支柱平台——仿真(NEST/NEURON 的超算版)、神经信息学数据库、类脑计算与神经机器人。教训深刻:没有足量的底层实验数据,全脑模拟只能建在参数外推上;平台建设优先于科学问题,产出会难以评价。
大规模脑智能项目(Machine Intelligence from Cortical Networks, 2016-):美国 IARPA 的逆向路线——不先建平台,先立可考核的科学问题(从一立方毫米皮层重建并模拟其功能),用悬赏式合同逼出连接组学与功能记录的精度极限。产出的皮层重建数据集(毫米³ 级、纳米分辨率的完整连接组)已成为全领域的公共资产。
三份蓝图的分化本身就是答案:规模不是目的,规模服务的问题不同,计划形态就不同——全要素重建、平台化运营、问题倒逼数据,各养各的鱼。
规模买到了什么
复盘这十余年,规模化确实交付了三样东西。基础设施:形态与连接数据库、超算级仿真器(NEST 已验证千万级点神经元网络的实时可行性)、以及第 7.1 节那套工具链的大规模版本——这些都沉淀为公共设施,后人不必重造。意外的科学产出:全要素重建逼出的统计规律(皮层连接的幂律分布、突触权重对数正态分布)本身成了新的建模约束;大规模仿真暴露了小模型看不见的多稳态。组织范式:预注册、开放数据、跨实验室对账——这些在物理与天文学里成熟的科研文化,经这几场计划进入神经科学。
图:三份大规模蓝图的路线分化
规模买不到什么
学费同样具体。参数空转:没有足量实测约束时,超大规模模型的自由参数靠外推填满——跑得越多,错误参数锁定的伪结论越牢。尺度鸿沟依旧:从突触到行为横跨约十几个数量级的时间尺度,任何单一规模的模拟都无法自动跨层;全要素块模型也没有自动"长大"成认知模型的通道。验证瓶颈:模拟跑出来的现象,实验验证的速度没变——数据产出是瓶颈,不是算力。这些教训反向确认了第 1 章的原则:恰当抽象优先于规模,模型的价值在它回答的问题,不在它消耗的核心数。
当下与未来的务实格局因此清晰:大规模路线转向"数据倒逼"(连接组学与大规模电生理先产出、模拟跟着数据走),中等规模的功能模型(第 5、6 章那类)继续做解释的主力,而"全脑级模拟"降格为长期愿景——它依赖的跨尺度桥接理论(第 8.4 节还会回到这个缺口)尚未存在。
概念代码:估算你自己的模拟预算
# 规模预算的算术:决定"能不能跑"的是乘法不是直觉 neurons, syn_per = 100_000, 1000 # 十万神经元、每个千突触 events_per_s = 2.0 # 平均 2 Hz ops_per_event = 5 # 每事件更新量级 total_syn = neurons * syn_per event_rate = neurons * events_per_s print("突触总数: %.1f 亿" % (total_syn/1e8)) print("事件吞吐: %.0f 万事件/秒" % (event_rate/1e4)) # 单核 Python 约处理 1e6 事件/秒 → 需向量化/GPU/事件驱动框架 # 把 neurons 提到 1e6:单机内存(每突触约 8 字节权重+状态)即成第一瓶颈
把 neurons 换成 100 万、再换成 860 亿(人脑量级):瓶颈从计算量依次移向内存、集群、以及根本不存在的能耗预算(人脑约 20 瓦,百亿突触的 GPU 模拟耗电是它的百万倍级)。这三道瓶颈线就是 7.1 节工具分层的原因,也是第 8 章神经形态硬件登场的动机。
⚠️ 常见坑:把"模拟了多少神经元"当作科学进步的度量。规模是资源消耗单位,不是科学价值单位;评审大规模研究时真正的问题永远是:这次规模让哪个此前无法检验的假设进入了可检验范围。
💡 关键直觉:大规模计划的最大遗产不是"最强大脑",而是基础设施与科研文化——个体研究者现在可以站在这些底座上,把第 2 到第 6 章的任何一个模型跑出对账结果。
问题:大规模计划失败了,这个说法对吗?
不对,但流行。三份计划的原始目标(全脑模拟、统一平台)确实大幅缩水,这是事实;但把"目标缩水"读成"失败"忽略了交付物——工具链、数据库、开放文化都已沉淀为全领域公共设施,7.1 与 7.2 节的日常研究正踩在这些底座上。更准确的复盘是:规模主义证明了"平台先行"的局限,把这门学科逼回了"问题与数据先行"的轨道。这个教训对任何大规模科研工程都成立:基础设施的产出周期远长于科学问题,两者错配时先崩的是科学目标。
问题:个人研究者今天还能从大规模模拟里得到什么?
能得到三样现成的东西。数据:毫米立方级连接组与大规模电生理数据集已公开,个体课题可以直接消费——例如用实测的皮层连接统计(连接概率随距离与皮层深度的衰减曲线、突触权重的对数正态分布)约束自己网络模型的连接结构,比拍脑袋设 p=0.1 有说服力得多;工具:超算级仿真器的单机版或云版本对个人开放,第 7.1 节工具分层在大规模层也有免费入口;范式:预注册与开放对账的流程模板可以直接套用到自己的课题上。规模主义的公共遗产恰好是个人研究者性价比最高的部分——这是那十年学费换来的红利。
本节要点回顾
- 要点一:三条规模主义路线——全要素重建、平台运营、问题倒逼数据——各有得失。
- 要点二:规模买到基础设施与统计规律,买不到跨尺度理论。
- 要点三:参数空转是大规模模型的核心风险,数据约束先行是解法。
- 要点四:三道瓶颈(计算、内存、能耗)决定模拟的规模上限。
- 要点五:规模服务于假设可检验性,不是进步的度量本身。
工具与规模的故事讲完。最后一章回到前沿:这门学科的概念如何流入工程——脉冲神经网络、脑机接口,以及它对自身未来的盘点。