8.1 类脑计算与脉冲神经网络 (SNN)
8.1 类脑计算与脉冲神经网络 (SNN)
全册最直接的工程出口在此:把第 2 章的脉冲神经元和第 3 章的 STDP 学习律搬进算法与芯片。SNN(脉冲神经网络)不是"更真实的人工神经网络",而是一套不同的计算权衡——用事件驱动的稀疏通信换功耗,用时间编码换带宽。本节讲清它跟主流网络的本质差异、训练难题的解法,以及它为什么值得在特定场景下付出兼容代价。
概念锚点:与第二代网络的本质差异
第二代人工神经网络(ANN)的激活值是连续实数,前向计算是密集矩阵乘法。SNN 换掉三样东西:
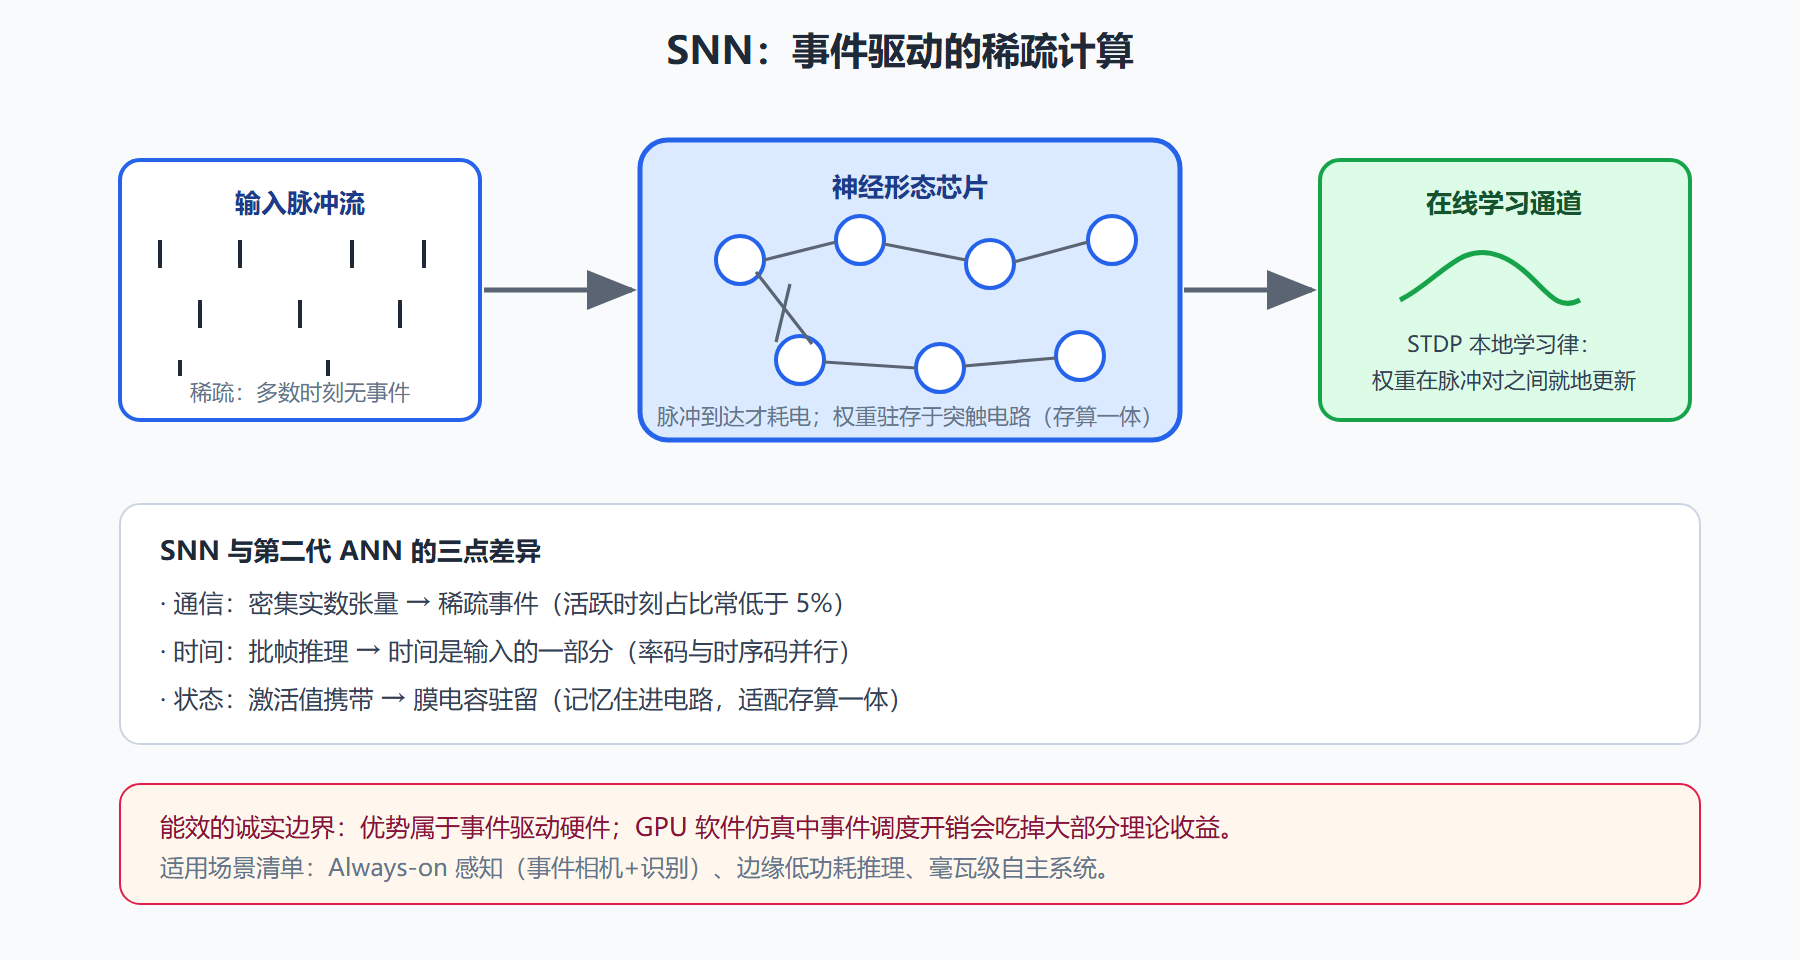
通信是稀疏事件。神经元只在发放瞬间与外界交换信息——多数时间沉默。图像数据里只有 1% 到 5% 的时刻有脉冲在流动,这让计算量与数据量同时骤降。
时间是输入的一部分。ANN 一帧推理一次,SNN 的输入天然是时间流:信息同时写在发放率与时序里(第 4 章的寄存器全开着),静止画面反而要人工"编码"成脉冲流。
状态驻留在神经元里。每个 LIF 单元自带膜电容——记忆不住在激活值里而住在电路状态里,天然适合时序任务,也天然适合忆阻器等存算一体器件(记忆与计算在同一物理位置)。
能效账要算得诚实:SNN 的优势不在通用 GPU 上跑出的软件仿真(事件调度开销会吃掉收益),而在事件驱动硬件上——神经形态芯片的神经元与突触是物理电路,只在脉冲到达时消耗动态功耗,静默时近乎零功耗。典型对账:同样任务下这类芯片功耗可比 GPU 低一个到几个数量级,代价是峰值算力与生态成熟度远逊。
图:SNN 的计算形态——稀疏事件流经存算一体的硬件
训练难题与代理梯度
SNN 落地曾长期卡在同一处:脉冲发放是不可导的阶跃事件,反向传播的梯度传不过去。主流解法是代理梯度(surrogate gradient):前向传播用真实的脉冲阶跃,反向传播时用一条可导的光滑函数(如 sigmoid)代替阶跃的导数——"骗"过链式法则。配合 BPTT(时间反传),SNN 终于能在监督任务上逼近 ANN 精度,代价是时间维反传带来额外显存。另一条路线是 ANN-to-SNN 转换:先把普通网络训练好,再按发放率等价规则转换成 SNN——精度稳、但时延大、且丢掉时序编码优势。两条路线的分工渐趋清晰:追求极致能效用转换法,追求时空任务用代理梯度法。
第三条路线生物上最正统:局部学习律——STDP 及其奖励调制变种,权重更新只用突触两侧的局部信号。它不需要全局反传、天然匹配芯片电路,精度不及监督训练,但在持续学习、故障容错(权重边跑边调)场景有独特价值。第 3.3 节的"三因子"在此再次现身:多巴胺式的全局奖励信号调制局部 STDP,构成"奖励调制 STDP"——强化学习与脉冲硬件的接口。
概念代码:代理梯度的一步
import numpy as np # 代理梯度:前向用阶跃,反向用 sigmoid 导数 def spike_forward(x, thresh=1.0): return (x >= thresh).astype(float) # 前向:硬脉冲 def surrogate_grad(x, thresh=1.0): s = 1.0/(1 + np.exp(-4.0*(x - thresh))) return 4.0*s*(1-s) # 反向:光滑替身 mem, grad_true = 1.2, None spk = spike_forward(mem) # 前向发出脉冲(0 或 1) grad_true = surrogate_grad(mem) # 反向用替身传梯度 print("前向脉冲:", spk, " 反向梯度:", round(grad_true, 3)) # 输出:前向 1(发放了),反向约 0.12(可导)——训练通道就此打通
把 mem 从 1.2 调到 0.3:前向脉冲变 0、反向梯度升到约 0.72——注意这个不对称正是设计意图:未发放的膜电位附近梯度最大,"差一点就发"的神经元获得最多学习信号。
事件相机:SNN 的天然搭档
值得一提的输入端伙伴是事件相机(event camera):像素各自独立地只在亮度变化超过阈值时发出事件,微秒级延迟、无帧率概念、静态背景零输出。它与 SNN 的事件驱动逻辑严丝合缝,组合成"事件进、事件出"的全稀疏视觉系统——高速运动场景(无人机避障、工业检测)里已经落地。这是"输入表示与计算形态匹配"的一堂示范课:帧制相机配 ANN、事件流配 SNN,错配的代价就是无谓的转换开销。
⚠️ 常见坑:宣称"SNN 一定更节能"却拿 GPU 仿真做对账。软件仿真里事件驱动调度本身就是开销,只有事件驱动硬件(含 FPGA 级实现)能兑现能效;对账实验必须写清计算载体。
💡 关键直觉:SNN 的卖点是"匹配"而非"超越"——把脉冲通信、时间编码、局部学习这套生物权衡移植到恰好需要它的工程场景。全册的机制概念到这里变成成本函数里的设计变量。
本节要点回顾
- 要点一:SNN 三差异——稀疏事件、时间即输入、状态驻留电路。
- 要点二:能效收益属于事件驱动硬件,GPU 仿真对账不算数。
- 要点三:代理梯度打通监督训练;转换法求稳、局部学习律求在线。
- 要点四:奖励调制 STDP 是强化学习与脉冲硬件的接口(三因子再现)。
- 要点五:事件相机是天然搭档,输入表示与计算形态必须匹配。
芯片会算脉冲了。下一节把脉冲流接到真实神经系统上:脑机接口的信号链与临床进度。
案例:一颗神经形态芯片的工作日
把 8.1 的概念落成一颗芯片的运行图景。典型神经形态芯片集成数百至上千个"数字神经元核",每个核实例化数百个 LIF 神经元,突触权重存在片上存储里;脉冲以"地址事件"的形式在片上网络里路由——一个脉冲就是一个目的地地址,只有被点名的核才做计算,其余电路静默。部署一个视觉任务:事件相机输出亮度变化事件流,第一层 SNN 把事件转成脉冲,中层提取运动方向,输出层用奖励调制 STDP 在线学"朝哪个方向转弯"。整套系统在瓦级以下功耗上跑出毫秒级反应——同一任务在 GPU 上算力绰绰有余,但功耗高出几个数量级且延迟受帧率拖累。这个工作日图景里的每个环节都对应本册概念:LIF 是 2.3 的硬件版、事件路由是 5.3 事件驱动思想的电路版、在线学习是 3.3 的三因子规则。
问题:SNN 会在通用大模型时代被淘汰吗?
不会,但定位会继续收窄。大模型走的是另一条成本曲线:海量算力、批处理、云部署,强项在知识密集任务。SNN 的主场是"毫瓦级、毫秒级、always-on"的边缘智能——助听器、无人机、可穿戴感知这类对功耗延迟极敏感的场景,与大模型是互补而非替代关系。更值得关注的是反向输出:SNN 研究倒逼出的存算一体电路、事件驱动通信与在线局部学习,正在被通用芯片吸收。判断一个技术路线的价值,看它解决的问题集合,而不是它是否"赢了"。