1.1 什么是RAG:从开卷考试说起
1.1 什么是 RAG:从开卷考试说起
本节摘要:RAG(检索增强生成)是一种先检索、后生成的架构——模型作答前先从外部知识库取回相关资料,再基于资料生成回答,相当于让大模型"开卷考试"。本节给出 RAG 的严格定义与四步工作流程,并沿着从早期检索式生成到智能体化 RAG 的演化时间线,讲清每一代技术解决了什么、又留下了什么。
学习目标
阅读完本节,你应当能够:
- 准确说出 RAG 的定义,以及"检索、增强、生成"三个环节各自的输入输出;
- 画出 RAG 的两阶段工作流程图(离线索引 + 在线查询);
- 按时间顺序复述 RAG 演化的四个阶段及其驱动力;
- 解释"开卷考试"类比为什么成立,以及它在哪一点上失效。
一、从一个尴尬的场景说起
想象一场公司内部的知识问答。有人问:"我们上一季度的退款政策改了哪三条?"大语言模型会流畅地给你一个答案——条款编号、时间、理由,一应俱全。可惜全是编的。模型的训练数据里根本没有你们公司的内部文档,它只是根据"退款政策通常长什么样"续写了一段合理的文字。
这就是幻觉:不是模型在撒谎,而是它只会"接着写",不会"查了再说"。闭卷考试考不出记忆之外的东西,硬考,它就编。
RAG 的思路朴素到近乎直白:既然模型记不住,就让它开卷。作答之前,先去你的知识库里把退款政策的原文找出来,塞进提示词,再让模型基于原文回答。模型的职责从"记忆知识"变成"阅读理解"。阅读理解,恰恰是大模型最擅长的。
这个朴素的思路之所以值得用一整本教程来讲,是因为"找资料"这一步远比想象中难:资料要切块、要向量化、要建索引;查询要编码、要相似度匹配、要排序;找到之后还要过滤、压缩、拼接。每一环都有工程取舍。先别急,本章先把概念和演化史立起来,第 2 章再逐环拆解。
二、RAG 的严格定义与工作流程
RAG,全称 Retrieval-Augmented Generation,检索增强生成。它把系统拆成三个角色:
- 检索器:接收查询,从外部知识库中取回最相关的若干文本片段;
- 增强环节:把检索到的片段与原始查询组合成增强后的上下文(通常就是拼进提示词);
- 生成器:大语言模型基于增强上下文产出最终回答。
一次完整的调用走四步:接收用户查询、执行检索、融合上下文、生成文本。听起来简单,但注意一个容易忽略的细节——这套流程背后有一条"离线生产线"。在线的检索之所以能在几十毫秒内返回结果,是因为事先有人把文档清洗、切块、向量化并建好了索引。理解 RAG,必须同时理解这两条线:
离线阶段的质量决定在线阶段的上限。这句话请记住,后面每一章都在为它做注脚。
与"开卷考试"类比的对齐与失效
类比大部分时候成立:知识库是课本,检索是翻书索引,生成是照着材料作答。失效点在两处。其一,真实考试里你知道书里有没有答案,RAG 系统不知道——检索器永远会返回"最相似"的若干块,哪怕其实没有一块真正相关,模型仍可能硬答。其二,课本可能自相矛盾(两个版本的退款政策都在库里),而考试题不会。这两点失效,正是第 3 章优化技术的出发点。
三、演化时间线:四个阶段,四次补课
只看当下的 RAG 架构,你会以为它生来如此。实际上这套东西被反复推倒重建过好几轮。我们把演化切成四个阶段来看。
图:RAG 技术演化时间线
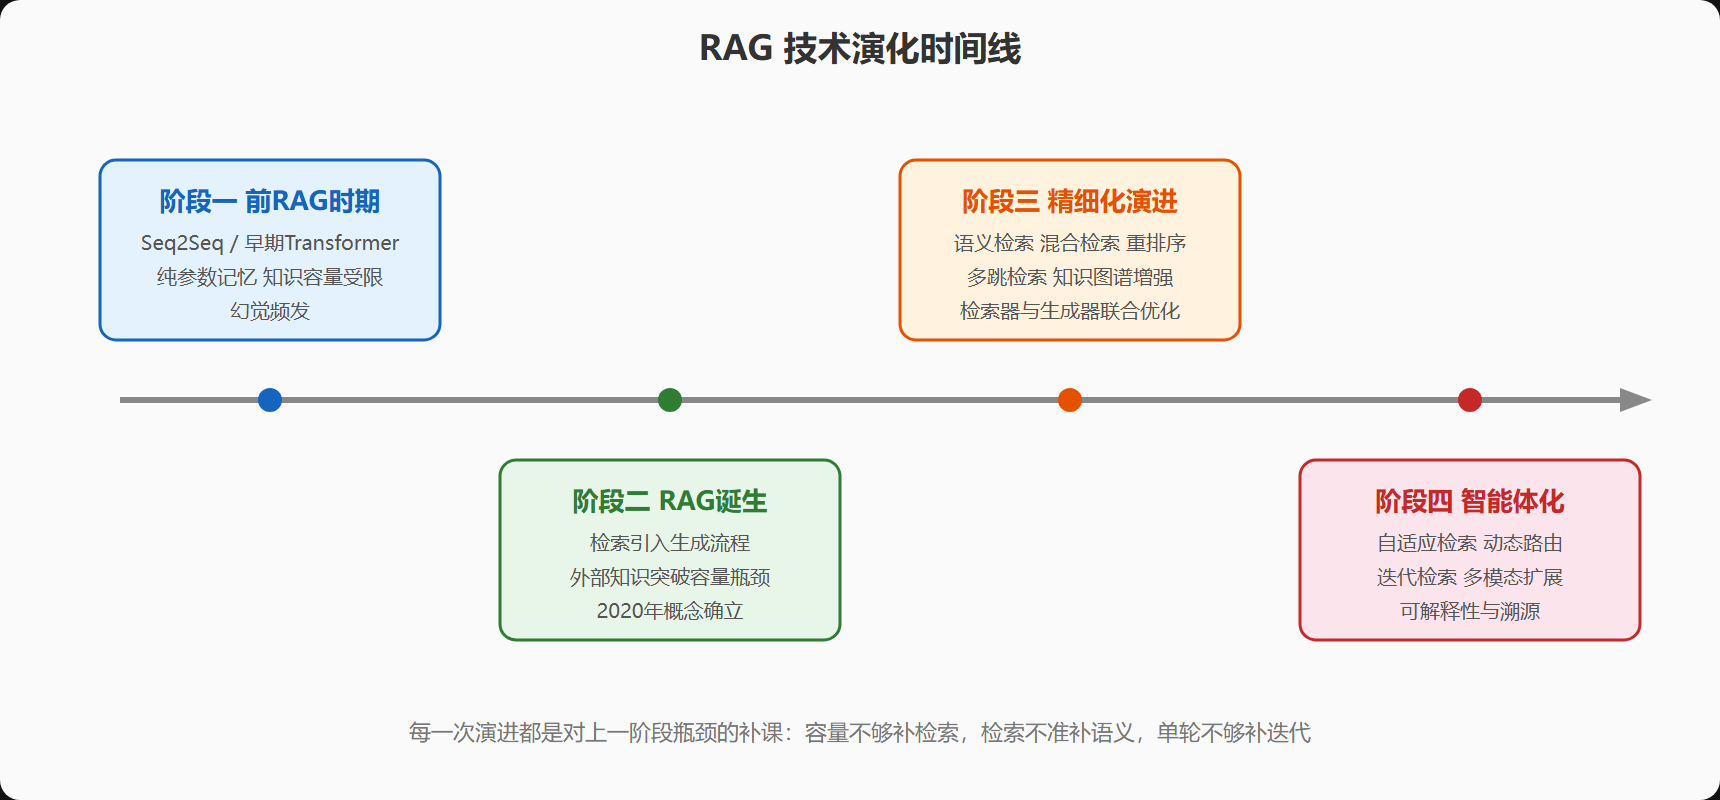
阶段一:前 RAG 时期。 在检索被引入之前,文本生成模型完全依赖参数里记住的知识。基于循环神经网络的序列到序列模型,以及后来的早期 Transformer 模型,在语言流畅度上进步显著,但知识容量被模型规模死死框住。三个硬伤摆在台面上:知识容量有限,训练数据之外的世界一无所知;容易产生幻觉,错了还理直气壮;缺乏可解释性,没法追溯某句话的出处。这个阶段的教训后来成了 RAG 的需求清单。
阶段二:RAG 诞生。 突破来自一个方向调转:把信息检索模块搬进生成过程。检索器负责从外部知识库找文档,生成器负责结合文档与提示产出文本,增强环节把两者缝在一起。外部知识第一次和模型参数解耦——更新知识不用重训模型,换个知识库就行。2020 年,RAG 作为正式概念在自然语言处理研究中确立,"参数化知识 + 非参数化知识"的双通道记忆从此成为标配叙事。
阶段三:精细化演进。 有了骨架,开始长肌肉。这个阶段的主线是检索和生成的双侧精细化:检索侧从关键词匹配走向基于向量相似度的语义检索,嵌入模型从 Word2Vec、GloVe 这类词级表示进化到 Sentence Transformers 这类句子级表示,BERT 的语义编码能力被广泛用于检索;策略上出现了混合检索、查询重写、多跳检索——先检索一轮,拿结果再检索一轮,逐步逼近完整信息;知识图谱开始被用来增强语义理解。生成侧同步进化:更强的生成模型、更精细的融合机制、检索器与生成器的端到端联合训练。细粒度检索(从整篇文档到段落、句子)也发生在这一阶段。
阶段四:智能体化。 当前正在进行的阶段。检索不再是一次性的前置动作,而是被策略化:系统根据查询类型和上下文动态决定要不要检索、检索哪个源、检索几轮。个性化(结合用户历史与偏好)、多模态(图像音频视频一起检索)、更强的可解释性(答案附证据链)是三条并行的推进方向。有人称之为 Agentic RAG——检索从"必经的收费站"变成了"按需调用的工具"。
💡 判断一个 RAG 系统处于哪个演化阶段,看一个细节就够:检索是固定单轮,还是模型可以自主决定"再查一次"。前者是阶段三的产物,后者已踏入阶段四。
四、四代技术横向对比
| 维度 | 阶段一 参数记忆 | 阶段二 朴素RAG | 阶段三 精细RAG | 阶段四 智能体化 |
|---|---|---|---|---|
| 知识来源 | 仅模型参数 | 关键词或初版向量检索 | 语义检索加混合检索加重排序 | 多源动态路由 |
| 更新成本 | 重新训练 | 重建索引 | 重建索引加策略调整 | 增量更新为主 |
| 幻觉控制 | 几乎没有 | 依赖检索命中 | 检索加生成双侧抑制 | 加事实校验环节 |
| 可解释性 | 无 | 可给出引用文档 | 引用加相关性排序 | 证据链加推理路径 |
| 典型延迟 | 低 | 低到中 | 中 | 中到高 |
| 工程复杂度 | 低 | 低 | 中 | 高 |
这张表也解释了为什么"更先进"不等于"该采用"。智能体化 RAG 的能力最强,但延迟和工程复杂度也最高。内部文档问答这类场景,阶段二的朴素架构加上一个好分块策略,往往就能覆盖八成需求。我们倾向于先从朴素架构起步,让真实短板(而不是想象中的短板)驱动升级——这条原则在第 3 章会反复出现。
⚠️ 常见坑:跳过演化逻辑直接堆"高级技术"。多跳检索、知识图谱增强都有明确的适用条件(问题需要跨文档串联、领域实体关系密集),条件不满足时它们只贡献复杂度,不贡献准确率。
五、三个常被问到的疑问
疑问一:RAG 和给模型外接一个搜索引擎,有什么区别?
表面动作相似,设计目标不同。搜索引擎返回的是"网页列表",用户自己去浏览判断;RAG 返回的是"基于资料的直接回答",判断与整合由系统完成。这带来三点实质差异:其一,RAG 需要对知识库做分块、向量化等深加工,搜索引擎只是索引原页;其二,RAG 的输出要控制幻觉(资料里没有就不能说),搜索引擎没有这个约束;其三,RAG 的资料源通常是受控的私有知识库,质量可治理,公开网页的质量不可控。把 RAG 理解为"搜索引擎加大模型读结果"在原型层面成立,在生产层面低估了前者的工程纵深。
疑问二:RAG 会让模型变慢多少?
在线链路多出检索一环,通常增加几十到几百毫秒——相比大模型动辄数秒的生成耗时,占比不大。真正的延迟大头永远在生成侧。但离线链路的成本容易被忽视:初次建库要对全部文档做清洗、分块、向量化,百万字级的知识库首次入库以分钟到小时计,这是一次性的固定投入,之后增量更新很轻。
疑问三:没有知识库、只有一段对话历史,能用 RAG 吗?
可以,而且这是常见变体:把对话历史本身切块入库,检索"之前聊过的相关内容"拼进提示词,等于给模型一个可检索的记事本。对话式助手的长期记忆模块,很多就是这个思路的产品化。它再次印证了 RAG 的本质——不是"连数据库",而是"任何需要按需取用的文本集合,都可以走检索增强"。
本节要点回顾
- 定义:RAG 把系统拆为检索器、增强环节、生成器三部分,本质是让模型从"闭卷默写"变为"开卷阅读理解"。
- 两阶段视角:离线索引(清洗、分块、向量化、建库)决定在线查询(编码、检索、拼接、生成)的效果上限。
- 类比边界:"开卷考试"类比在"库里未必有答案"和"资料可能互相矛盾"两点上失效,这正是后续优化技术的靶子。
- 四阶段演化:参数记忆、RAG 诞生、精细化演进、智能体化;每一代都在补上一代的短板。
- 选型直觉:能力与复杂度同涨,从朴素架构起步、按真实瓶颈升级,是成本收益最好的路径。
读到这里,不妨做一个十分钟的动手验证:找三段你熟悉领域的文字和一段你完全陌生的文字,分别向任意一个带检索的问答产品提问,观察答案质量的差异——熟悉领域你能判断对错,陌生领域只能感受流畅。这个小小的对照实验会让你直观体会"知识库质量决定答案质量"这句话的分量,也会让你在后续章节读到检索与生成优化时,脑中有具体的画面可以对照。
下一节我们把镜头对准价值本身:RAG 到底在哪些维度上改善系统,这些改善各自的前提是什么。详见第 2 节。