2.1 知识库构建与管理
2.1 知识库构建与管理
本节摘要:知识库是 RAG 的地基,其构建覆盖从原始数据到可检索单元的完整工序——数据获取、清洗预处理、知识表示与存储、维护更新。本节逐道工序讲清做法与取舍,重点剖析分块策略这个"质量杠杆",并对比向量数据库、搜索引擎、图数据库等存储方案的选择逻辑。读完你应当能为自己的业务设计一条可持续运营的知识库生产线。
学习目标
阅读完本节,你应当能够:
- 列出知识库构建的六道工序,并说明每道工序的输入输出;
- 为结构化程度不同的文档选择分块策略与初始参数;
- 在四类存储方案(向量库、关系库、搜索引擎、图数据库)中做出选型;
- 设计增量更新、版本控制等知识库运维机制。
一、被低估的脏活
先看一组数字带来的直觉。假设知识库里混进了百分之五的重复文档、百分之一的过时政策文件,听起来不多?在每次检索取回五个文本块的场景下,垃圾块挤掉好块、模型引用废弃条款的概率会随查询量迅速放大——用户看到的错误率远高于百分之五。
知识库构建是 RAG 项目里最不起眼的脏活,也是回报最确定的投入。它的完整生命周期是六道工序:数据获取、清洗与预处理、知识表示、存储、维护、更新。我们按顺序过一遍,重点在第三、四道。
二、六道工序详解
工序一:数据获取
数据来源分三类:文本数据(网页、文档、书籍、新闻、博客),结构化数据(数据库表、知识图谱),多媒体数据(图像、音频、视频,通常先转成文本描述或特征向量)。获取手段相应地有网页抓取、接口调用、数据库直连、文件导入四种。
这一步的要点是"来源登记":每份数据记录出处、抓取时间、可信级别。后面做时效过滤、来源加权、版权审计时,这些元数据都是硬通货。很多团队跳过登记,半年后知识库被过时文件污染,却已无从分辨哪块数据来自哪里。
工序二:清洗与预处理
原始数据充满噪声,标准动作有五个:去除噪声(HTML 标签、特殊字符、广告、页眉页脚);文本规范化(统一大小写、标点、繁简体);数据去重(文档级和句子级都做);分句分段(为后续切块做准备);按需移除停用词(注意:向量化场景通常不需要移除停用词,这一步主要服务关键词索引)。
清洗没有炫技的空间,只有纪律。值得强调的是去重的优先级——重复文本不仅浪费存储,更会在检索时"霸榜",同一个内容的五个副本占掉五个返回位,挤掉真正多元的相关信息。
工序三:知识表示(含分块)
这是整条生产线的质量杠杆。表示方法包括文本嵌入、关键词提取、实体识别、知识图谱四种;其中文本嵌入是语义检索的基础,从早期的词袋模型、TF-IDF,到 Word2Vec、GloVe、FastText 词嵌入,再到当前主流的句子级嵌入模型,表示能力一路增强。
分块值得单独放大。切分策略有三档:
| 策略 | 做法 | 适用 | 风险 |
|---|---|---|---|
| 固定大小分割 | 按固定字符数或词数切 | 格式统一的流水文本 | 语义被腰斩 |
| 基于语义的分割 | 按句子、段落、章节边界切 | 结构清晰的文档 | 块大小不均 |
| 递归分割 | 先按大边界切,超长再按小边界切 | 混合长文档 | 参数需调 |
两个关键参数:块大小决定"信息完整度与相似度分辨率"的平衡——块太小,检索单独命中却信息残缺;块太大,一段里混多个主题,相似度被稀释,还挤占提示词空间。重叠量(相邻块的重叠部分)用来保住跨边界的信息,常见取块大小的百分之十到二十。通行的起步配置是块长五百到一千字符、重叠五十到两百,然后用自己的数据实测调整。代码类文档要按函数与类的语法边界切,表格要整表保留——这些领域例外比通用参数更值得记住。
图:知识库构建工序流水线
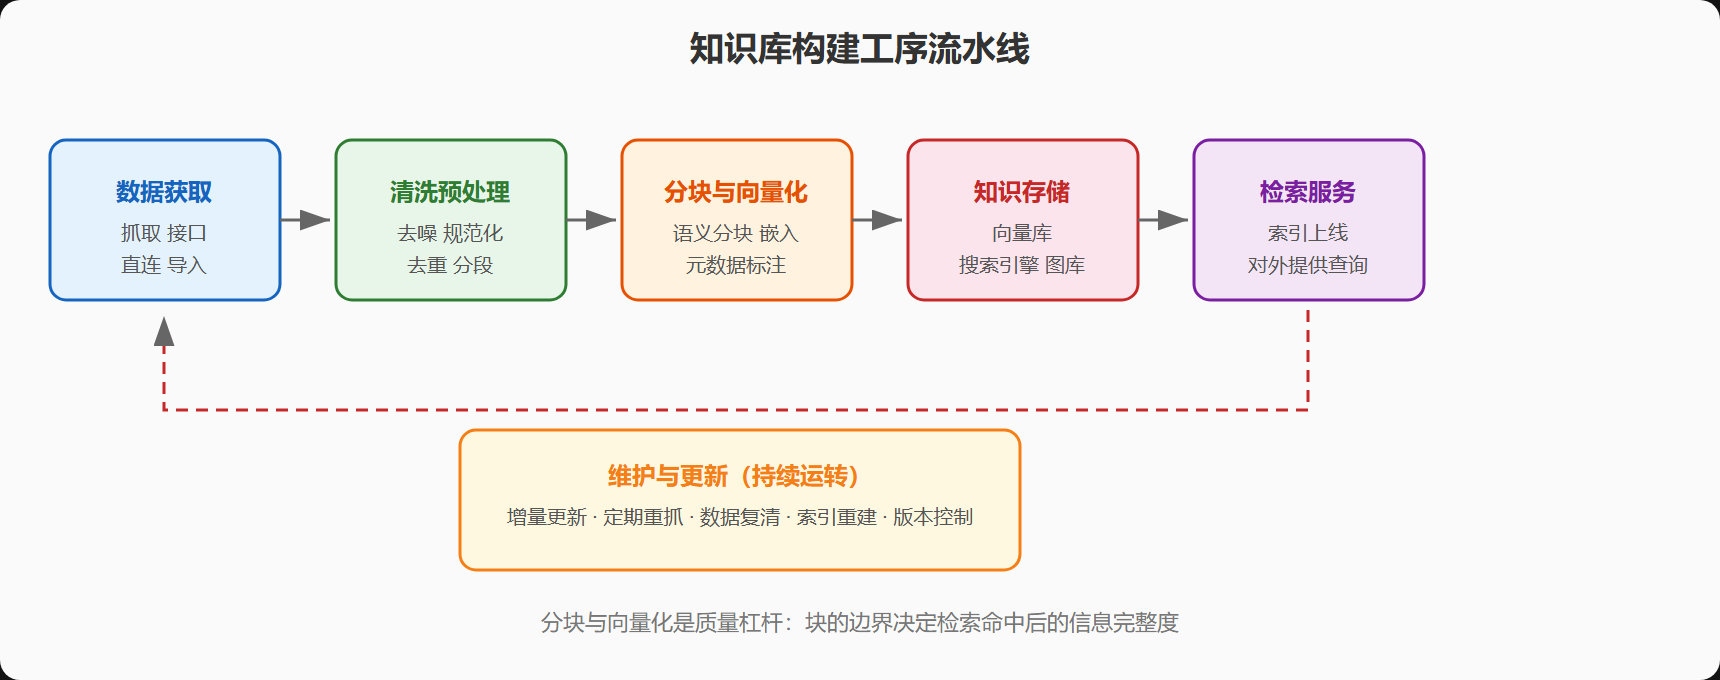
工序四:知识存储
四类候选,按检索需求选:
| 存储方案 | 代表 | 擅长 | 局限 |
|---|---|---|---|
| 向量数据库 | FAISS、Milvus、Chroma、Pinecone、Annoy | 语义相似度检索 | 精确匹配与复杂过滤弱 |
| 搜索引擎 | Elasticsearch、Solr | 关键词全文检索 | 语义理解有限 |
| 关系数据库 | MySQL、PostgreSQL | 结构化字段、元数据管理 | 本身不做语义检索 |
| 图数据库 | Neo4j | 实体关系遍历、多跳推理 | 构建成本高 |
多数系统的实际形态是"向量库为主、元数据放关系库",规模上来后再混合搜索引擎做关键词补充。选型时容易陷入产品对比的泥潭,我们的意见是:数据在千万块以下时,主流向量库的差异不构成瓶颈,把精力留给分块策略。
工序五与六:维护与更新
知识库不是建成即完工的项目,而是持续运转的设施。五个动作:增量更新(新数据随时入库)、定期重抓(对时效性来源周期性刷新)、定期复清(移除过时与错误内容)、索引重建(内容大变后重建以保证检索效率)、版本控制(可回溯到任意历史状态,出问题能回滚)。
⚠️ 常见坑:只增不删。知识库像冰箱,只往里放不清理,最后拿到的一定是过期食材。制度上给每类数据定"保鲜期"(比如产品文档跟随版本失效,新闻类六个月降权),到期自动下线或降权。
💡 元数据是最便宜的精度杠杆:来源、时间、部门、文档类型这些字段,在检索时用于过滤与加权,成本远低于换更强的嵌入模型,收益常常立竿见影。
三、一条数据流走完全程
把六道工序串成一次具体的数据旅行:一份产品手册 PDF 被抓取(工序一),剥掉页眉页脚与重复段落(工序二),按章节递归分块、每块打上"产品线、版本号、发布日期"元数据,再用句子嵌入模型转成向量(工序三),向量与元数据分别写入向量库和关系库(工序四)。三个月后产品改版,新手册入库、旧版本块打上"已过时"标记(工序五、六)。用户检索时,过时块被过滤——一次下游无感的知识换代就此完成。
这个例子里真正决定回答质量的是什么?不是嵌入模型的版本号,而是"版本号元数据被认真登记"这件小事。知识库工程的回报,就藏在这类朴素动作里。
四、三个深水区问题
基础工序之外,有三个问题在项目推进到一定规模后必然浮出水面,提前想清楚能少走弯路。
深水区一:分块参数到底怎么定? 给一个可操作的调参流程。第一步,取二十个典型查询,人工找出每个查询对应的知识块。第二步,用候选参数(比如块长四百、八百、一千二各一轮)建三个库,分别统计"正确块被检索进前五"的比例。第三步,选比例最高的参数,再微调重叠量(零、一成、两成三轮)。整个过程半天能做完,比任何经验法则都可靠。常见的结论规律是:说明书类文档偏爱小块(主题集中),叙述类文档偏爱大块(上下文连贯),混合语料用递归分割加中等块长。
深水区二:多格式文档怎么处理? 现实知识库很少只有纯文本。PDF 里的表格转文本会丢结构(列对齐消失),扫描件需要先做文字识别且识别错误会污染知识库,网页要剥导航与广告,办公文档里的批注与修订记录要决定去留。务实的原则:表格数据与其硬塞进文本管线,不如单独走结构化处理(转成 Markdown 表格或干脆入库到关系数据库按需查询);扫描件质量差的宁可不入库,错误文字入库后的检索误导远大于信息缺失。
深水区三:权限怎么办? 企业场景里,不同部门能看的文档不同。把权限做进检索层(检索时按用户身份过滤元数据),比做进生成层(生成后再审查答案)可靠得多——后者等于允许敏感内容先进入模型再补救,既不安全也难彻底。这也呼应了元数据的价值:没有入库时的归属标记,检索层过滤无从谈起。权限设计还有一个常被低估的细节:权限变更的生效速度。员工调岗后权限收紧,知识库的过滤规则必须同步更新,否则旧权限残留就是一个持续放大的泄露口。把权限元数据挂到企业的统一身份系统上做实时校验,比在知识库里维护一份静态权限表稳妥。
数据流转的完整视角用一张图收束:
这张图也标出了知识库工程与后端数据工程的分界:后者把数据整理到"人能用",前者要整理到"检索器能用、模型能读"。多出来的要求主要是两点——块级语义完整性(人看全篇,检索只见切块)与块级元数据(人靠目录找,检索靠标记过滤)。理解这个分界,你就能准确判断哪些数据平台的现成能力可以复用、哪些必须为 RAG 重做。
本节要点回顾
- 六道工序:数据获取、清洗预处理、知识表示(分块加向量化)、存储、维护、更新;分块是全线的质量杠杆。
- 分块三参数:策略(固定、语义、递归)、块大小(五百到一千字符起步)、重叠量(一至两成),代码与表格要按语法和结构边界切。
- 存储选型:向量库为主、元数据进关系库是稳妥默认;千万块规模以下不必纠结产品差异。
- 运维五动作:增量更新、定期重抓、定期复清、索引重建、版本控制——知识库是需要保鲜的设施。
- 元数据杠杆:来源登记与时效标记的收益,往往高于升级嵌入模型。
知识库这条地基打牢后,一个检验标准可以自查:随便抽一份入库文档,你能说出它的来源、入库时间、版本与负责人。说不出,说明治理还停在文件堆阶段;说得出,后面的检索与生成优化才有意义。
地基打好了,下一节进入在线侧:检索模块如何把用户的一句话,变成五个相关的文本块。详见第 2 节。