3.1 散点图 scatterplot
3.1 散点图 scatterplot
scatterplot 把两个数值列映射到 x、y 位置,是关系问题最诚实的起点——不做任何聚合,每个观测原样落点。
第 2 章结束时我们说"散点图不过是把两个边际分布钉在同一坐标系"。本章从这里出发:位置通道占满 x 和 y 之后,剩下的视觉通道如何分配,以及点太多时怎么办。
通道分配是一门设计活
import seaborn as sns import matplotlib.pyplot as plt tips = sns.load_dataset('tips') # 四通道同时在线:x y 位置、hue 颜色、size 大小 ax = sns.scatterplot( data=tips, x='total_bill', y='tip', hue='time', # 餐段:两级类别,交给颜色 size='size', # 用餐人数:数值,交给点大小 sizes=(20, 200), # 大小通道的缩放范围(点直径,磅) alpha=0.7, ) ax.set_xlabel('总消费(美元)') ax.set_ylabel('小费(美元)') # 输出说明:主对角线带是小费随消费增长的总体趋势; # 大点(多人桌)在对角带上方的占比更高,暗示人数也影响小费绝对值
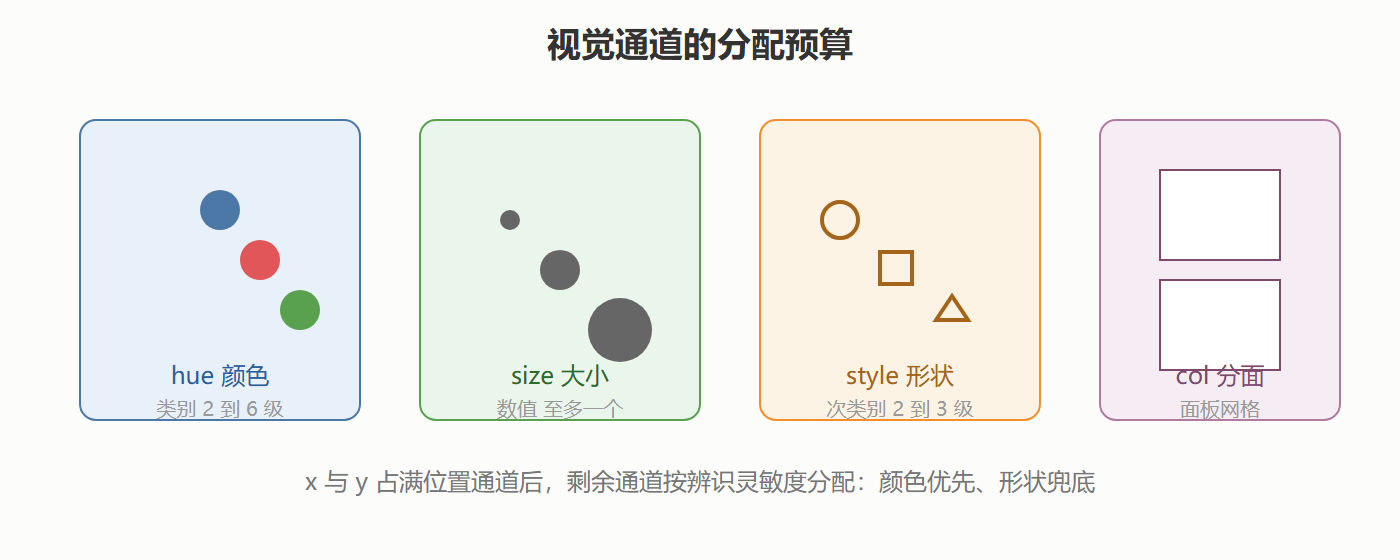
分配原则可以固化成三条:
- 类别维度优先给 hue:人眼对颜色分组的辨识最灵敏,两到六级类别最合适;
- 数值维度给 size:大小是有序的,匹配数值语义,但别超过一个——两个大小通道人眼无法分离;
- style 留给次重要的两三级类别:形状辨识度低于颜色,通常与 hue 搭配做交叉分组(如 hue=性别、style=吸烟区)。
sizes=(20, 200) 是细节层里容易被忽略的参数:默认映射范围可能让点大小差异不明显或夸张失真,报告图里几乎总要手动调。
过绘:散点图的头号敌人
# 构造高密度数据:一万个点挤在相关带里 import numpy as np rng = np.random.default_rng(42) df = pd.DataFrame({ 'x': rng.normal(0, 1, 10000), 'y': rng.normal(0, 1, 10000) * 0.5 + rng.normal(0, 1, 10000), }) fig, axes = plt.subplots(1, 3, figsize=(13, 3.5)) sns.scatterplot(data=df, x='x', y='y', ax=axes[0]) # 实心不透明:糊成墨团 sns.scatterplot(data=df, x='x', y='y', alpha=0.05, s=10, ax=axes[1]) # 透明度:密度浮现 sns.histplot(data=df, x='x', y='y', bins=60, ax=axes[2]) # 二维直方图:改数密度 plt.show() # 输出说明:第一张只能看出"有关系";第二张中心到边缘的密度渐变清晰; # 第三张用颜色表示每格计数,样本量信息完整保留
三个对策按代价递增:透明度(alpha 加小点径)零成本;二维直方图与二维密度(sns.kdeplot 双列版)适合讲"密度在哪";抽样(df.sample(2000))适合必须保留散点形态的报告。哪一种都好过硬画一万个实心点。
案例复现:iris 的特征空间侦察
背景:用 iris 做分类建模前,需要快速确认哪些特征组合对区分物种有效。
操作:
iris = sns.load_dataset('iris') ax = sns.scatterplot( data=iris, x='petal_length', y='petal_width', hue='species', style='species', # 颜色加形状双编码,黑白打印也能区分 palette='Set2', alpha=0.8, ) ax.set_xlabel('花瓣长度(厘米)') ax.set_ylabel('花瓣宽度(厘米)')
结果解读:setosa 与另外两族之间存在一条平行于坐标轴的清晰鸿沟(花瓣长度约 2.5 厘米处),线性模型即可分离;versicolor 与 virginica 在对角带上重叠约一成样本,任何模型在这里都要付出误分代价。变式:把 style 换成 size='sepal_length',可以顺带检查萼片长度是否携带第四维信息;或加 sns.kdeplot(contour=True) 叠一层等高线突出重叠区。
# 图层叠加:散点之上铺各组等高线,重叠区一目了然 ax = sns.scatterplot(data=iris, x='petal_length', y='petal_width', hue='species', alpha=0.35, legend=False) sns.kdeplot(data=iris, x='petal_length', y='petal_width', hue='species', ax=ax, levels=4, alpha=0.6) # 散点做证词,等高线做总结——第 2.2 节的 rug 思路在二维的延续
⚠️ 常见坑:把数值列交给 hue 却想要离散分组(如用 0/1 编码的性别),得到的是一条连续色带加渐变图例。先转 category,再画。
💡 关键直觉:散点图是"证词",聚合图是"判决"。任何基于均值的结论,都应该先有一张不聚合的散点在前面兜底。
本节要点回顾
- 通道分配三原则:类别给 hue、数值给 size(至多一个)、次类别给 style;
- sizes 手动定域:默认大小映射在报告图里几乎总要重设;
- 过绘三对策:透明度、密度图、抽样,按信息损失从小到大选;
- 双编码抗降级:hue 加 style 让黑白打印也能分组;
- 散点在上、密度在下:图层叠加互相印证,防止聚合骗人。
下一节给 x 轴引入时间或顺序语义,看 lineplot 如何在重复观测上悄悄做统计。
评论区
(0)
U