多模态表征
多模态表征
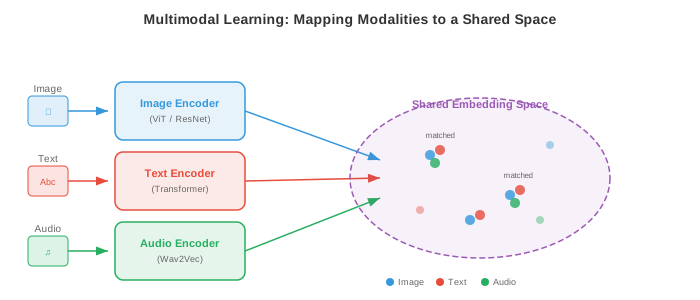
多模态表征将视觉、语言与音频桥接到共享的嵌入空间中。本文件涵盖融合策略、CLIP、ALIGN、SigLIP、对比损失函数(InfoNCE、NT-Xent)、零样本分类以及检索评估。
-
想象你正坐在一家咖啡馆里。你看到桌上冒着热气的杯子,听到陶瓷碰撞的叮当声,闻到烘焙咖啡豆的香气,还感受到杯子传来的温热。任何单一感官都无法告诉你全部信息:你的大脑把这些信号融合成一个统一的「热咖啡」感知。**多模态学习(multimodal learning)**为机器做的事正是如此:它把来自多种模态(视觉、语言、音频等)的信息结合起来,从而构建出比任何单一模态都更丰富、更鲁棒的表征。
-
**模态(modality)**是信息的一种独立通道。在机器学习中,最常见的模态有图像(像素网格)、文本(词元序列)、音频(波形或频谱图,见第 9 章)、视频(帧序列)以及结构化数据(表格、图)。每种模态都有自身的统计结构:图像具有空间连贯性,文本是序列化且离散的,音频是时间序列且连续的。多模态学习的挑战,就在于桥接这些本质上截然不同的数据类型。
-
为什么要费力气把多种模态组合起来?因为它们提供的是互补的信息。一张狗的照片能告诉你它的品种和毛色,却不知道它的名字;而一句「我的金毛猎犬 Max」的描述告诉你名字和品种,却看不到具体的姿态。图像和文本合在一起,比任何一方单独给出的画面都要完整。这种互补性正是核心动机:多模态模型能够回答问题、生成内容、做出决策,而这些是任何单模态模型都做不到的。
融合策略
-
把它想象成一个小组作业。你有两种合并想法的方式:要么从一开始大家就在同一个房间里一起工作(共享原始笔记和草稿),要么每个人独立写完自己的部分,最后再把定稿合并起来。这两种方式分别对应多模态学习中的早期融合(early fusion)与晚期融合(late fusion)。
-
早期融合(又称特征级融合)会在任何严肃的处理发生之前,就把来自不同模态的原始或低级特征拼接或混合起来。例如,你可以把图像的像素特征和文本的词元嵌入拼接起来,把合并后的序列送进一个单独的 transformer。模型从一开始就能学到细粒度的跨模态交互,但输入空间很大,而且模型必须学会同时处理截然不同的数据类型。
-
形式上,给定来自两个模态的特征向量 x_{\text{img}} \in \mathbb{R}^{d_1} 和 x_{\text{txt}} \in \mathbb{R}^{d_2},早期融合只是简单地把它们拼接起来:
-
然后这个拼接向量会被一个共享网络处理。优点是模型可以在每一层都发现跨模态关联;缺点是计算开销大,而且很难对齐非常不同的特征类型(稠密的像素值 vs. 稀疏的词元索引)。
-
晚期融合(又称决策级融合)则让每种模态独立地经过各自的编码器,为每种模态产生一个高层表征甚至最终预测,然后再把这些输出合并起来——通常是通过分数平均、投票或一个可学习的组合层。晚期融合更简单,也允许你直接复用现成的预训练单模态模型,但它无法捕捉低层的跨模态交互,因为各模态之间从未「看到」过彼此的原始特征。
-
给定各模态的预测 \hat{y}_1 和 \hat{y}_2,一个简单的晚期融合规则是:
-
其中 \alpha \in [0, 1] 是一个可学习或人工调节的混合权重。
-
中间融合(又称中级融合)则是大多数现代系统采用的务实折中方案。每种模态先由各自的编码器处理(抽取模态特有的特征),然后在网络的中间某处,通过交叉注意力层(cross-attention)把编码后的表征合并起来。这让每个编码器都能专注于自己的模态,同时仍然能够进行丰富的跨模态交互。Flamingo、LLaVA 以及大多数视觉语言模型(见第 02 节)都使用中间融合。
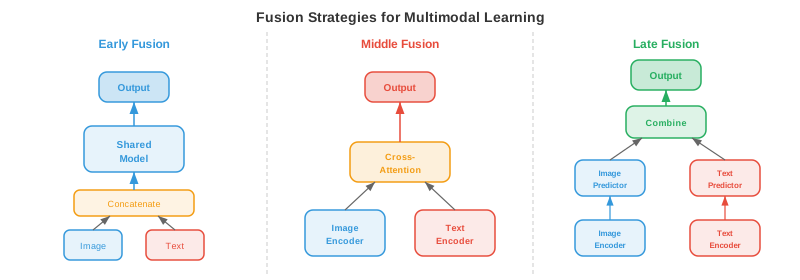
- 在融合策略之间的取舍取决于数据可用性、计算预算和具体任务。早期融合能力强但非常吃数据;晚期融合便宜但能力有限;带交叉注意力的中间融合因为兼顾表达力与模块化,已经成为大规模多模态模型的主流方法。
联合嵌入空间
-
想象一位万能翻译官,能把任何语言的任何句子映射到同一个共享「意义空间」中的同一个点。无论是英语、法语还是日语的「沙滩上的一只狗」,都会落到同一个坐标上。**联合嵌入空间(joint embedding space)**做的正是这件事,只不过是跨越模态:一张沙滩上狗的图片,和文本「沙滩上的一只狗」,应该映射到同一个向量空间中相近的点。
-
形式上,我们学习两个编码器函数:模态 1(例如图像)的 f_\theta : \mathcal{X}_1 \to \mathbb{R}^d 和模态 2(例如文本)的 g_\phi : \mathcal{X}_2 \to \mathbb{R}^d。两者都把各自的输入映射到同一个 d 维空间。训练目标保证语义匹配的对 (x_1, x_2) 的嵌入 f_\theta(x_1) 和 g_\phi(x_2) 彼此接近(余弦相似度高),而不匹配的对则相距很远。
-
这其实是第 7 章词嵌入空间的直接推广。回想一下,Word2Vec 和 GloVe 把语义相近的词放在向量空间中相近的位置。联合嵌入空间把这个想法扩展到了跨模态:我们衡量的不再是词与词之间的相似度,而是图像与文本、音频与文本、甚至图像与音频之间的相似度。
-
相似度度量几乎总是用余弦相似度(cosine similarity)(第 1 章):
- 通过把所有嵌入做 L_2 归一化到单位超球面上,余弦相似度就简化成一个简单的点积 u \cdot v,计算极其高效,还可以用近似最近邻库来加速。
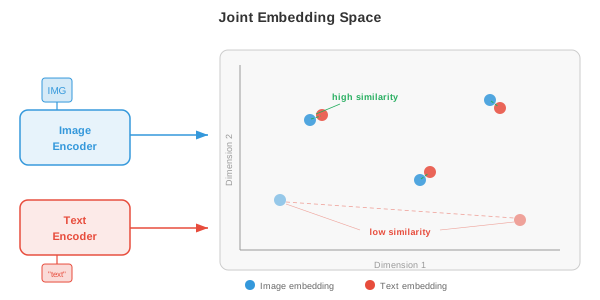
- 联合嵌入空间的威力在于它带来了零样本迁移(zero-shot transfer)。一旦你把图像和文本嵌入对齐好,就可以把图像分到你从未训练过的类别里:只需把类别名称作为文本嵌入,再看哪个文本嵌入离图像嵌入最近即可。完全不需要针对具体任务做微调。这正是 CLIP 及其后续模型背后的关键洞见。
用于多模态对齐的对比学习
-
想象一个课堂练习:学生们拿到被打乱的照片和说明对,要把每张照片和正确的说明配对。要做好这件事,你既需要理解视觉内容,又需要理解语言,还需要知道两者如何对应。**对比学习(contrastive learning)**正是这样训练模型:给定一个批次的(图像,文本)对,模型必须搞清楚哪张图像配哪段文本。
-
正如我们在第 8 章(第 04 节)所见,单模态场景下的对比学习(SimCLR、MoCo)把同一张图像的不同增广视图拉近,把不同图像的视图推远。多模态对比学习则用「匹配的模态」替代「增广视图」:一张图像和它的说明是正样本对;这张图像与批次中其他任何说明配对都是负样本对。
CLIP
-
CLIP(Contrastive Language-Image Pre-training,对比式语言–图像预训练,Radford 等,2021)是多模态对比学习的基础模型。它在从互联网抓取的 4 亿对(图像,文本)上,联合训练一个图像编码器(ViT 或 ResNet,第 8 章)和一个文本编码器(transformer,第 7 章)。
-
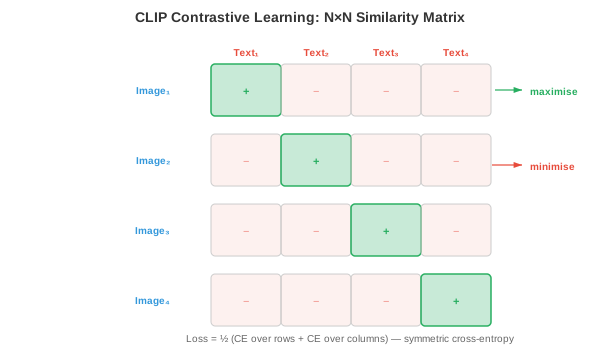
给定一个含 N 个图像–文本对的批次,CLIP 计算所有图像嵌入和所有文本嵌入之间余弦相似度构成的 N \times N 矩阵。对角线元素是匹配对(正样本),所有非对角线元素都是不匹配的(负样本)。训练损失把对角线元素推高,把非对角线元素压低。
-
这个损失是一个对称的交叉熵。对于图像 i 与文本 j = i 配对,图像到文本的损失是:
- 而文本到图像的损失则是把角色对调:
- CLIP 的总损失是这两者的平均:
- 这里 \tau 是一个可学习的**温度(temperature)**参数(初始化为 \tau = 0.07)。温度控制着 softmax 分布的尖锐程度:\tau 低时模型会更用力地聚焦于最接近的匹配,\tau 高时概率分布更平摊。CLIP 把 \tau 和模型权重一起联合学习,而不是把它当作固定的超参数。
-
CLIP 的图像编码器通常用 ViT-L/14(一个带 14x14 图块的大型视觉 transformer,见第 8 章第 04 节)。文本编码器是一个 12 层、带因果掩码的 transformer(类似 GPT,见第 7 章第 04 节)。两个编码器都通过一个可学习的线性投影把输出投影到一个共享的 512 或 768 维空间,再做 L_2 归一化。
-
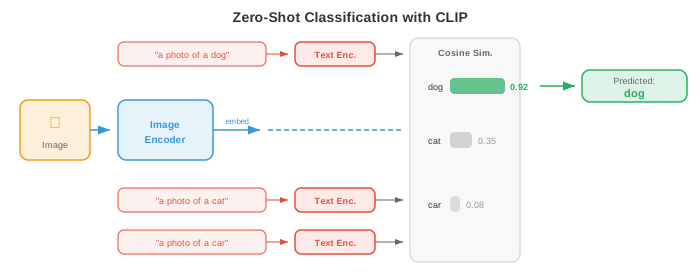
CLIP 最令人瞩目的特性是零样本图像分类(zero-shot image classification)。要把一张图像分到 K 个类别之一,你可以构造 K 个形如「a photo of a {类别名}」的文本提示,用文本编码器嵌入每个提示,用图像编码器嵌入这张图像,然后挑选文本嵌入与图像嵌入余弦相似度最高的那个类别。在 ImageNet 上,CLIP 在从未见过任何一个 ImageNet 训练样本的情况下,取得了有竞争力的准确率。
ALIGN
- ALIGN(Jia 等,2021)把 CLIP 的方法扩展到一个更嘈杂、更庞大的数据集:18 亿对几乎不过滤的图像–文本对。CLIP 谨慎地整理数据,而 ALIGN 则证明:规模足以弥补噪声。ALIGN 用 EfficientNet 作图像编码器、BERT 作文本编码器,并用同样的对比损失训练。关键发现是:只要有足够多的数据,就不需要昂贵的数据清洗——因为对比目标天然会降低噪声对的权重,因为它们产生不一致的梯度。
SigLIP
-
SigLIP(Sigmoid Loss for Language-Image Pre-training,基于 sigmoid 损失的语言–图像预训练,Zhai 等,2023)用一个更简单的 sigmoid 损失替代了 CLIP 基于 softmax 的对比损失。它不再把 N \times N 相似度矩阵当作分类问题(每一行对各列做一次 softmax),而是把每个元素独立地当作一个二分类:这一对(图像,文本)是否匹配?
-
一对 (i, j) 的 SigLIP 损失是:
-
其中 y_{ij} = 1 当 i = j(匹配)时,否则 y_{ij} = 0,\sigma 是 sigmoid 函数。
-
SigLIP 关键的优势在于它不再需要对整个批次做全局 softmax 归一化。在 CLIP 里,softmax 的分母需要在所有设备上汇总所有嵌入,这是分布式训练中的通信瓶颈。SigLIP 逐对的 sigmoid 损失可以在本地计算,从而能更高效地扩展到非常大的批次。SigLIP 在更低训练成本下达到了与 CLIP 相当的质量。
对比损失函数详解
- 对比学习中使用的损失函数都有一个共同结构:它们都试图让正样本对的相似度得分高于负样本对,并通过某种「间隔(margin)」或「温度」的概念来控制模型推进的力度。下面我们把几种主要变体形式化。
InfoNCE
- InfoNCE(噪声对比估计,van den Oord 等,2018)是 CLIP 损失背后的理论基础。给定一个查询 q、一个正样本键 k^+ 和 K 个负样本键 \{k_1^-, \ldots, k_K^-\},损失为:
- 这是一个 (K+1) 路分类问题:在 K+1 个候选中找出正样本。InfoNCE 是查询与正样本键之间互信息的下界,这就是为什么最大化它能对齐语义匹配输入的表征。随着负样本数 K 增大,这个界会变紧,这也解释了为什么对比方法会从大批次中受益。
NT-Xent
- NT-Xent(归一化的温度缩放交叉熵,Chen 等,2020)是 SimCLR(第 8 章第 04 节)使用的损失,本质上就是在批次内对称地应用 InfoNCE。对于一个含 N 对的批次,2N 个增广视图为每个锚点产生 2N - 2 个负样本(除自己和自己的正样本外所有视图)。正样本对 (i, j) 的损失是:
- NT-Xent 和 InfoNCE 是同一个数学公式,只是因为在是在不同语境下(自监督视觉 vs. 表征学习理论)提出的,名字不同而已。
温度的作用
-
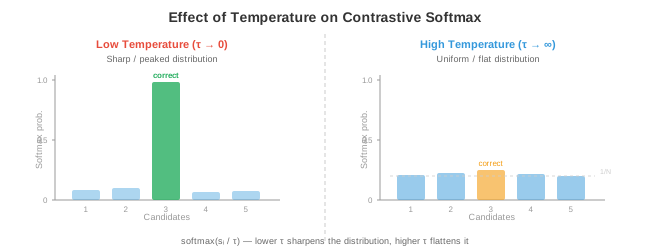
温度 \tau 是对比学习里最重要的超参数之一。要建立直觉,可以想想物理学意义上的温度:高温下分子随机运动(softmax 很平坦,所有负样本看起来一样差);低温下分子排成刚性结构(softmax 很尖锐,只有最难负样本才算数)。
-
形式上,当 \tau \to 0 时,softmax 趋近于只挑选单个最难负样本的硬 argmax;当 \tau \to \infty 时,所有负样本贡献相同。实践中,\tau \in [0.01, 0.1] 对归一化嵌入效果很好。温度过低会导致训练不稳定(对难负样本的梯度变得非常大);温度过高又会让损失对违规不敏感。
-
CLIP 把 \tau 初始化为 0.07,并以对数参数化的标量 \tau = \exp(t) 来学习它,其中 t 与模型权重一起通过梯度下降更新。这样模型就能在训练过程中自动调节对比任务的难度。
三元组损失与基于间隔的替代方案
- 在 InfoNCE 一统天下之前,**三元组损失(triplet loss)**曾是度量学习的标准。给定锚点 a、正样本 p 和负样本 n:
-
其中 m 是一个间隔,保证正样本至少比负样本近 m。三元组损失作用在单个三元组上而不是整个批次,所以样本效率不如 InfoNCE。它对挖掘策略也很敏感:随机负样本往往太容易(损失为零),因此难负样本挖掘(hard negative mining)(选最接近的错误匹配)或半难样本挖掘(semi-hard mining)(选间隔内的负样本)至关重要。
-
InfoNCE 隐式地在整个批次内做了难负样本挖掘,这是它在规模上优于三元组损失的原因之一。InfoNCE 中的 softmax 归一化会自动给难负样本(与锚点相似度高的那些)更高的权重,从而提供了一种自然的课程学习,无需显式挖掘。
图像–文本检索与零样本分类
-
一旦你训练好一个联合嵌入空间,就可以做图像–文本检索(image-text retrieval):给定一张图像查询,从数据库中找出最相关的文本(图到文检索);或者给定一段文本查询,找出最相关的图像(文到图检索)。这其实就是共享嵌入空间中的最近邻搜索。
-
想象一位图书管理员,能瞬间把任何一张照片和百万条目录里的任何一句说明做比对。他不需要预先了解所有可能的类别,只需衡量每张照片与每条说明有多「接近」。CLIP 类模型做检索和零样本分类的方式正是如此。
-
零样本分类是文到图检索的一个特例。给定 K 个类别名,你构造文本提示 \{t_1, \ldots, t_K\}(例如「a photo of a cat」「a photo of a dog」)并嵌入它们。对于一张新图像 x,预测的类别是:
-
关键洞见是:文本编码器充当了一个灵活的分类头。你不必为每个下游任务训练一个新的线性层,只需用自然语言把任务描述出来。这就是 CLIP 泛化得这么好的原因:文本编码器在预训练阶段已经见过数百万种多样的描述。
-
**提示工程(prompt engineering)**很重要。CLIP 在 ImageNet 上的零样本准确率,仅仅通过把提示模板从「{类别名}」改成「a photo of a {类别名}」,就从 63.2% 提升到 68.4%。更进一步,**提示集成(prompt ensembling)**把多个模板(例如「a photo of a {类别名}」「a good photo of a {类别名}」「a drawing of a {类别名}」)的文本嵌入取平均,得到更鲁棒的文本表征。
视听对应关系
-
闭上眼睛,听一个人拍篮球。你可以从有节奏的「砰砰」声中判断出它什么时候撞击地面。现在睁开眼睛:视觉上的弹跳与每一次「砰」完美对齐。音频事件与视觉事件之间这种紧密的对应关系,是一种机器可以学习的免费监督信号。**视听对应关系学习(audio-visual correspondence learning)**训练模型把声音与其视觉来源关联起来,完全不需要任何人工标注。
-
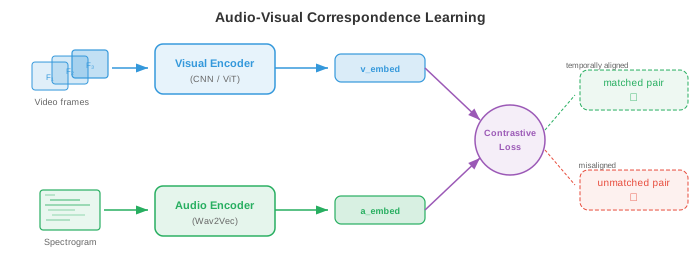
这个想法与 CLIP 惊人地相似,只不过用音频替代了文本。给定成对的视频帧和音频片段,模型学习一个嵌入空间,其中时间上对齐的视听对相近,不对齐的对相距很远。
-
**Audio-Visual Embedding(AVE)**方法(Arandjelovic 和 Zisserman,2017)在视频数据上用一个对比损失训练视觉编码器 f 和音频编码器 g。正样本对是(同一时刻的视频帧,音频片段),负样本是来自不同视频或不同时刻的音频片段。模型在没有任何标签的情况下,学会了狗叫的声音配狗的图像、吉他的声音配吉他的图像。
-
音频编码器通常用 CNN 或音频 transformer 处理对数梅尔频谱图(log-mel spectrogram)(第 9 章第 01 节),产生固定大小的嵌入。视觉编码器用标准图像骨干(ResNet、ViT)处理视频帧。两者都投影到一个共享的 d 维空间,训练时用与 CLIP 相同的 InfoNCE 损失:
-
视听学习的应用包括:声源定位(声音来自图像中的哪个位置?)、视听语音识别(把嘴唇动作与音频结合起来,见第 9 章第 02 节)、视听声源分离(通过看说话人的脸来分离他的声音,即第 9 章第 05 节中的「鸡尾酒会问题」),以及受音频条件控制的视频生成。
-
ImageBind(Girdhar 等,2023)把这一思路扩展到六种模态:图像、文本、音频、深度、热成像和 IMU 数据。关键洞见是:你并不需要为每一种模态组合都准备配对数据。只要把每种模态都对齐到图像(用图文对来对齐文本,用图音对来对齐音频,以此类推),所有模态就通过共享的图像嵌入空间隐式地对齐了。这种通过一个公共锚点模态「绑定」的方式产生了一种涌现的对齐:音频和文本会变得相似,即便它们从未被直接一起训练过。
评估
- 评估多模态模型需要能够刻画跨模态理解能力的指标。两种主流评估范式是零样本基准(zero-shot benchmark)和检索指标(retrieval metric)。
零样本基准
-
零样本评估衡量的是模型能否完成它从未被显式训练过的任务。最常见的基准是 ImageNet 零样本准确率:把全部 1,000 个 ImageNet 类别名作为文本嵌入,嵌入每张测试图像,再根据余弦相似度衡量 top-1 和 top-5 分类准确率。CLIP ViT-L/14 零样本就能取得 75.5% 的 top-1 准确率,堪比在 ImageNet 上有监督训练的 ResNet-50。
-
其他零样本基准还包括:CIFAR-10/100、STL-10、Food-101、Oxford Pets 和 Flowers-102。在许多数据集上评估,是为了检验模型到底是真正具备通用的视觉理解能力,还是只是记住了预训练数据中的模式。
-
**线性探测(linear probe)**评估是一种互补的测试。你冻结预训练的图像编码器,为一个带标签的数据集抽取特征,然后在上面训练一个简单的线性分类器。这衡量的是所学表征本身的质量,与零样本检索机制无关。CLIP 的特征是非常优秀的线性探测特征,往往能与有监督预训练匹敌甚至超越它。
检索指标
-
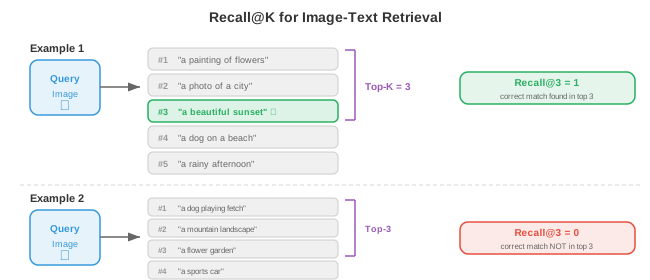
对于检索任务(图到文和文到图),标准指标是 Recall@K(R@K):正确匹配出现在前 K 个检索结果中的查询所占比例。常见的取值有 R@1、R@5 和 R@10。
-
形式上,对于一组共 Q 个查询:
-
其中 \text{rank}(q) 是正确匹配在查询 q 的排序检索列表中的位置。
-
标准检索基准包括 Flickr30K(31,000 张图像,每张 5 条说明)和 MS-COCO(123,000 张图像,每张 5 条说明)。评估在测试集上进行:给定一张图像,从整个测试集中检索正确的说明(们),反之亦然。
-
**中位排名(MedR)**是一种互补指标:所有查询中正确匹配排名的中位数。完美的模型 MedR = 1。这个值越小越好。
-
除了检索之外,多模态模型还会在组合理解类基准上被评估,例如 Winoground(测试模型能否区分「杯子里的狗」和「狗里的杯子」)和 ARO(属性、关系、顺序),它们用来检验模型到底是真正理解了语言的结构,还是只是在匹配词袋。CLIP 类模型在这些基准上往往表现挣扎,揭示了一个根本局限:对比式预训练对齐了全局语义,但可能无法捕捉细粒度的组合结构。
串联起来
-
本文件涵盖的多模态表征构成了本章后续所有内容的基础。由 CLIP 及其后续模型训练出的联合嵌入空间,是连接视觉与语言的「胶水」。第 02 节将在这个基础上介绍视觉语言模型,它们超越检索,能够生成关于图像的文本。第 03 节探讨如何把图像和视频分词以便用于序列模型。第 04 节讲解跨模态生成(文生图、文生视频)。第 05 节则审视在单个模型内处理多种模态的统一架构。
-
核心要点:在配对数据上的对比学习能产生嵌入空间,在其中不同模态是可以互换的。图像嵌入和文本嵌入变成了「同一种东西」,从而支持零样本分类、检索,并无缝集成到更大的系统中。这个想法如此简单——不过是把匹配的对拉近、把不匹配的对推远——却掩饰了它非凡的有效性。
编程练习(使用 CoLab 或 notebook)
- 从零实现 CLIP 对比损失。创建随机的图像和文本嵌入,计算相似度矩阵,并计算对称交叉熵损失。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt def clip_loss(image_embeds, text_embeds, temperature=0.07): """计算对称的 CLIP 对比损失。""" # L2 归一化嵌入 image_embeds = image_embeds / jnp.linalg.norm(image_embeds, axis=1, keepdims=True) text_embeds = text_embeds / jnp.linalg.norm(text_embeds, axis=1, keepdims=True) # 计算余弦相似度矩阵 (N x N) logits = image_embeds @ text_embeds.T / temperature # (N, N) # 标签:对角线(第 i 张图像匹配第 i 段文本) N = logits.shape[0] labels = jnp.arange(N) # 对称交叉熵:图像到文本 + 文本到图像 loss_i2t = -jnp.mean(jax.nn.log_softmax(logits, axis=1)[jnp.arange(N), labels]) loss_t2i = -jnp.mean(jax.nn.log_softmax(logits, axis=0)[labels, jnp.arange(N)]) return (loss_i2t + loss_t2i) / 2, logits * temperature # 模拟 64 维空间中一个含 8 对图像–文本的批次 key = jax.random.PRNGKey(42) k1, k2 = jax.random.split(key) N, D = 8, 64 image_embeds = jax.random.normal(k1, (N, D)) text_embeds = jax.random.normal(k2, (N, D)) loss, sim_matrix = clip_loss(image_embeds, text_embeds) print(f"CLIP loss (random embeddings): {loss:.4f}") # 可视化相似度矩阵 fig, ax = plt.subplots(figsize=(6, 5)) im = ax.imshow(sim_matrix, cmap='coolwarm', vmin=-1, vmax=1) ax.set_xlabel("Text index"); ax.set_ylabel("Image index") ax.set_title(f"Cosine Similarity Matrix (loss={loss:.3f})") plt.colorbar(im); plt.tight_layout(); plt.show() # 试试改变 temperature(0.01、0.1、1.0),观察损失如何变化 # 试试让匹配对相似:令 text_embeds = image_embeds + 小噪声
- 构建一个玩具级的联合嵌入模型,用 InfoNCE 损失和梯度下降学习把二维「图像」(随机向量)与「说明」(不同的随机向量)对齐。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt def info_nce_loss(img_enc, txt_enc, img_data, txt_data, tau=0.1): """在配对的(图像,文本)数据上计算 InfoNCE。""" z_img = img_data @ img_enc # (N, D) z_txt = txt_data @ txt_enc # (N, D) # L2 归一化 z_img = z_img / jnp.linalg.norm(z_img, axis=1, keepdims=True) z_txt = z_txt / jnp.linalg.norm(z_txt, axis=1, keepdims=True) logits = z_img @ z_txt.T / tau labels = jnp.arange(logits.shape[0]) return -jnp.mean(jax.nn.log_softmax(logits, axis=1)[jnp.arange(len(labels)), labels]) # 创建 32 个配对样本:img 在 R^8,txt 在 R^6,嵌入到 R^4 key = jax.random.PRNGKey(0) k1, k2, k3, k4 = jax.random.split(key, 4) N, d_img, d_txt, d_embed = 32, 8, 6, 4 img_data = jax.random.normal(k1, (N, d_img)) txt_data = jax.random.normal(k2, (N, d_txt)) # 可学习的投影矩阵 img_enc = jax.random.normal(k3, (d_img, d_embed)) * 0.1 txt_enc = jax.random.normal(k4, (d_txt, d_embed)) * 0.1 grad_fn = jax.jit(jax.grad(info_nce_loss, argnums=(0, 1))) lr = 0.05 losses = [] for step in range(300): loss = info_nce_loss(img_enc, txt_enc, img_data, txt_data) losses.append(float(loss)) g_img, g_txt = grad_fn(img_enc, txt_enc, img_data, txt_data) img_enc = img_enc - lr * g_img txt_enc = txt_enc - lr * g_txt print(f"Initial loss: {losses[0]:.3f}, Final loss: {losses[-1]:.3f}") print(f"Random baseline (log N): {jnp.log(N):.3f}") plt.figure(figsize=(8, 4)) plt.plot(losses, color='#2c3e50') plt.axhline(y=0, color='green', linestyle='--', alpha=0.5, label='Perfect alignment') plt.axhline(y=float(jnp.log(N)), color='red', linestyle='--', alpha=0.5, label='Random (log N)') plt.xlabel("Step"); plt.ylabel("InfoNCE Loss") plt.title("Learning a Joint Embedding Space") plt.legend(); plt.grid(alpha=0.3); plt.tight_layout(); plt.show() # 修改 d_embed(试试 2、4、16),看看嵌入维度如何影响对齐
- 用预先计算好的嵌入实现零样本分类。把类别「原型」模拟为文本嵌入,通过对最近邻查找来给新图像分类。
import jax import jax.numpy as jnp import matplotlib.pyplot as plt # 模拟 5 个类别,每个类别在 R^32 中有一个原型文本嵌入 key = jax.random.PRNGKey(42) n_classes, d = 5, 32 class_names = ["cat", "dog", "car", "plane", "ship"] # 类别原型(假设它们来自文本编码器) k1, k2 = jax.random.split(key) class_prototypes = jax.random.normal(k1, (n_classes, d)) class_prototypes = class_prototypes / jnp.linalg.norm(class_prototypes, axis=1, keepdims=True) # 生成 200 张测试「图像」(嵌入在类别原型附近 + 噪声) n_per_class = 40 true_labels = jnp.repeat(jnp.arange(n_classes), n_per_class) keys = jax.random.split(k2, n_classes * n_per_class) image_embeds = [] for i in range(n_classes): noise = jax.random.normal(keys[i], (n_per_class, d)) * 0.5 cluster = class_prototypes[i] + noise image_embeds.append(cluster) image_embeds = jnp.concatenate(image_embeds, axis=0) image_embeds = image_embeds / jnp.linalg.norm(image_embeds, axis=1, keepdims=True) # 零样本分类:与每个原型的余弦相似度 similarities = image_embeds @ class_prototypes.T # (200, 5) predicted_labels = jnp.argmax(similarities, axis=1) accuracy = jnp.mean(predicted_labels == true_labels) print(f"Zero-shot accuracy: {accuracy:.1%}") # 混淆矩阵 conf = jnp.zeros((n_classes, n_classes), dtype=jnp.int32) for true, pred in zip(true_labels, predicted_labels): conf = conf.at[true, pred].add(1) fig, ax = plt.subplots(figsize=(6, 5)) im = ax.imshow(conf, cmap='Blues') ax.set_xticks(range(n_classes)); ax.set_xticklabels(class_names, rotation=45) ax.set_yticks(range(n_classes)); ax.set_yticklabels(class_names) ax.set_xlabel("Predicted"); ax.set_ylabel("True") for i in range(n_classes): for j in range(n_classes): ax.text(j, i, int(conf[i, j]), ha='center', va='center', fontsize=11) ax.set_title(f"Zero-Shot Confusion Matrix (acc={accuracy:.1%})") plt.colorbar(im); plt.tight_layout(); plt.show() # 试着增大噪声(0.5 -> 1.0 -> 2.0)观察准确率如何下降 # 试着加入提示集成:对每个原型取 3 个带噪副本的平均