1.2 装配线核心零件图鉴
1.2 装配线核心零件图鉴:模型、提示、链、记忆、检索、工具、回调
本节摘要:LangChain 由七类核心零件组成——模型接口、提示模板、链、记忆、检索、工具与代理、回调。本节给每个零件发一张铭牌:职责、最小代码、接口约定,并说明它们如何在传送带上咬合,是全教程的零件总目录。
先把七个工位一次认全
进车间先看铭牌墙。下面的图就是 LangChain 的零件总目录,七类零件各守一个工位,实线是主传送带的走向,虚线表示"挂在工位上的辅助装置"。
装配线零件工位图
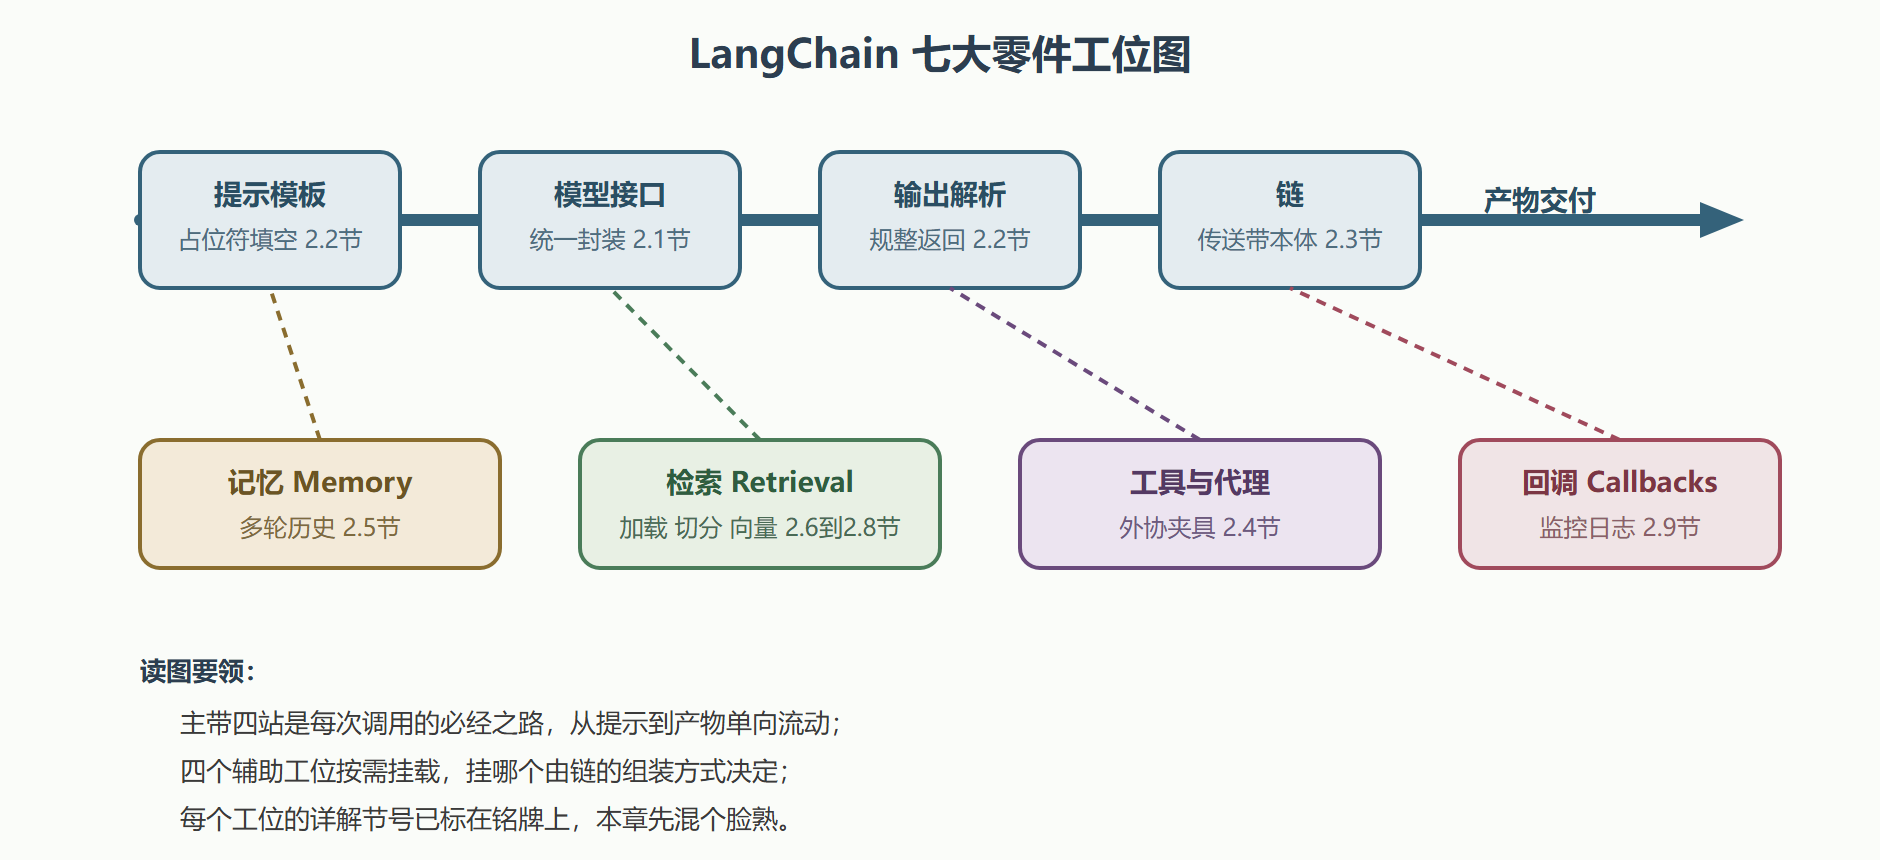
下面逐个打开看一眼最小形态。代码只求"认脸",不求吃透——每个零件在对应章节都有整节的拆解。
逐个零件的最小代码
零件一:模型接口。 把不同厂商的模型封装成同一类对象,调用方式统一为 invoke。这是装配线的动力单元,换供应商只改这一件。
from langchain_openai import ChatOpenAI llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0) result = llm.invoke("用一句话解释什么是向量数据库") print(result.content) # 输出示例:向量数据库是专门存储和检索高维向量的数据库,常用于语义搜索。
零件二:提示模板。 把提示词从代码里抽出来变成带占位符的模板,变量后填。这是工艺单。
from langchain_core.prompts import PromptTemplate # 大括号是留给变量的空位 prompt = PromptTemplate.from_template("给一家生产{product}的公司起三个中文名字") print(prompt.format(product="彩色袜子")) # 输出:给一家生产彩色袜子的公司起三个中文名字
零件三:链。 把工艺单、动力单元、解析器锁成一道工序,用管道符连接。这是传送带本体。
from langchain_core.output_parsers import StrOutputParser chain = prompt | llm | StrOutputParser() print(chain.invoke({"product": "彩色袜子"})) # 输出示例:1. 彩织坊 2. 悦足轩 3. 棉花小铺
零件四与零件五:记忆与检索。 记忆负责把多轮历史接回提示,检索负责把私有知识接进提示,两者都挂在"工艺单"工位上,2.5 到 2.8 节展开。
零件六:工具与代理。 工具是把外部能力(搜索、计算器、数据库查询)包成模型可调用的函数;代理是让模型自己决定调用顺序的自治工位,2.4 节展开。
零件七:回调。 在链的各个阶段插入自定义代码:记日志、埋点、限流。车间监控,2.9 节展开。
零件之间的咬合关系
单看零件只是七个类名,装配线的威力在接口约定。LangChain 所有主带零件都实现了同一个可运行接口:输入一个字典或字符串,输出一个消息对象。正因接口统一,零件才能用管道符任意串接、替换、嵌套——这是全框架最核心的设计决定,值得在入门期就刻进脑子。
| 零件 | 输入 | 输出 | 可否单独上带 |
|---|---|---|---|
| 提示模板 | 变量字典 | 字符串或消息列表 | 是,带的起点 |
| 模型接口 | 字符串或消息列表 | 消息对象 | 是,动力核心 |
| 输出解析 | 消息对象 | 字符串或结构化数据 | 是,带的终点 |
| 记忆 | 会话编号 | 历史消息列表 | 否,挂在模板上 |
| 检索器 | 查询字符串 | 文档列表 | 否,挂在模板上 |
| 工具 | 参数字符串 | 执行结果字符串 | 否,挂在代理上 |
| 回调 | 事件通知 | 无 | 否,挂在任意工位 |
💡 读源码的口诀:先找链的组装处,再顺输入类型走。看到任何一段 LangChain 代码,先问"这条带上有哪些站、每站吃什么吐什么",一半的困惑会自动消失。
拿到陌生代码先拆零件
铭牌认全了,来做个拆解练习——下面这段代码在很多新手项目里都能见到,初看一头雾水,按工位拆开就清楚了:
from langchain_openai import ChatOpenAI from langchain_core.prompts import ChatPromptTemplate from langchain_core.output_parsers import JsonOutputParser # 第一站 工艺单:占位符 question 等着填 prompt = ChatPromptTemplate.from_template( "把用户投诉分类为物流、质量、尺码三类," "以 JSON 输出:{question}") # 第二站 动力单元:低温保证分类稳定 llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0) # 第三站 输出解析:把文本规整成字典 parser = JsonOutputParser() # 传送带:管道符把三站锁成一道工序 classify = prompt | llm | parser print(classify.invoke({"question": "袜子洗一次就破了"})) # 输出示例:{'category': '质量', 'confidence': 0.92}
拆解报告:主带上三站齐全——工艺单(模板)、动力单元(模型)、输出解析(JSON 解析器),管道符是传送带。没有记忆、没有检索、没有代理,说明这是一条单向直通的单轮产线;温度设为零,说明业务要的是稳定分类而不是发散创意。再看一行 import 就能猜出半段代码的用途:看到提示模板类,接下来必有变量字典;看到解析器,说明上游对输出格式有约定;看到向量库,说明这条带前面挂着立体仓库。这个"见名知位"的反应速度,就是本节要练出的能力。
两个新手常见的误认也顺便纠正:其一,RunnableWithMessageHistory 名字里没有 Memory,但它干的就是记忆工位的活——挂历史进提示,别按类名找零件;其二,检索器(Retriever)和向量库(VectorStore)不是一回事,向量库是仓库本体,检索器是仓库对外的拣货窗口,链上挂的是窗口不是仓库。零件认错工位,后面调参就会全盘错位。
本节要点回顾
- 七大零件:提示模板、模型接口、输出解析构成主带;记忆、检索、工具代理、回调是辅助工位;
- 统一可运行接口是零件能自由组装的根本原因,管道符是组装动作;
- 每个零件都有详解节号,本节只需建立"拿到代码能认零件"的映射能力;
- 辅助工位不单独上带:记忆与检索挂模板,工具挂代理,回调挂任意工位;
- 拆解陌生代码的三步:看 import 认零件、看管道找组装处、看参数猜业务意图;
- 两个易错点:记忆工位未必叫 Memory,链上挂的是检索器窗口而不是仓库本体。
下一节把车间通电:装环境、配密钥,把本节看过的零件亲手转一圈。