3.3 出厂检验:评估与测试
3.3 出厂检验:评估与测试
本节摘要:产线的每次改装都需要质检台来验证"变好了没有"。本节讲怎么建基准数据集、怎么用字符串距离、语义距离、裁判模型三类评估器给产出打分,以及 A/B 对比两种提示词版本的完整实验流程。
没有度量就没有改进
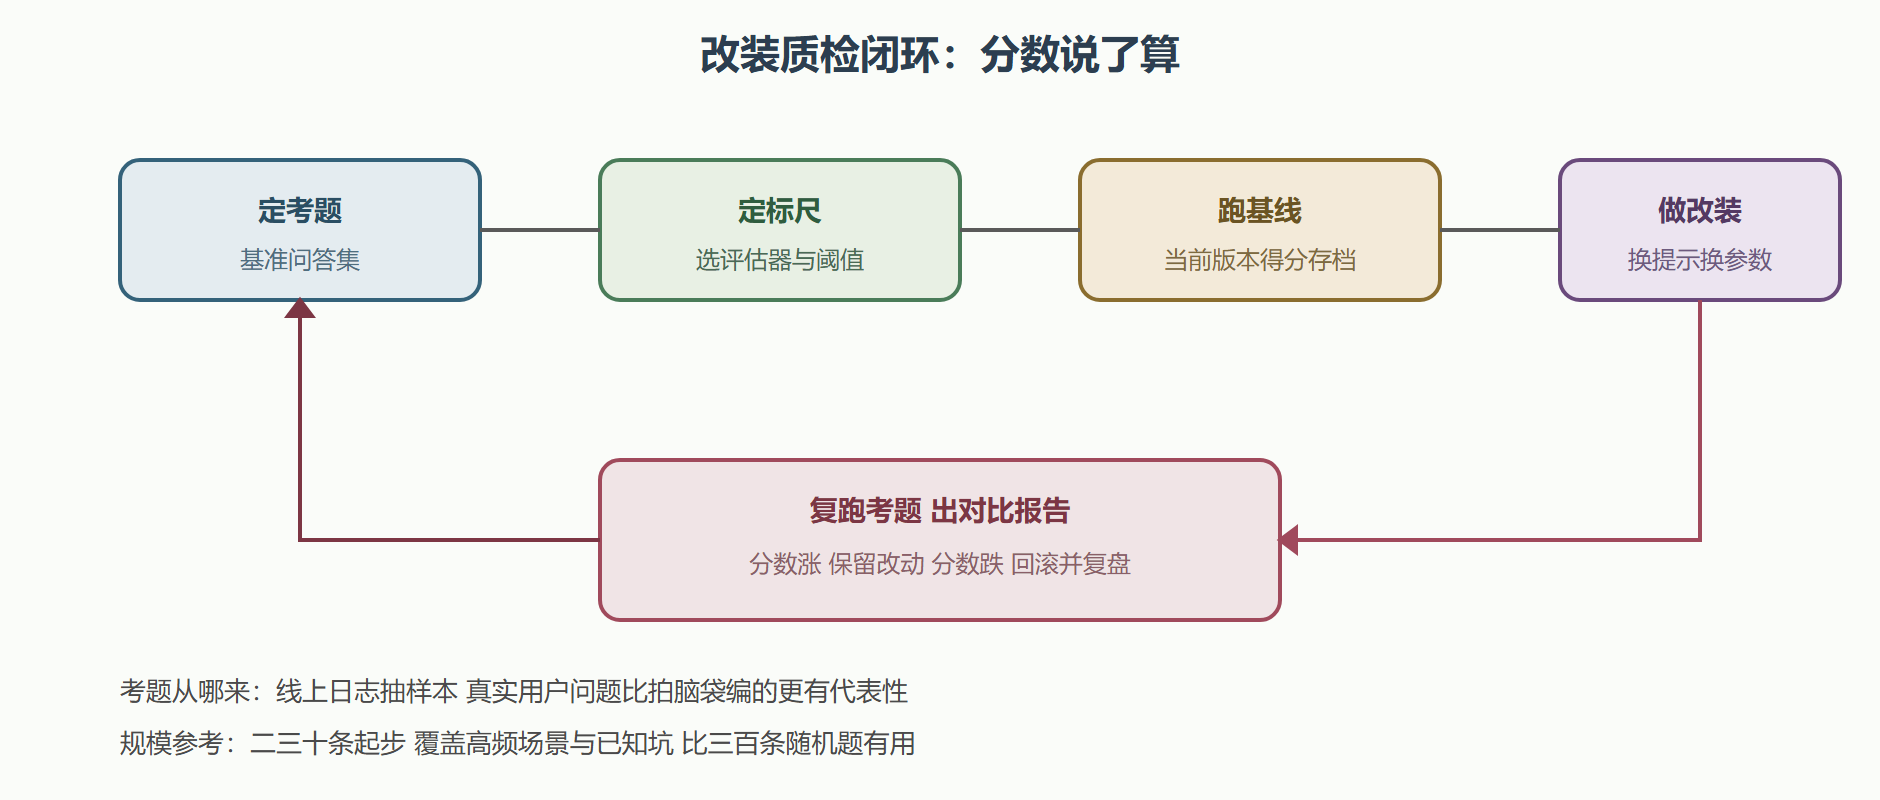
一个真实场景:运营说"回答不够专业",你把提示词里的"助手"改成"资深专家",感觉好了一点,上线后客诉反而多了。问题不在改动本身,而在"感觉"不可复现。评估要做的就是把这团感觉变成数字:固定一批考题、固定打分规则、每次改装后重跑一遍,分数涨了才算数。
质检闭环
三类标尺:从死板到灵活
标尺一:字符串距离。 答案是封闭集合(是、否、数字、固定词)时,机器对机器比较最可靠:
from langchain.evaluation import load_evaluator # 精确匹配评估器:全对才给 1 分 exact = load_evaluator("exact_match") print(exact.evaluate_strings( prediction="七天", reference="七天")) # 输出:{'score': 1} print(exact.evaluate_strings( prediction="7天", reference="七天")) # 输出:{'score': 0} # 字符串距离评估器:编辑距离越近分越高 dist = load_evaluator("string_distance") print(dist.evaluate_strings( prediction="支持七天无理由退货", reference="支持七天内无理由退货")["score"]) # 输出示例:0.8(接近但非全对)
标尺二:语义距离。 答案是自由文本但意思对即可时,比较向量距离:
# 语义相似度评估器:同义不同词也能得分 semantic = load_evaluator("embedding_distance") result = semantic.evaluate_strings( prediction="签收后七日内可申请退货", reference="收到货七天之内可以退") print(round(result["score"], 3)) # 输出示例:0.213(距离较小 语义相近)
标尺三:裁判模型。 最灵活的一档,让另一个模型按你定的规则打分,适合"专业性、语气是否合适"这类开放维度:
from langchain.evaluation import load_evaluator judge = load_evaluator( "labeled_criteria", criteria="相关性:回答是否紧扣问题且与参考答案一致") verdict = judge.evaluate_strings( input="袜子第一次洗要注意什么", prediction="建议冷水手洗,浮色属正常", reference="冷水手洗,避免暴晒") print(verdict["score"]) # 输出:1(裁判判定相关) print(verdict["reasoning"][:60]) # 输出示例:回答与参考答案核心信息一致……
跑一次完整的对比实验
把 2.8 节的检索问答链当被检品,给两个版本的提示词做 A/B:
from langchain_core.prompts import ChatPromptTemplate from langchain_core.output_parsers import StrOutputParser from langchain_openai import ChatOpenAI # 考题集:问题加标准答案 exam = [ ("袜子第一次洗要注意什么", "冷水手洗,浮色属正常"), ("定制款能退吗", "不支持退换"), ("怎么存放", "卷起收纳,避免橡筋拉伸"), ] def build_chain(system_text: str): # 版本差异只在系统提示这一行 prompt = ChatPromptTemplate.from_messages([ ("system", system_text), ("human", "{question}"), ]) return prompt | ChatOpenAI(temperature=0) | StrOutputParser() v1 = build_chain("你是客服助手,简洁回答") v2 = build_chain("你是资深客服,回答必须含具体天数或条件") def score(chain) -> float: total = 0 for q, ref in exam: ans = chain.invoke({"question": q}) total += semantic.evaluate_strings( prediction=ans, reference=ref)["score"] return total / len(exam) print("版本一平均语义距离:", round(score(v1), 3)) print("版本二平均语义距离:", round(score(v2), 3)) # 输出示例: # 版本一平均语义距离: 0.284 # 版本二平均语义距离: 0.226(距离更小 更贴近标准答案)
| 标尺 | 适用答案类型 | 成本 | 可信度 |
|---|---|---|---|
| 精确匹配与字符串距离 | 封闭集、格式化输出 | 零调用成本 | 最高 |
| 语义距离 | 自由文本、同义改写 | 每题一次嵌入 | 中高 |
| 裁判模型 | 开放维度、主观标准 | 每题一次模型调用 | 依赖提示质量 |
⚠️ 裁判模型的偏置要当心:它偏好长答案、偏好结构化排版,两条内容相同的回答可能因格式差出一截分。用裁判时把评分标准写得越机械越好,并定期人工抽查裁判的判断是否靠谱。
💡 评估集是资产不是耗材:每次线上事故沉淀两三条进考题集,半年后你就有一套"专属回归考卷"——新来的工程师改提示词前先跑一遍,比口头交接可靠十倍。
动手实验
给你的对话链建一个十题小考卷,分别用精确匹配与语义距离两把尺子跑分,再故意把温度从 0 调到 1 重跑一次,观察两把尺子各自捕捉到了什么变化。你会看到语义距离的分值波动明显小于用户体感的波动——这正是"单一指标必有盲区"的直观证据,所以实际项目里至少要两把尺子配合着看。下一节讲质检台的另一面:产线出了故障,仪表盘怎么用。
评论区
(0)
U