3.1 自制零件:自定义与扩展
3.1 自制零件:自定义与扩展
本节摘要:框架覆盖不到的能力,LangChain 留了三个标准接入口——自定义工具、自定义检索器、自定义链单元。本节讲三种零件的制造规范,以及"造零件"与"直接写函数"的分界线。
什么时候值得造零件
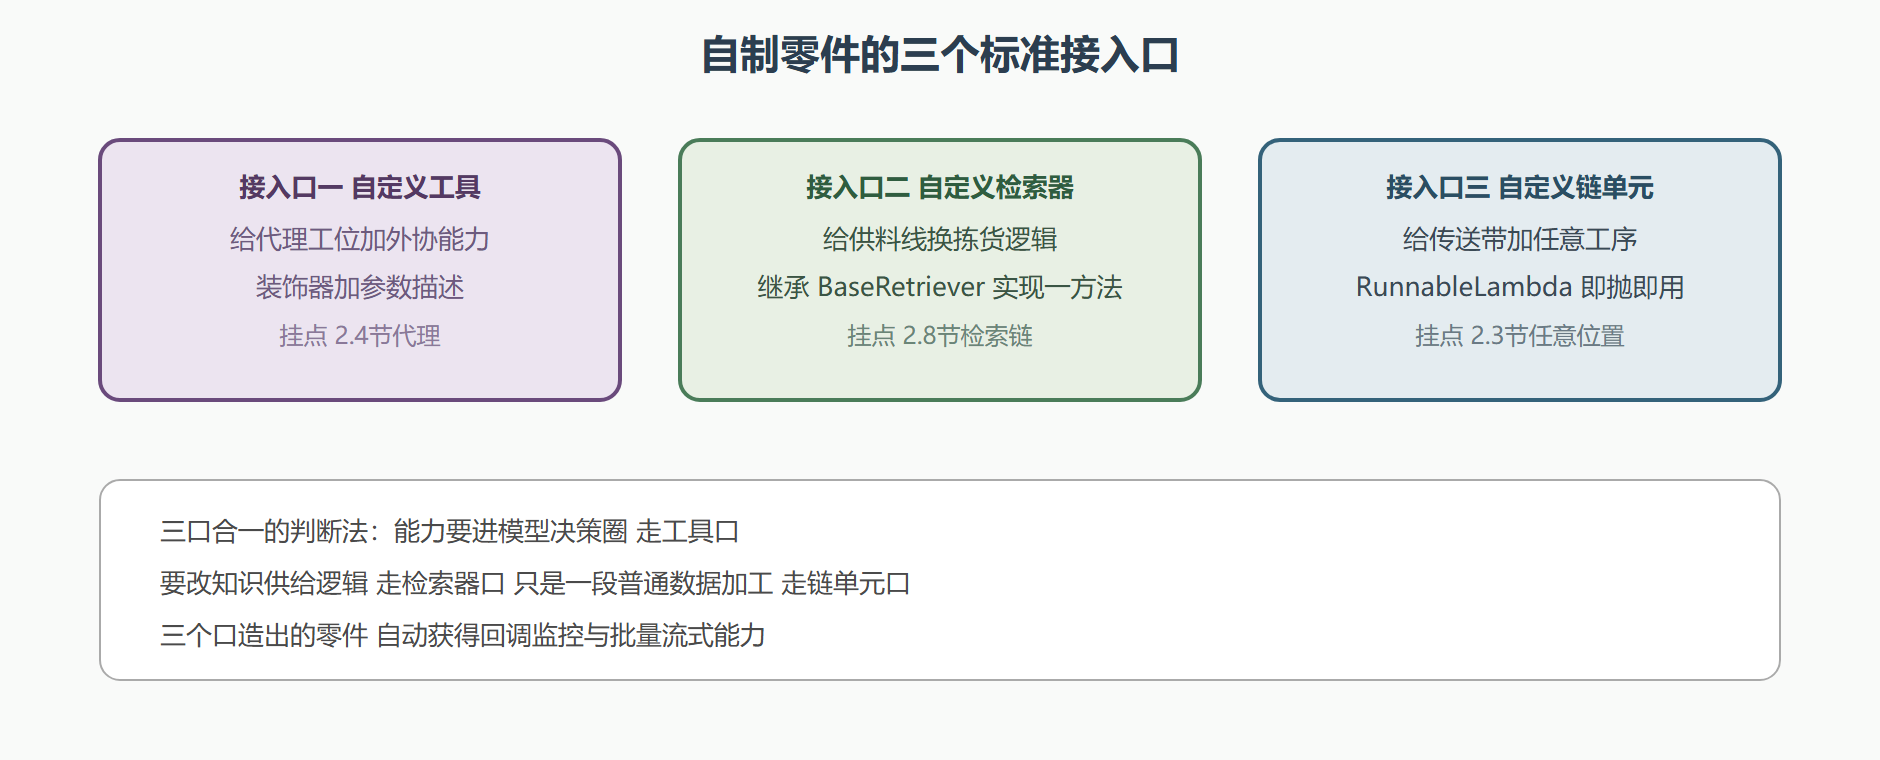
先回答成本问题。给产线加能力有两条路:直接在业务代码里写函数,或者按框架规范造一个标准零件。判断标准只有一条:这个能力是否需要被模型自主选用、被链自由组装、被回调监控到。三者有其一,就值得造成标准件;都 没有,普通函数就够。
三个标准接入口
接入口一:造一把像样的工具
2.4 节见过最简单的装饰器写法。进阶版要给参数加类型描述,模型选工具、填参数全靠这些说明:
from langchain_core.tools import tool from pydantic import BaseModel, Field class ExchangeArgs(BaseModel): """汇率查询的参数说明""" amount: float = Field(description="金额") currency: str = Field(description="目标币种代码,如 USD") @tool(args_schema=ExchangeArgs) def exchange_rate(amount: float, currency: str) -> str: """查询人民币兑换目标币种的金额。涉及价格换算时使用。""" # 演示用固定汇率,实际接行情接口 rates = {"USD": 0.14, "EUR": 0.13, "JPY": 21.0} r = rates.get(currency.upper()) if r is None: return f"暂不支持的币种:{currency}" return f"{amount} 元人民币约可兑换 {round(amount*r, 2)} {currency}" print(exchange_rate.invoke({"amount": 100, "currency": "USD"})) # 输出:100 元人民币约可兑换 14.0 USD print(exchange_rate.invoke({"amount": 100, "currency": "GBP"})) # 输出:暂不支持的币种:GBP
注意两处细节:返回的是字符串而非数字(工具返回要直接可读);不支持的输入返回明确提示而非抛异常(代理看到提示会换路走,看到异常只会停线)。
接入口二:造一台自定义检索器
当"拣货"不只是向量近邻——比如先查规则库再查向量库、或按业务权重混排——就自己造检索器。规范是继承 BaseRetriever 并实现一个方法:
from langchain_core.retrievers import BaseRetriever from langchain_core.documents import Document from langchain_core.callbacks import CallbackManagerForRetrieverRun class KeywordFirstRetriever(BaseRetriever): """先精确匹配关键词 命中不够再补语义近邻的混排检索器""" documents: list semantic: object # 底层语义检索器,由构造方传入 def _get_relevant_documents(self, query: str, *, run_manager=None) -> list[Document]: # 第一优先:关键词精确命中 exact = [d for d in self.documents if query in d.page_content] # 不足两块时用语义检索补齐 if len(exact) < 2: extra = self.semantic.invoke(query)[:2-len(exact)] exact.extend(extra) return exact docs = [Document(page_content="退货需在签收后七天内提出"), Document(page_content="定制款不支持退换"), Document(page_content="棉袜建议冷水手洗")] # 语义检索器用向量仓库转出(演示用关键词检索器代替底层) from langchain_core.retrievers import LambdaRetriever semantic = LambdaRetriever(lambda q: [ Document(page_content="换货需保留吊牌")]) retriever = KeywordFirstRetriever(documents=docs, semantic=semantic) print([d.page_content for d in retriever.invoke("退货")]) # 输出:['退货需在签收后七天内提出', '换货需保留吊牌']
造出来的检索器与内置件完全同权:能接进 2.8 节的检索链、能被回调监控、能批量调用。
接入口三:造一段链单元
轻量工序用 RunnableLambda 即抛即用(2.3 节已见)。要长成"正式零件"——带配置、带流式行为——就继承 Runnable 基类。判断题做敏感词过滤的例子:
from langchain_core.runnables import RunnableLambda class SafetyGate: """出口安检:命中敏感词的输出替换为固定话术""" def __init__(self, banned: list[str]): self.banned = banned def __call__(self, text: str) -> str: for word in self.banned: if word in text: return "该回答包含不适宜内容,已拦截。" return text gate = RunnableLambda(SafetyGate(["优惠券内部码"])) print(gate.invoke("回复:你的优惠券内部码是 X88")) # 输出:该回答包含不适宜内容,已拦截。 print(gate.invoke("回复:欢迎再次光临")) # 输出:回复:欢迎再次光临
这个安检门可以直接接在任意链的末端(chain | gate),3.5 节讲安全时它还会登场。
⚠️ 自制零件最常见的翻车:工具描述写成了给自己看的注释,而不是给模型看的说明书。"查汇率"不如"查询人民币兑换目标币种的金额,涉及价格换算时使用"——后者明确说了使用时机,模型才不会漏选错选。
💡 造零件前先翻内置库:框架与社区包里有几百个现成件(各云厂商工具、常见文档格式、主流向量库),确认确实没有再动手,通常能省一个下午。
本节要点回顾
- 造不造零件的判据:需要被模型选用、被链组装、被回调监控,三者有其一就造标准件;
- 三个接入口:工具给代理、检索器给供料线、链单元给传送带;
- 工具三军规:描述写使用时机、参数带类型说明、返回字符串且不轻易抛异常;
- 自制件与内置件同权:监控、批量、流式能力自动继承;
- 先查内置再动手,自制是最后的选择而非第一反应。
零件能自制了,下一节看怎么把整个外部工具库"整体外协"进来——成建制的第三方能力接入有另一套打法。