4.3 整车下线:部署与发布
4.3 整车下线:部署与发布
本节摘要:装配好的产线还躺在你的进程里,部署是把它变成"别人随时可调用的服务"的最后一道工序。本节讲下线前的四项准备(依赖锁定、配置分离、密钥注入、回归测试),三种交付形态的选型(常驻服务、框架自带服务化、容器化),以及上线后的监控与维护纪律。
从你的进程到别人的请求
4.2 节结束时,帮助台产线已经能答题,但它活在一个随时会被关闭的命令行窗口里。客服打开网页提问,你的进程却听不见——中间隔着一整个"交付层":接收网络请求、管理并发、加载一次产线服务多次、密钥与代码分离、出错时优雅降级。这些活儿与 LangChain 无关,却决定产线能不能真正下线。
下线前先想清楚四个问题,答案不同,交付形态完全不同:
- 谁来调用——内部脚本定时跑,还是真实用户的网页请求?
- 并发多大——一天几十次,还是高峰每秒几十次?
- 谁来运维——你自己兼着,还是有平台团队?
- 数据多敏感——能不能把问题文本发给第三方模型服务?
下线流程:从进程到服务
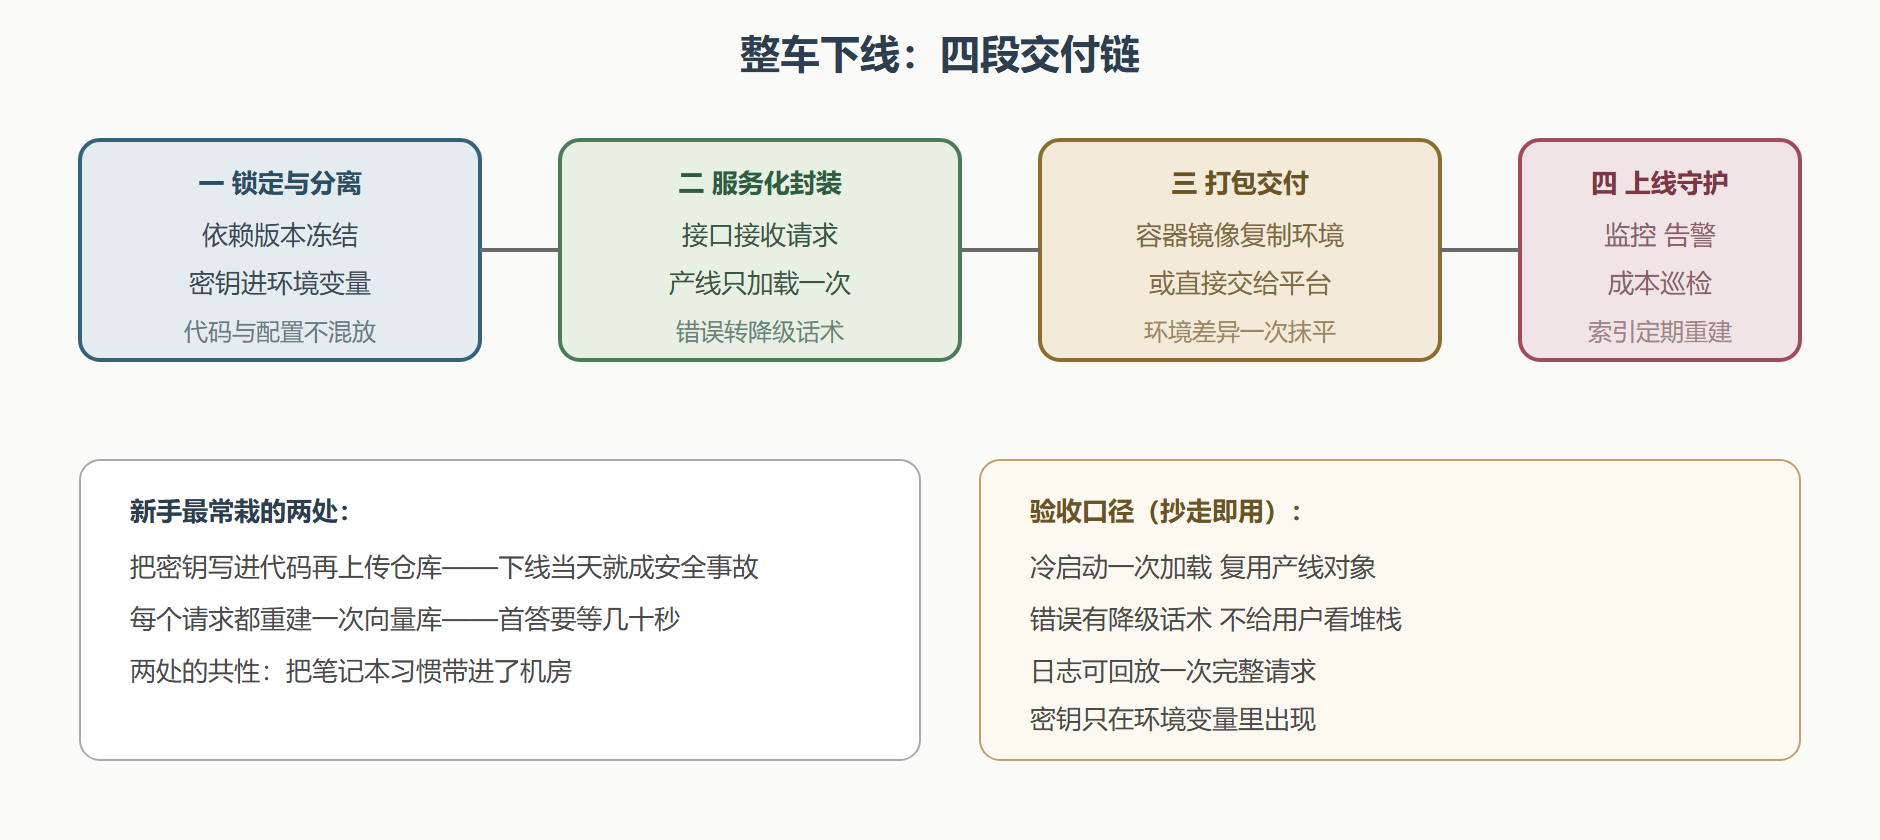
下线前的四项准备
准备一:依赖锁定。 LangChain 迭代快,依赖不锁版本,三个月后重装环境可能整个跑不起来。冻结依赖是机械动作:
# 开发环境确认无误后 冻结全部版本号 pip freeze > requirements.txt # 部署环境一条命令复现 pip install -r requirements.txt
冻结清单里重点看三行:langchain 主包、langchain-openai 等合作方分包、chromadb 之类存储引擎——这三处最容易出现"小版本跳变导致接口不兼容"。
准备二:配置与密钥分离。 代码进版本库,配置留在环境里,密钥走环境变量。模型名、温度、检索条数这类参数也建议抽成配置,改参数不动代码,回滚也只回滚配置:
import os # 密钥:只从环境变量读 代码里零硬编码 assert os.environ.get("OPENAI_API_KEY"), "缺少密钥环境变量" # 业务参数集中成一份配置字典 启动时打印确认口径 CONFIG = { "model": os.environ.get("HT_MODEL", "gpt-3.5-turbo"), "temperature": 0, "retriever_k": 3, "index_dir": os.environ.get("HT_INDEX", "kb_store"), } print("本次上线口径:", CONFIG) # 输出示例:本次上线口径:{'model': 'gpt-3.5-turbo', 'temperature': 0, # 'retriever_k': 3, 'index_dir': 'kb_store'}
准备三:回归测试。 4.2 节第五步那份二十题考卷,在这里原样复用——部署前的最后一道闸是"在部署环境重跑考卷,得分不低于验收线"。环境不同结果可能漂移,嵌入模型的版本、区域网络的差异都会搅动检索质量,不重跑一次就不算真部署。
准备四:降级预案。 模型服务超时、限流、余额耗尽,都是上线后的日常。给每个接口准备一句降级话术:"当前咨询人数较多,已为您转人工"——比抛一屏堆栈体面得多。
三种交付形态
| 形态 | 适合 | 代价 | 上手速度 |
|---|---|---|---|
| 脚本与定时任务 | 内部批处理、夜间汇总 | 几乎为零 | 最快 |
| 常驻接口服务 | 用户实时请求 | 需处理并发与守护 | 中 |
| 容器化交付 | 多环境部署、团队协作 | 需要镜像构建流程 | 稍慢但一劳永逸 |
形态二展开:把问答链封装成接口服务。 用 FastAPI 举例(Flask 同理),关键点是产线在进程启动时装配一次,请求进来只调用不重建:
from fastapi import FastAPI from langchain_openai import ChatOpenAI from langchain_core.prompts import ChatPromptTemplate from langchain_core.output_parsers import StrOutputParser from langchain_community.vectorstores import Chroma from langchain_openai import OpenAIEmbeddings from langchain_core.runnables import RunnablePassthrough app = FastAPI() # 冷启动段:进程起来时装配一次 常驻内存 retriever = Chroma(persist_directory="kb_store", embedding_function=OpenAIEmbeddings() ).as_retriever(search_kwargs={"k": 3}) def fmt(docs): return "\n".join(d.page_content for d in docs) prompt = ChatPromptTemplate.from_messages([ ("system", "你是品牌帮助台客服,只依据资料回答," "没有相关内容就建议联系人工客服。"), ("human", "资料:\n{ctx}\n\n问题:{q}"), ]) qa_chain = ({"ctx": retriever | fmt, "q": RunnablePassthrough()} | prompt | ChatOpenAI(temperature=0) | StrOutputParser()) # 请求段:每个请求只是一次调用 @app.get("/ask") def ask(q: str): try: return {"answer": qa_chain.invoke(q)} except Exception: # 降级话术:不把堆栈抛给用户 return {"answer": "当前咨询人数较多,已为您转人工客服。"} # 本地验证输出示例(访问 ask 接口 传入 q=定制款能退吗): # {"answer": "定制款不支持退换。"}
注意代码里的两个分层:冷启动段做重活(加载索引、装配链),请求段只做轻活(一次调用)。反过来写的服务,首个请求要等几十秒,用户早跑了。
形态二的捷径:框架自带的服务化方案。 LangChain 生态里有一个与 FastAPI 配套的组件,几行代码就能把链暴露成接口,还自动生成调用文档与调试页面:
# 依赖:框架的服务化组件 需与 FastAPI 一同安装 from fastapi import FastAPI from langserve import add_routes app = FastAPI(title="帮助台服务") # 一行暴露:自动生成调用与调试端点 add_routes(app, qa_chain, path="/ask") # 启动后即可网络调用 还附带可交互的调试页面
它适合快速原型与内部工具;对外正式服务仍建议自己写接口层——鉴权、限流、日志格式这些定制需求,早晚会逼你接管请求段。
形态三展开:容器化。 容器把"我机器上能跑"变成"哪都能跑",核心是一份构建清单:
FROM python:3.11-slim WORKDIR /app COPY requirements.txt . RUN pip install --no-cache-dir -r requirements.txt COPY . . CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", 8000]
清单逻辑与装配线同构:先装地基(基础镜像),再锁零件(按冻结清单装依赖),最后总装(拷贝代码、定义启动命令)。两个实践要点:密钥绝不写进镜像,运行时以环境变量注入;向量库这类大文件不进镜像,挂载外部目录或启动时从对象存储拉取,镜像体积能小一个数量级。
上线之后:守护比部署更长
部署完成只是下线,守护才刚开始。三件事排进日程:
其一,监控。 3.4 节的回调日志原样搬进服务,记录每条请求的耗时、检索命中数、token 消耗;再配一个追踪平台把链路可视化,故障时能看到"慢在检索还是慢在模型"。其二,成本巡检。 每周看一眼 token 报表,异常尖峰多半对应着某类超长输入或缓存失效。其三,索引重建纪律。 4.2 节末尾提过的坑在此落地:手册一更新就触发重建流程,重建后重跑考卷,达标再切换。
⚠️ 上线头一周别急着优化。先攒数据:哪些问题答错了、延迟分布什么样、成本花在哪。带着真实数据做的第一轮优化,比凭感觉改参数有效十倍——这也是 3.3 节评估思维在运维侧的延续。
💡 判断一个部署方案好坏的土办法:让一位没参与开发的同事,只凭你留的说明文档,在一台干净机器上把服务跑起来。跑得起来,交付就合格;卡在三处以上,说明你的"环境假设"太多,容器化该提上日程了。
产线下线,本教程的主线到此走完。但车间之外还有整条产业带:框架的生态版图、演进方向、学习资源与参与路径——最后一章带你看厂房外面的世界。